
AdaTTA:拒绝“一刀切”,为每个推荐序列量身定制增强策略
Beyond One-Size-Fits-All: Adaptive Test-Time Augmentation for Sequential Recommendation
本文提出了 AdaTTA,一种针对序列推荐系统(Sequential Recommendation)的即插即用式自适应测试时增强(Test-Time Augmentation, TTA)框架。该方法利用强化学习(Reinforcement Learning)为每个用户序列动态选择最优的增强算子,显著提升了模型在推理阶段的准确性。
TL;DR
在序列推荐(Sequential Recommendation)中,数据稀疏性一直是制约模型性能的顽疾。传统的测试时增强(TTA)虽然能作为“免费的午餐”提升精度,但固定不变的增强手段往往无法适配所有用户。AdaTTA 突破了这一限制,通过 强化学习(RL) 赋予了推荐系统在推理瞬间“随机应变”的能力,大幅提升了 SOTA 表现。
背景定位:本项目属于推断侧增强(Inference-time Enhancement)技术,是对现有 SASRec、GRU4Rec 等序列模型的即插即用式升级。
痛点深挖:为什么“一刀切”的增强行不通?
在工业界,重新训练一个大规模推荐模型代价极高。TTA(测试时增强)通过在推理时对输入序列进行微小的扰动(如 Mask 掉一个商品或加入噪声),生成多个预测结果并聚合,从而提高鲁棒性。
然而,作者通过实证研究(Empirical Study)发现了一个被长期忽视的问题:序列特征决定了增强的有效性。
- 长序列:可能更喜欢
Insert(插入)操作来引入相关干扰。 - 短序列:可能对
TMask-R(移除式掩码)更敏感。 - 行为模式:某些用户行为逻辑性极强,打乱顺序(Reorder)会严重破坏语义;而某些用户行为随机性大,加入噪声(TNoise)反而能过滤冗余信息。
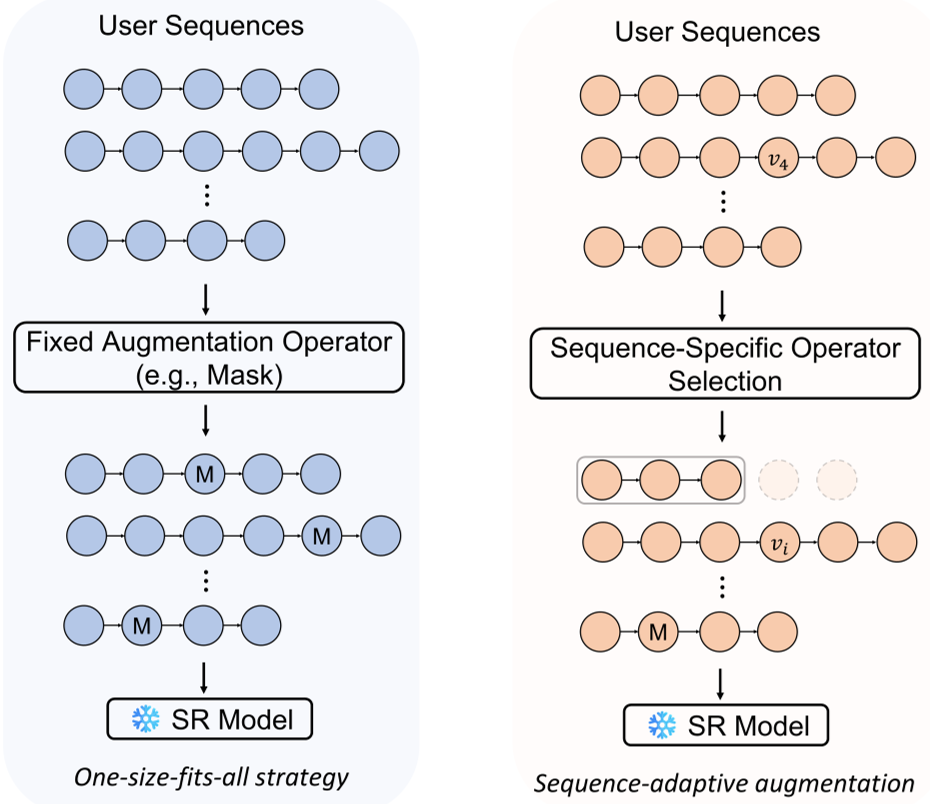
核心机制:AdaTTA 的 RL 进化论
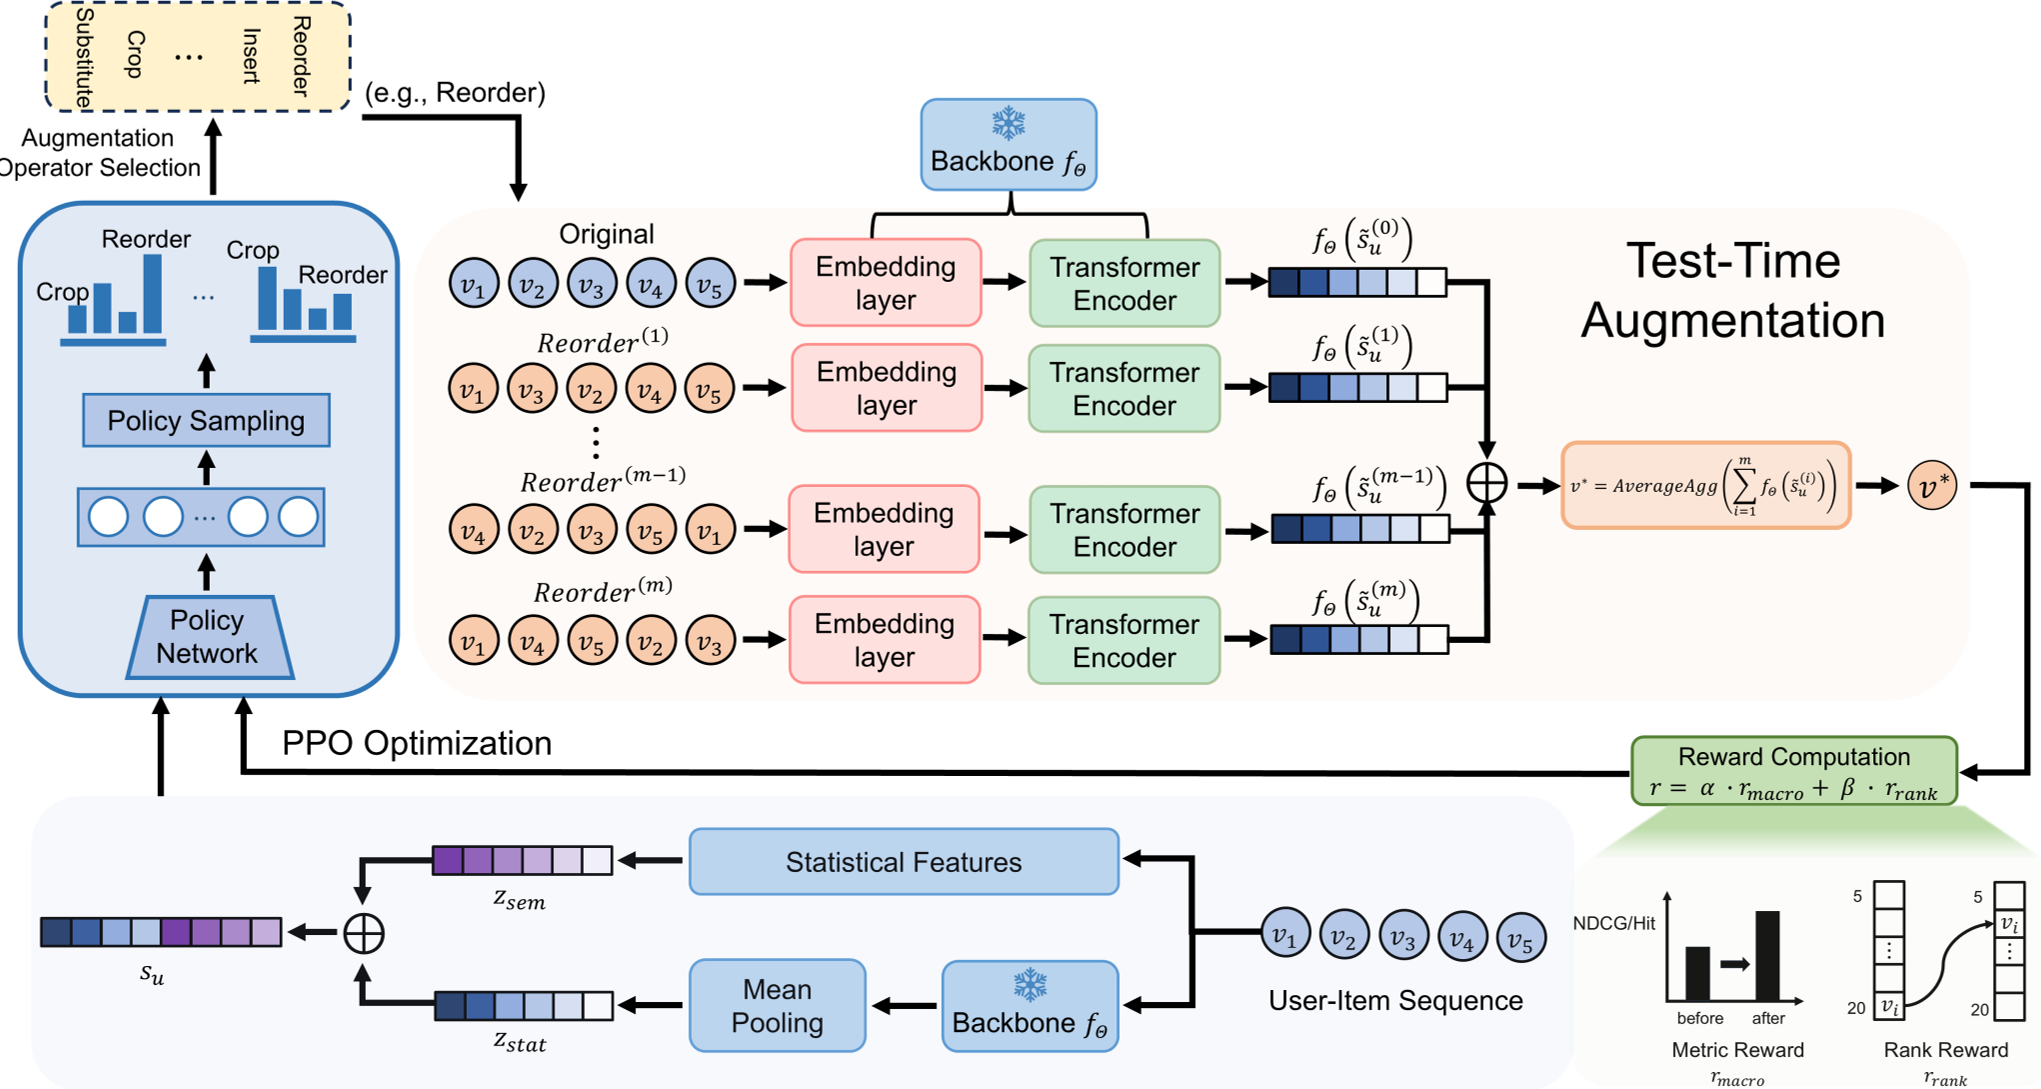
为了实现“千人千面”的增强,AdaTTA 引入了 Actor-Critic 强化学习框架。
1. 混合状态表示 (Multi-View State Representation)
策略网络不能只看序列的 Embedding。AdaTTA 同时提取了两类信息:
- 语义视图 (Semantic):通过预训练模型提取的隐藏层表示,代表“用户喜欢什么”。
- 统计视图 (Statistical):包括序列长度、交互多样性、噪声水平等,代表“序列结构长什么样”。
2. 联合奖励机制 (Joint Macro-Rank Reward)
这是 AdaTTA 能在排名任务中胜出的关键。它不仅关注最终的 Hit Ratio 是否提升(Macro Reward),更引入了 Rank Reward:
- 即便目标商品没进 Top-10,如果增强后它的排名从第 100 位上升到了第 20 位,RL 也能感知到这种正向改进。这种细粒度的信号极大地缓解了奖励稀疏问题。
实验战绩:全线飘红
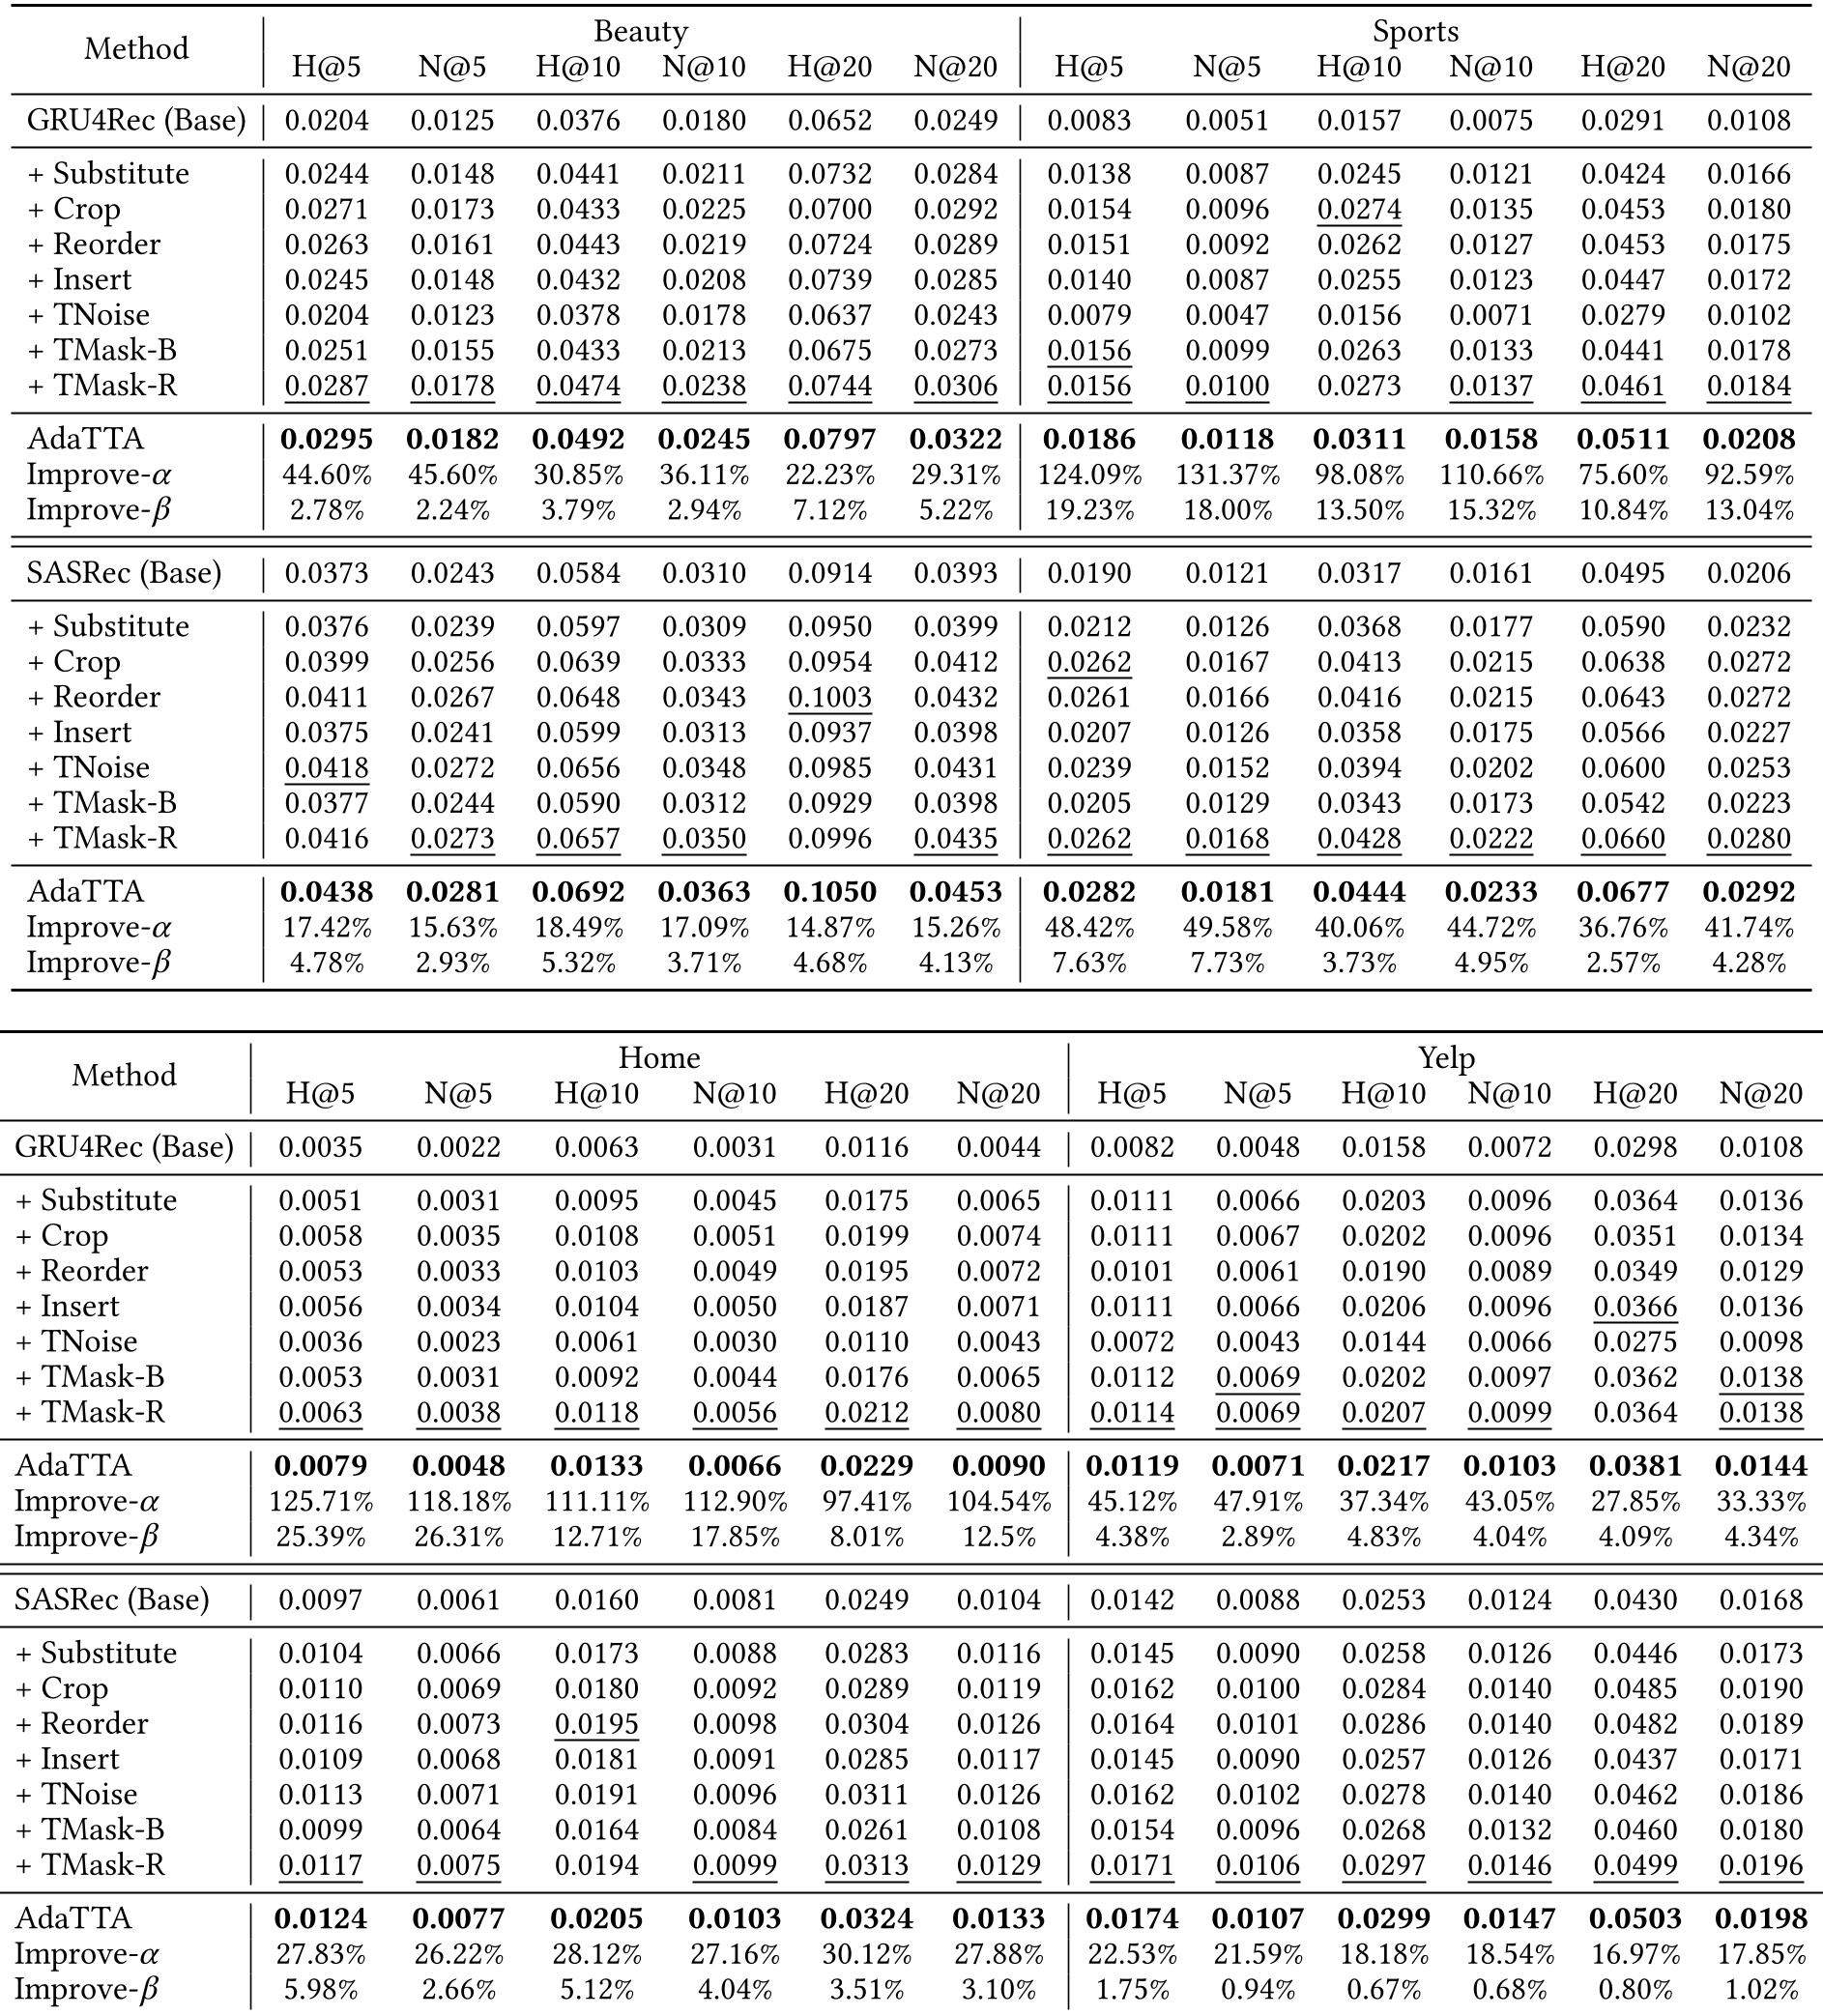
作者在 Beauty, Sports, Home, Yelp 四个真实世界数据集上进行了测试,对比了包括 Substitute, Crop, Mask, TNoise 等在内的 8 种固定 TTA 算子。
- 性能暴涨:在 SASRec 和 GRU4Rec 两种主流架构上,AdaTTA 均稳定超过了最强的固定 TTA 算子。特别是在稀疏的 Home 数据集上,相比基础模型(Base),性能提升达到了惊人的 125% 以上。
- 自适应优势:实验证明,没有任何一种固定算子能在所有数据集上称王,而 AdaTTA 凭借 RL 自动捕捉到了每个数据集特有的“增强偏好”。
深度洞察:效率与价值的博弈
AdaTTA 引入了额外的策略网络计算,这是否会导致推理太慢? 根据实验数据(Table 8),AdaTTA 的推理时间约为固定增强方法的 1.05x ~ 1.6x。考虑到其在排序质量上的巨大涨幅,这种毫秒级的延迟在大多数非极端实时场景下是完全可以接受的“高性价比”交换。
局限性分析: 虽然 AdaTTA 实现了算子级的自适应选择,但单次增强中的超参数(例如 Crop 的比例)仍是预设的。未来如果能将增强的“程度(Intensity)”也纳入 RL 的决策空间,可能会挖掘出更高的潜力。
总结
AdaTTA 成功证明了:在序列推荐中,“如何增强”比“是否增强”更重要。通过将推理阶段的静态计算转为动态决策,该框架为处理推荐系统中的行为异构性提供了一个优雅且高效的视角。