
AIFIND:用语义锚点锁定特征空间,攻克增量人脸伪造检测的遗忘难题
AIFIND: Artifact-Aware Interpreting Fine-Grained Alignment for Incremental Face Forgery Detection
本文提出了 AIFIND,一种用于增量人脸伪造检测(IFFD)的创新框架。该方法通过构建“伪造伪影语义锚点(Semantic Anchors)”,实现了无需数据重放(Replay-free)的持续学习,在多个增量检测基准测试中达到了 SOTA 性能。
TL;DR
针对人脸伪造检测中“换脸算法更新快、模型旧知识丢得快”的痛点,哈尔滨工业大学的研究团队提出了 AIFIND。该方法抛弃了传统的“存旧样本(Data Replay)”策略,创新性地利用 语义锚点(Semantic Anchors) 作为视觉特征的“定海神针”,在实现 零重放 的同时,大幅提升了模型对新老伪造类型的检测精度。
背景:为何增量学习在人脸防伪中如此困难?
在人脸伪造领域,新的攻击技术(如 Diffusion-based 为代表的新型合成)日新月异。如果每次出现新攻击都重新训练模型,成本极高。增量学习(Incremental Learning) 本应是理想选择,但现有方法面临两大症结:
- 特征漂移(Feature Drift):传统的二元分类(真/假)监督太粗糙,模型只记住了某个数据集的“风格”,换个环境特征分布就失控了。
- 灾难性遗忘:为了记住新手法,模型会覆盖掉旧知识的神经元权重。
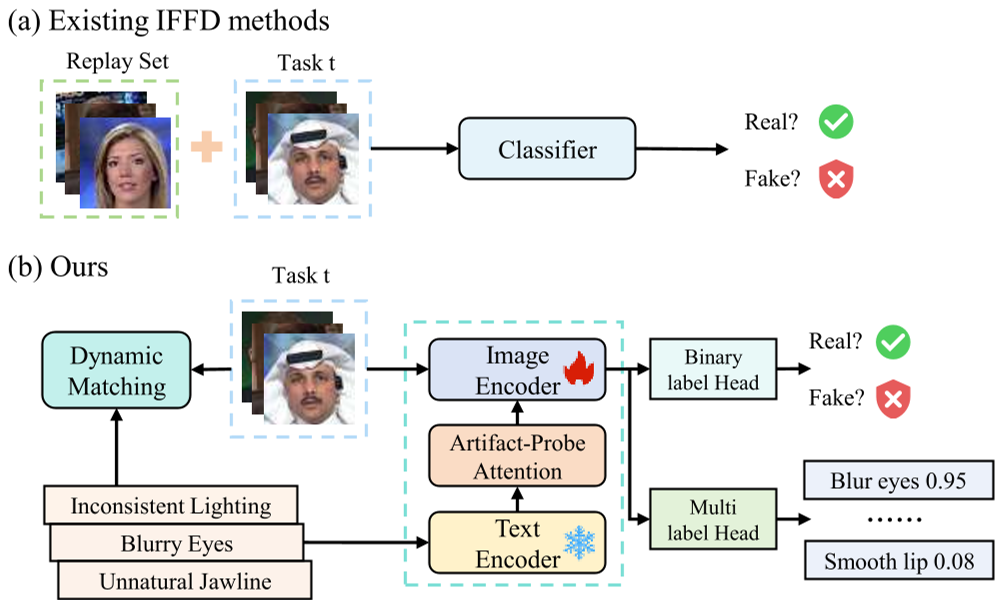
核心直觉:语言是永恒的锚点
作者发现:虽然伪造的视觉表现(Visual Manifold)在变,但描述伪造的 语义概念 是相对稳定的。例如,“眼睛周围有模糊”、“边界处有不自然的连接”这些语义描述在不同算法中是通用的。AIFIND 的核心思想就是:将不稳定的视觉特征强制对齐到稳定的语义锚点上。
技术拆解:AIFIND 的四大核心组件
1. 语义先验生成器 (ASPG)
模型首先分析低级伪影(Blur, Color, Structure, Texture, Boundary),利用大模型(LLM)将这些量化的统计异常转化为文本描述,构建成一个“语义锚点库”。
2. 伪影探针注意力 (Artifact-Probe Attention, APA)
这是视觉与语义融合的关键。APA 模块允许视觉 Token 作为 Query 去“寻找”对应的语义锚点(Key/Value)。通过这种交叉注意力机制,模型在提取特征时会受到语义的明确约束。
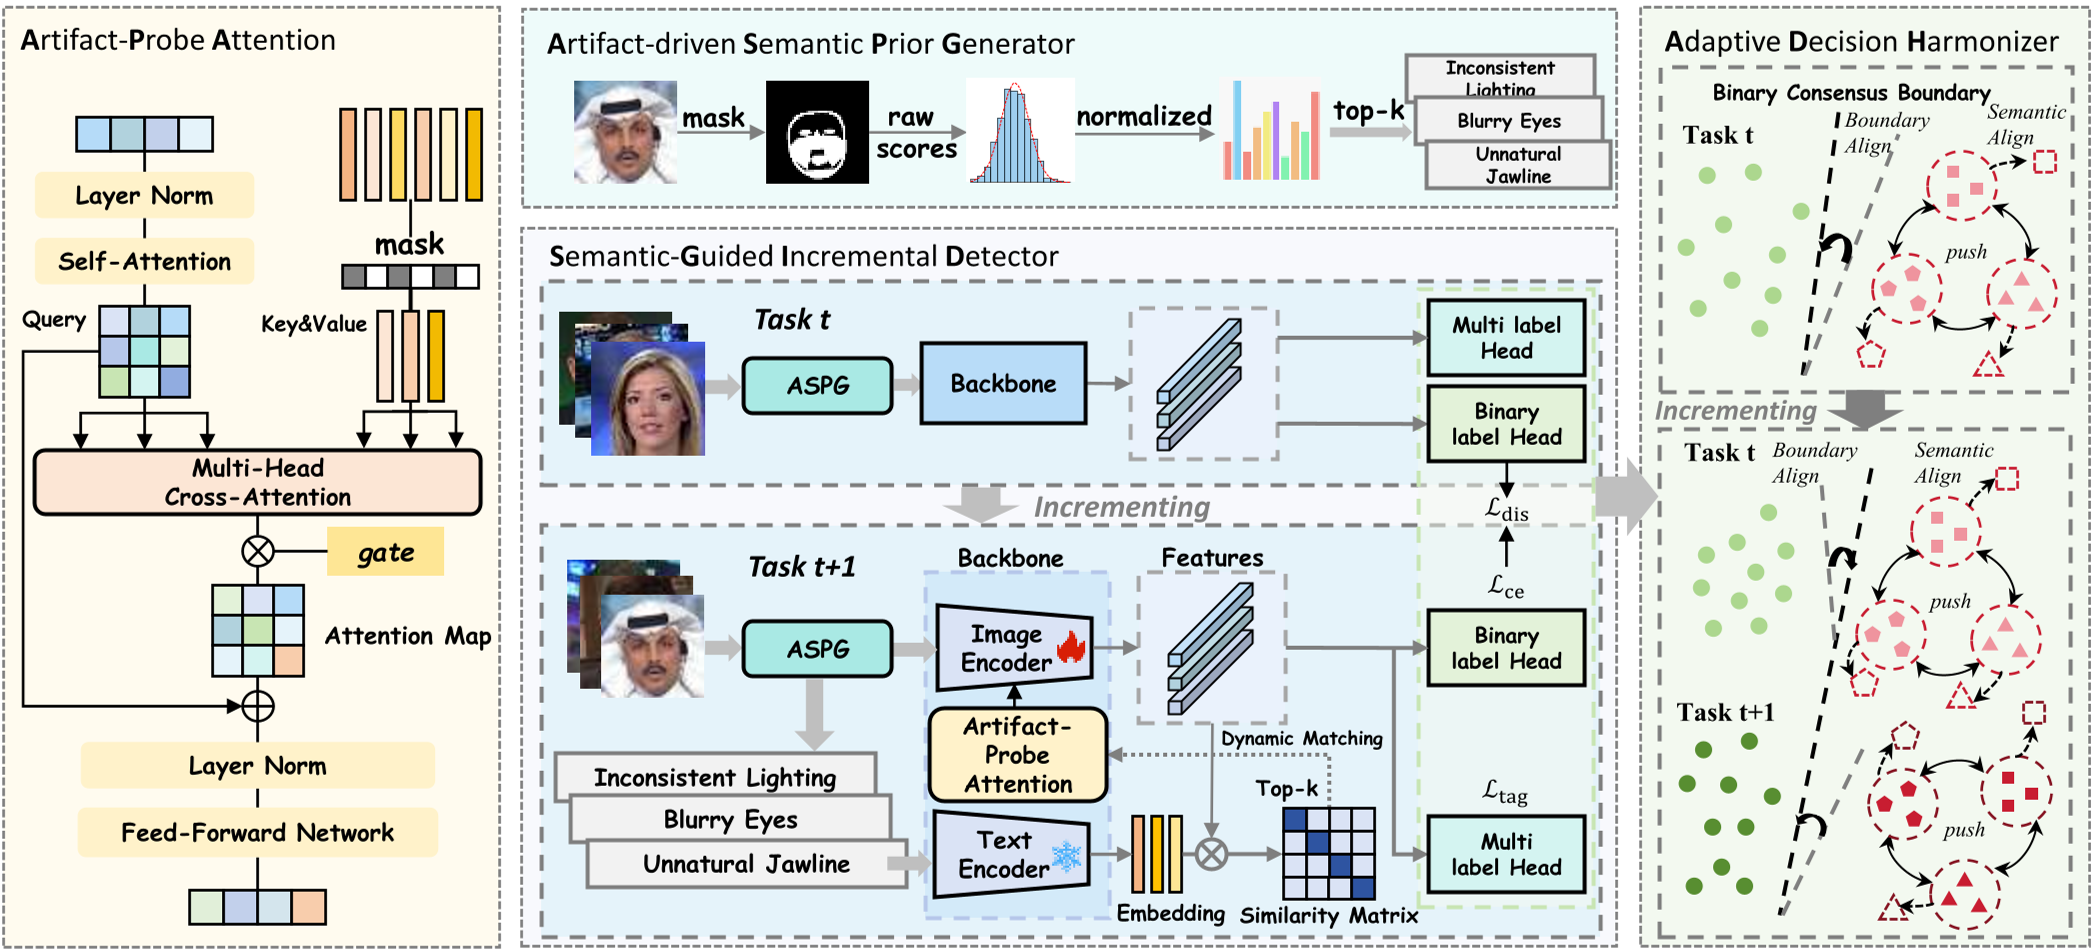
3. 多任务双重监督
模型不仅要猜“真假”(Global Classification),还要预测具体存在哪种“伪影”(Artifact Prediction)。这种细粒度的任务设计迫使模型学习具有解释性的特征。
4. 自适应决策协调器 (ADH)
这是解决分类器漂移的杀手锏。当新任务到来时,ADH 不直接在欧几里得空间更新权重,而是在 球面流形(Spherical Manifold) 上进行旋转对齐,确保新老任务的决策边界在几何上具有一致性。
实验战绩
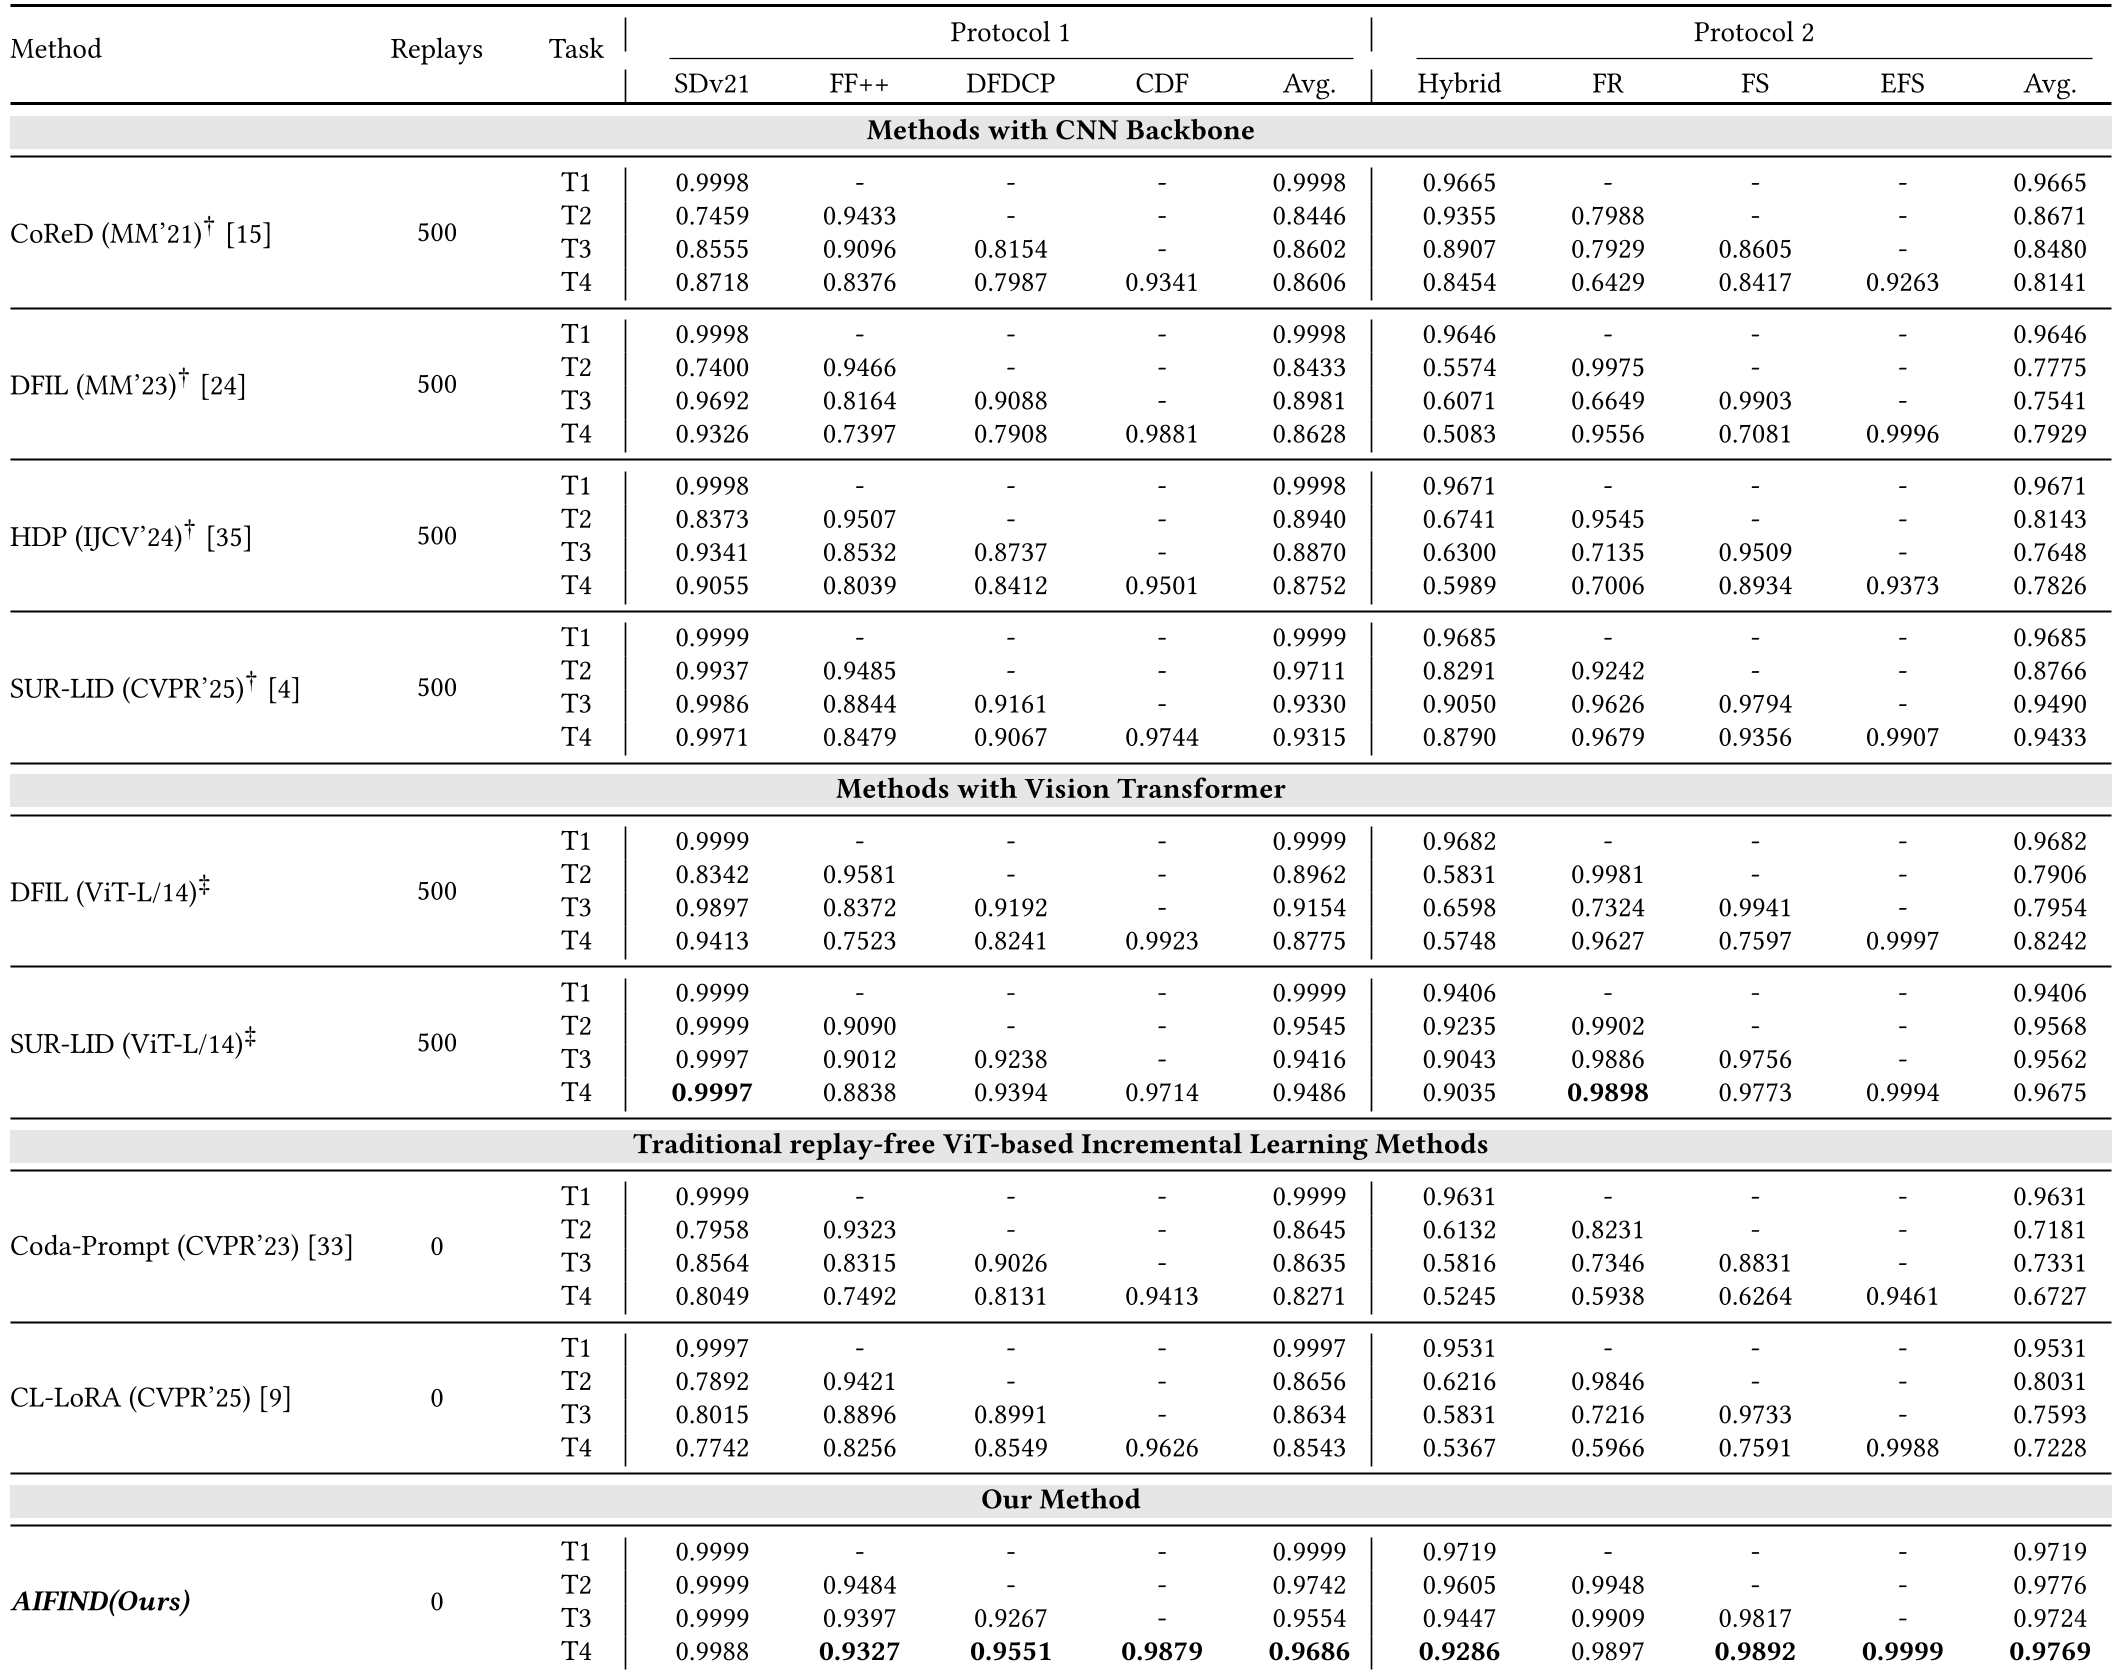
在 Protocol 1(数据集增量)和 Protocol 2(伪造类型增量)中,AIFIND 均取得了压倒性优势:
- 无需数据重放:在不存储任何历史样本的情况下,平均 AUC 依然超过了需要 500 个重放样本的最强基线 SUR-LID。
- 极强的泛化性:在完全未见过的基准(如 FakeAVCeleb)上,AIFIND 依然能保持高识别率,证明了其学习到的是本质的“防伪特征”而非“数据噪声”。
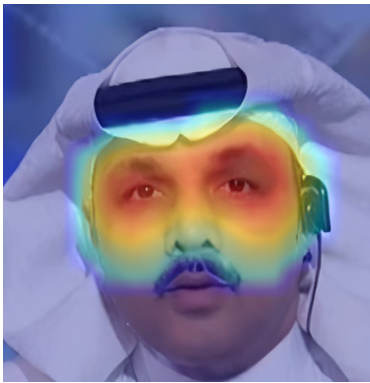
可视化分析:模型真的懂了吗?
通过 Grad-CAM 可视化(见下图),可以看到 AIFIND 的注意力非常集中在眼睛、嘴巴等易受攻击的关键区域。而且这种注意力与预测的伪影类型高度匹配——当热力图亮起眼睛区域时,对应的“眼睛伪影”分类得分也同步飙升。这证明了 AIFIND 具有极佳的 空间-语义一致性(Spatial-Semantic Consistency)。
总结与洞察
AIFIND 的成功在于它跳出了单纯追求像素级区分的怪圈,引入了 视觉-语言对齐 的范式来稳定增量学习过程。它不仅在技术上解决了“遗忘”问题,更在可解释性上迈进了一大步。对于未来的防伪研究,这种基于“语义锚点”的架构可能成为对抗“生成式AI爆发”的有力武器。
局限性:目前语义锚点仍部分依赖预定义的物理伪影,未来如果能结合更强大的 Multimodal LLM 进行自动化发现,其上限将不可估量。