
AIF:让 VLM 学会“选择性忽视”,突破“视而不见”的感知瓶颈
Aligning What Vision-Language Models See and Perceive with Adaptive Information Flow
本文提出了 Adaptive Information Flow (AIF),一种改进多模态大模型(VLM)感知能力的训练推理阶段(Test-time)优化方法。通过动态调节 Causal Mask 来阻断文本对无关视觉 Token 的注意力,显著提升了 LLaVA-1.5 和 Qwen2.5-VL 在 VQA 和视觉定位等任务中的精度。
TL;DR
多模态大模型(VLM)经常陷入一个怪圈:它们在注意力图中明明标出了物体,回答时却胡言乱语。本文提出的 Adaptive Information Flow (AIF) 揭示了核心原因——信息流失调。作者通过一种无需训练的方法,在推理时动态“关掉”那些无关视觉 Token 对文本的影响,让模型专注于真正重要的区域。实验表明,这种方法在几乎不增加算力的情况下,显著提升了 LLaVA 和 Qwen 等主流模型的感知精度。
1. 痛点:看得见,却“理解”错
最近的学术研究(如 BLINK)发现 VLM 有个尴尬的现状:“Seeing but not perceiving”。即使模型能准确地定位到物体(Grounding 成功),它也可能在问答中失败。
作者的 Insight:这是因为在解码阶段,文本 Token 的注意力被大量无关的背景视觉 Token “稀释”或“干扰”了。这种空间分散的注意力模式将噪声引入了推理路径,直接导致了幻觉。
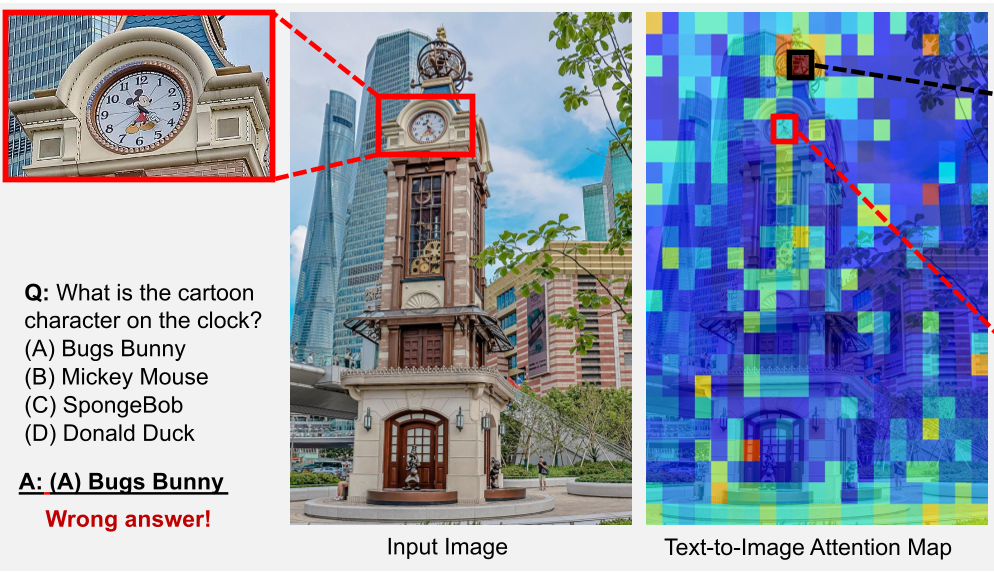 图 1:(a) 标准 VLM 注意力过于分散;(c) AIF 调制后的信息流专注于核心区域。
2. 核心机理:Token Dynamics 与 熵
既然并非所有视觉 Token 都有贡献,那如何筛选?作者提出了 Token Dynamics(Token 动态) 的概念:
- 观察:在 LLM 的不同层中,对应重要物体的视觉 Token 会表现出独特的、稳定的激活模式;而背景区域的激活则呈现出极高的不确定性和随机性。
- 熵作为度量:利用信息熵(Entropy)来量化这种随机性。熵越高,意味着该 Token 越可能是干扰项(Irrelevant)。
- 动态遮蔽 (Adaptive Masking):计算出 Token 熵图后,系统会自动寻找一个最优阈值,在推理所需的 Causal Mask 中阻断文本 Token 到高熵视觉 Token 的路径。
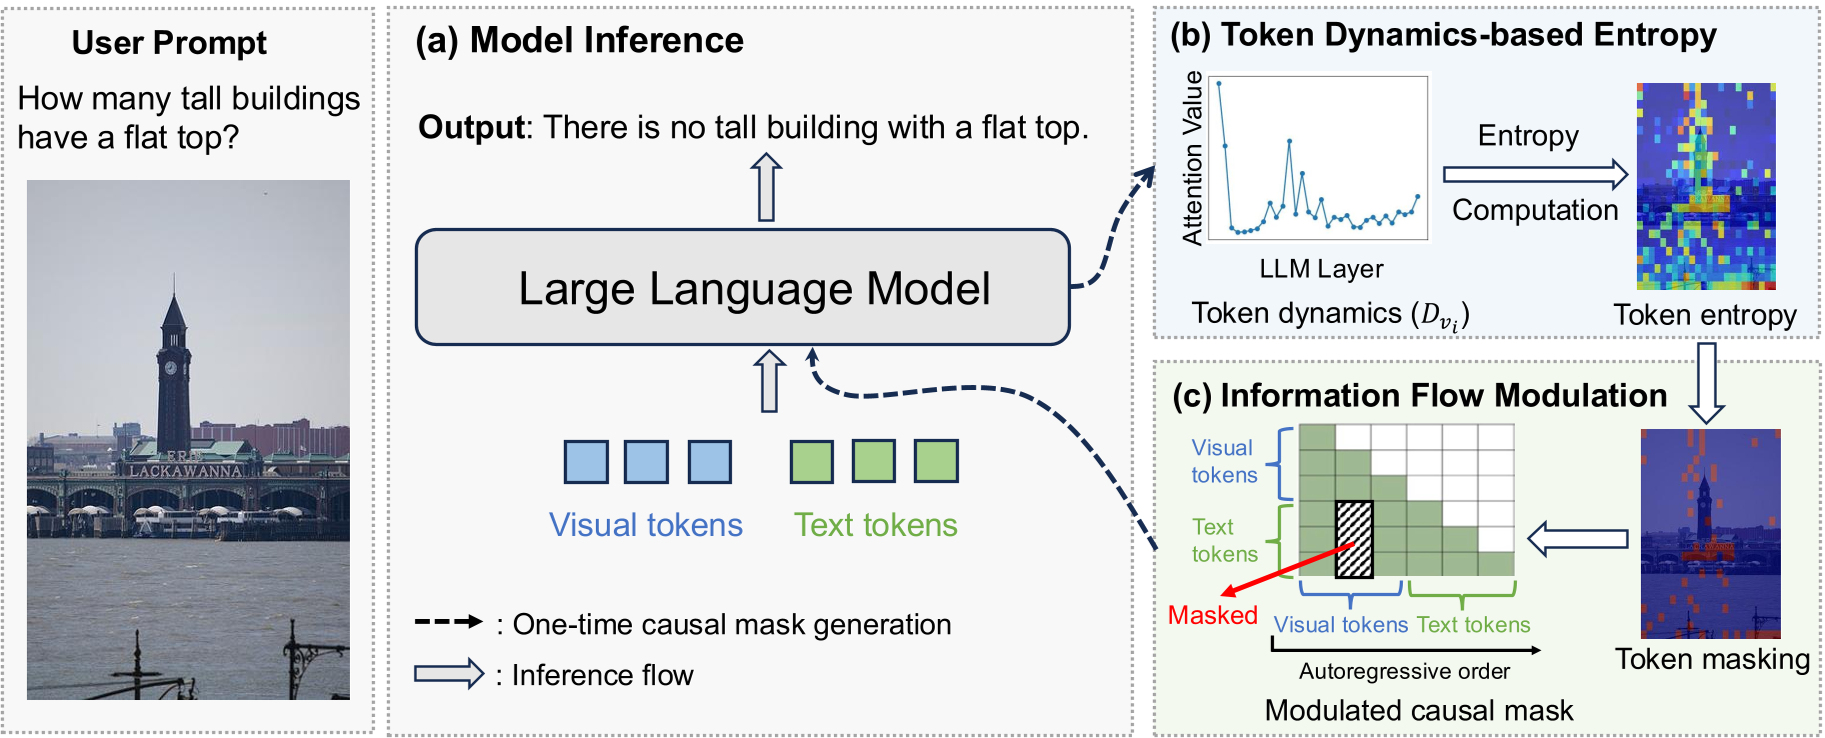 图 2:AIF 整体架构,从 Token Dynamics 到最终的 Causal Mask 生成。
与传统的 Token Pruning(剪枝) 不同,AIF 并不物理删除 Token,而是通过 Mask 调节信息流。这意味着视觉 Token 之间仍然可以相互通信(保持图像上下文完整),只是不让坏 Token 误导文本。
3. 实验战绩:全线飘红
作者在 LLaVA-1.5 和最新的 Qwen2.5-VL 上进行了广泛测试,结果令人印象深刻:
- 泛化问答 (VQA):在 MMStar 榜单上,Qwen2.5-VL-7B 的表现提升了 7.0%。
- 视觉定位 (Grounding):在 RefCOCO 系列任务上,即使不加专门的 Head,定位精度也提升了 2.3%,甚至超过了专门的检测模型 Grounding-DINO。
- 解决幻觉问题:在 POPE 数据集上,LLaVA-1.5 的准确率从 85.4% 提升至 88.7%。
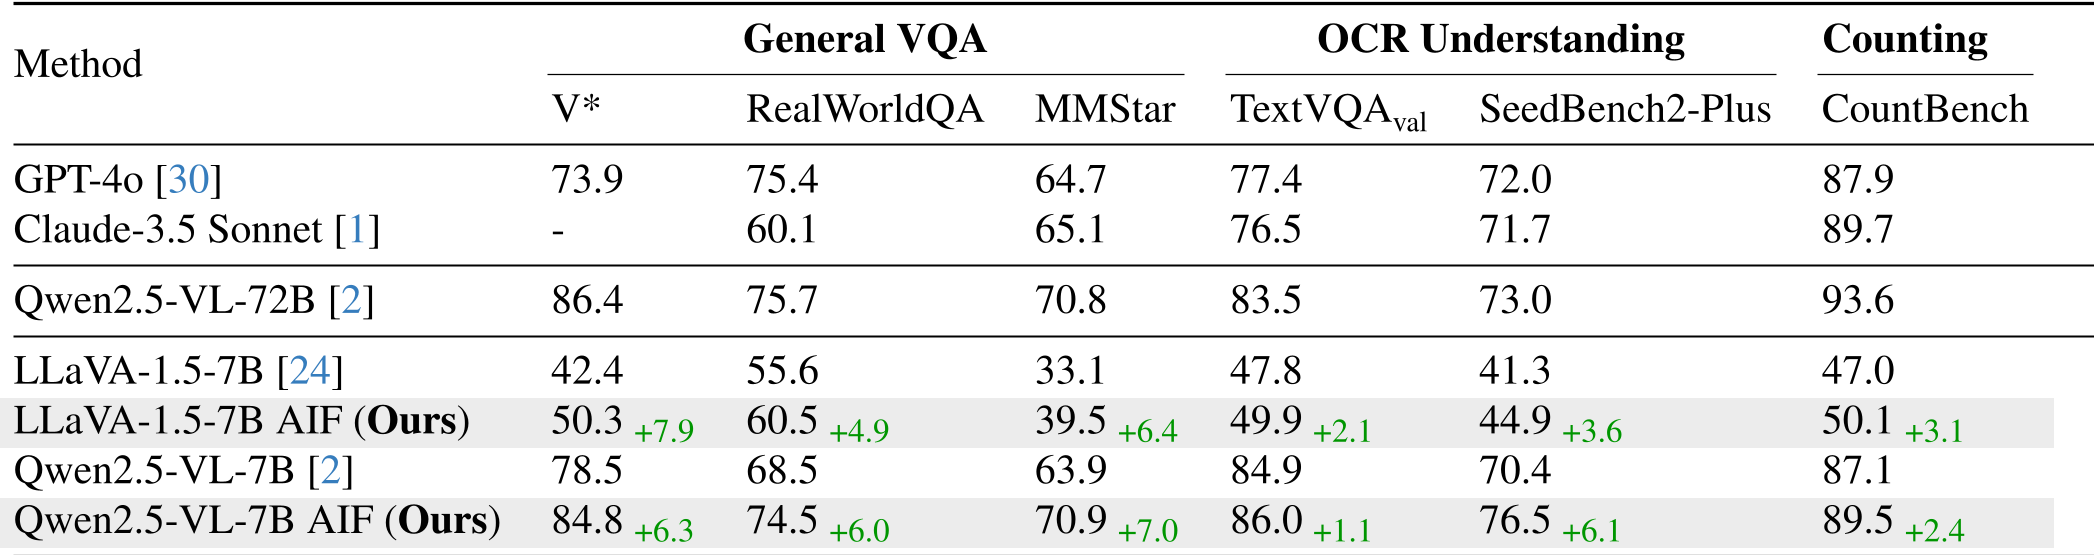 表 1:在各个主流基准测试上的性能提升。
4. 深度洞察:为什么 Mask 比 Pruning 更强?
消融实验(Ablation Study)给出了几个有趣的结论:
- 熵优于注意力值:简单地选择高注意力 Token(High-Attention tokens)效果并不好,因为许多噪声 Token 也会有瞬间的高激活。而基于熵的 Low-Entropy 选择法捕获重要物体的召回率(Recall)提升了 10%-20%。
- 推理成本极低:虽然增加了一个前置的 Decoding 步骤,但总耗时仅相当于多生成 1 个 Token,这在处理长文本回答时几乎可以忽略不计。
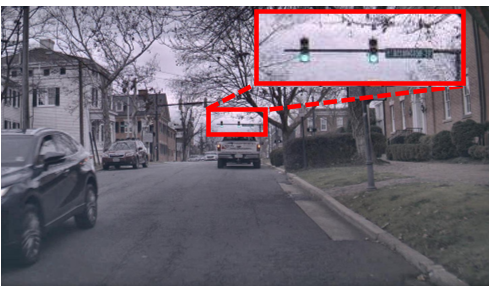 图 3:可以看到被红色标记的 Masked tokens 大多是墙壁、背景等无关区域。
5. 总结与反思
AIF (Adaptive Information Flow) 为我们提供了一个全新的视角:模型性能不仅仅取决于它学到了什么(Weights),还取决于我们在推理时允许信息如何流动(Connectivity)。
局限性:作者也坦诚指出,如果用户提示词(Prompt)过于间接或冗长,模型可能很难在第一步准确捕获哪些是“重要”区域。此外,该方法目前主要针对单步注意力统计,如何结合更复杂的多轮对话动态仍有待探索。
总结:对于希望在不重训模型的情况下压榨 VLM 感知极限的开发者来说,AIF 这种通过简单修改 Mask 矩阵就能起效的方法,无疑具有极高的实战价值。