
ArtifactNet:倾听 AI 音乐中“消失的物理”—— 400 万参数击败大模型取证
ArtifactNet: Detecting AI-Generated Music via Forensic Residual Physics
本文提出了 ArtifactNet,这是一个轻量级的 AI 生成音乐检测框架,通过“刑事物理 (Forensic Physics)”视角,利用 4.0M 参数的模型提取神经音频编解码器(Neural Audio Codecs)留下的物理伪影。该方法在包含 22 种生成器的 ArtifactBench 评估中达到了 F1=0.9829 的 SOTA 性能,显著优于传统的表示学习方法。
TL;DR
随着 Suno、Udio 等 AI 音乐生成器的爆发,如何精准识别 AI 音乐成为版权与内容工业的急迫需求。传统方法靠“背诵”AI 音乐的风格,一遇到新模型就失灵。本文提出的 ArtifactNet 另辟蹊径,不学风格,只抓物理规律。它发现 AI 必须经过的“神经编解码器”会留下独特的物理“指纹”,仅凭 4.0M 的微型架构便在 22 种生成器上实现了 0.983 的 F1 分数,性能完爆参数量大其 50 倍的竞争对手。
背景定位:从“表象学习”到“取证物理”
目前的 AI 音乐检测面临两大坑:
- 泛化性崩塌 (Generalization Failure):很多模型在训练集上 99% 准确率,但遇到没见过的生成算法(如刚发布的 Suno v4)就成了瞎子。
- 压缩干扰 (Codec Confounding):普通的 MP3 压缩也会带来失真,经常让检测器误以为是 AI 生成的伪影。
ArtifactNet 的核心 Insight 是:不管 AI 怎么进化,它目前的音频生成“咽喉”都在 RVQ(残差矢量量化)上。 量化必然导致不可逆的信息丢失,这种丢失在经过特制模型放大后,就像指纹一样清晰可见。
核心方法:如何捕捉“消失的信号”?
1. ArtifactUNet 与受限掩码
作者设计了一个 3.6M 参数的 ArtifactUNet。它的目的不是生成音频,而是提取“残差(Residuals)”。
- 受限掩码 (Bounded Mask):为了防止网络学到原本声音的快捷路径(Shortcut),作者强制将掩码限制在 [0, 0.5] 之间。这意味着模型只能从原信号中提取最多一半能量的信号作为伪影,逼迫模型专注于那些微小的物理残留。
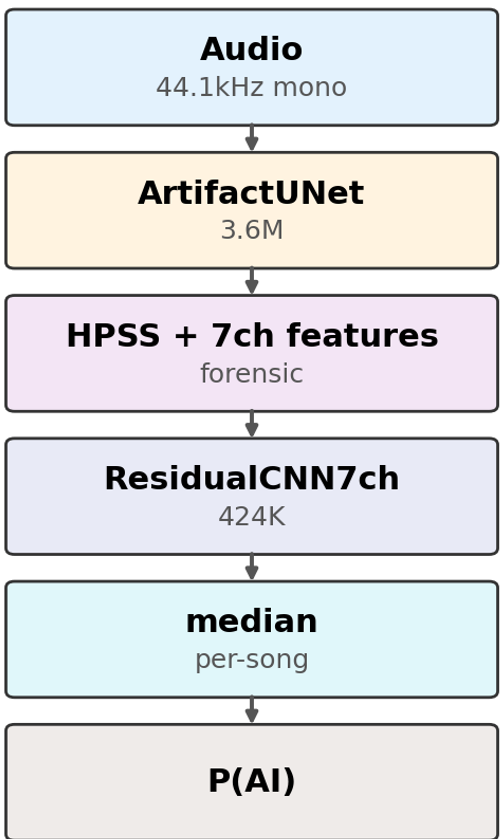 图 1:ArtifactNet 工作流:从 U-Net 提取残差,到 HPSS 特征分解,再到分类器。
2. HPSS 刑事特征
模型提取残差后,通过 和谐/打击乐源分离 (HPSS) 将其分解为 7 个通道(包括 Mel 频谱、和谐分量、打击分量、一阶/二阶梯度等)。AI 生成的音乐由于 RVQ 瓶颈,其残差的有效带宽(Effective Bandwidth)仅为 291 Hz,而人类音乐则高达 1,996 Hz——这种近 7 倍的物理差异正是检测的基石。
3. 抗压缩的“秘密武器”
针对 MP3 误报问题,作者引入了 编解码器感知训练 (Codec-Aware Training)。让模型在训练阶段同时观察 WAV、MP3、AAC、Opus 四种格式的同一音轨。这迫使模型学会忽略这些常见编解码器带来的干扰,只锁定 neural audio codec 特有的伪影。
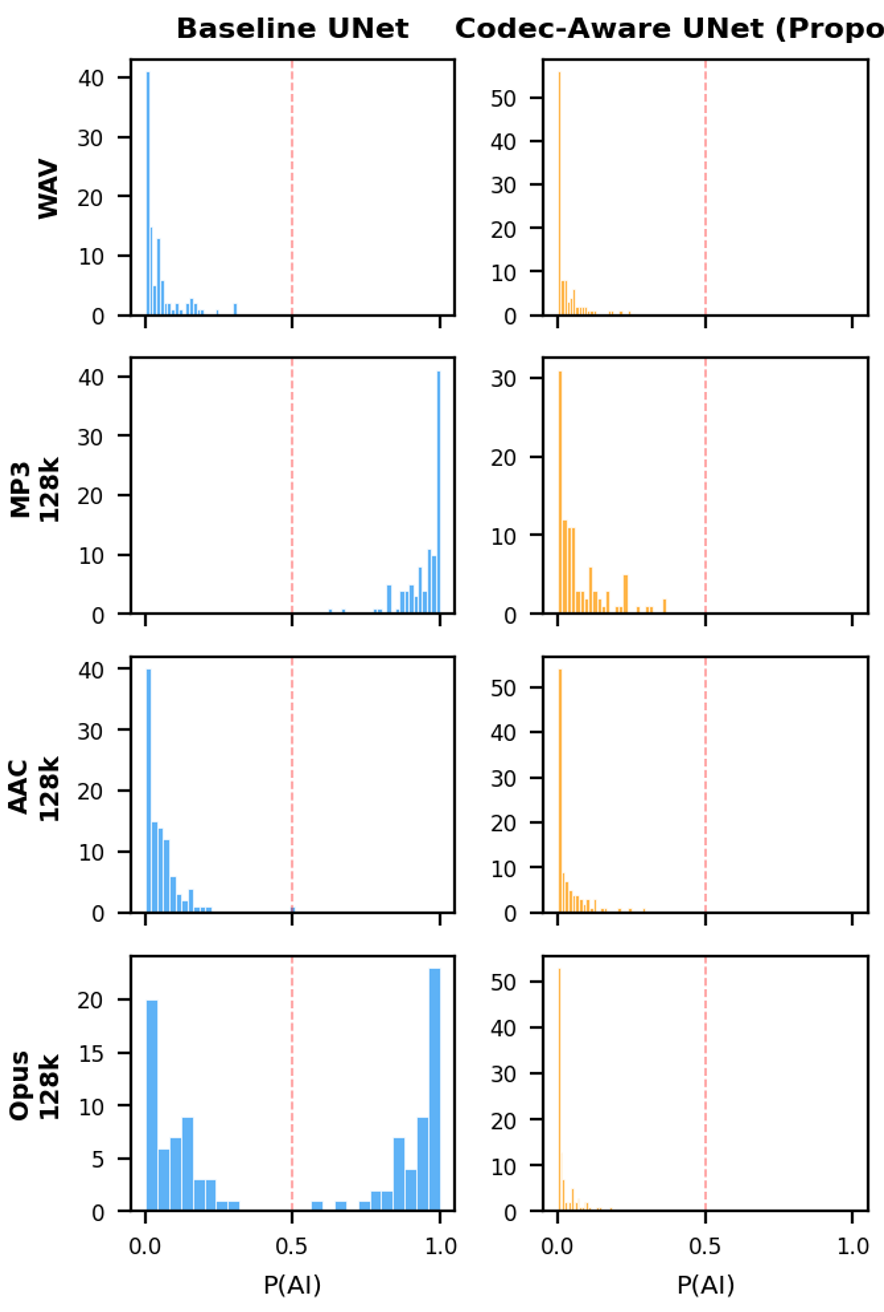 图 2:经过感知训练后,模型对 Real 音轨在不同编解码器下的判定概率趋于稳定,消除了误报对称性。
实验与结果:小参数量级的大获全胜
在涵盖 22 种生成器的 ArtifactBench 评测中,ArtifactNet 表现惊人:
- 性能对比:F1 分数达 0.9829,而 194M 参数的 CLAM 模型仅为 0.7576。
- 效率:参数量 4.0M,仅为 CLAM 的 1/49。
- 鲁棒性:面对“洗白攻击”(用 Demucs 重新进行源分离试图抹除特征),ArtifactNet 依然能保持 0.96 的 AUC。
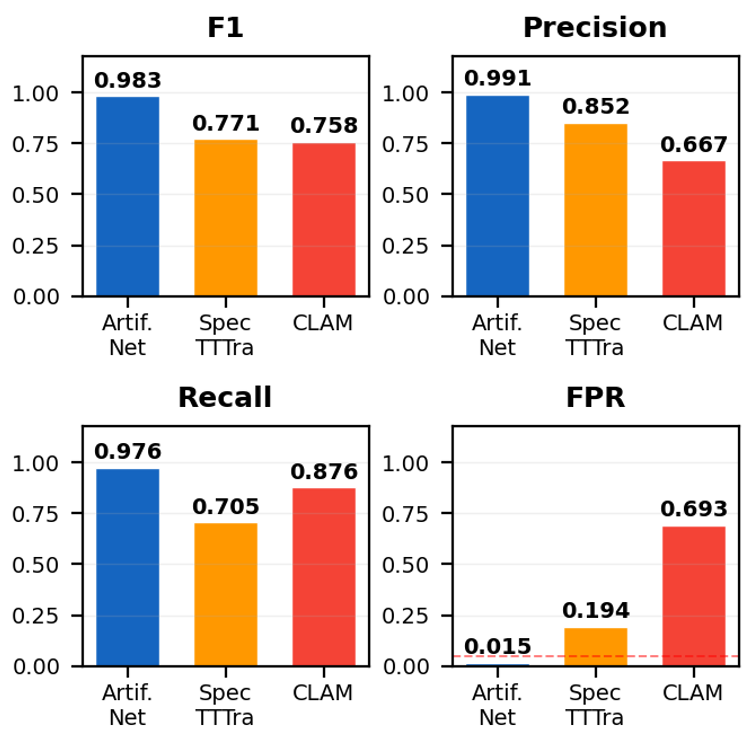 图 3:ArtifactNet 在 F1、精确度(Precision)和召回率(Recall)上全面超越现有 SOTA。
深度洞察:为什么“刑事物理”能赢?
这篇文章最深刻的地方在于它挑战了“大力出奇迹”的信念。CLAM 这种模型使用海量数据和巨大的 Transformer 预训练权重(如 Wav2Vec2、MERT),它试图理解“什么是美妙的音乐”,却忽略了“生成这些音乐的设备有什么缺陷”。
结论 (Takeaway):AI 取证领域正经历从“语义判别”向“物理规律验证”的范式转移。正如图像取证中利用扩散模型噪声特征一样,音频取证利用 RVQ 瓶颈提供了一个几乎无法规避的抓手。
局限性分析: 虽然 ArtifactNet 强大,但它对采样率有要求(推荐 44.1kHz)。如果输入的音频被粗暴采样到 16kHz 以下,高频伪影就会丢失,检测效能会明显下降。此外,针对最新版本 Udio 的检测召回率略低,暗示了新一代生成器正试图在时频域修复这些物理痕迹。