
Audio-DeepThinker:让音频模型“深度思考”,强化学习催生的 CoT 新高度
Audio-DeepThinker: Progressive Reasoning-Aware Reinforcement Learning for High-Quality Chain-of-Thought Emergence in Audio Language Models
本文提出了 Audio-DeepThinker,这是一种通过强化学习(RL)使大语言音频模型(LALM)涌现思维链(CoT)能力的框架。该方法无需任何人工标注的推理数据,在 MMAR、MMAU 和 MMSU 等多个基准测试中刷新了 SOTA 记录,并获得 Interspeech 2026 音频推理挑战赛单模型冠军。
TL;DR
传统的音频语言模型往往是“直觉式”的:听到声音,直接给出答案。而来自腾讯 AI Lab 等机构的团队通过 Audio-DeepThinker 框架,证明了通过精心设计的两阶段强化学习(RL),即使是原本不具备推理能力(Implicit Reasoning)的模型,也能在零监督数据的情况下涌现出逻辑严密的思维链(Chain-of-Thought)。该模型在 Interspeech 2026 音频推理挑战赛中斩获第一。
背景定位:从“感觉”到“逻辑”
目前的音频模型(如 Qwen2-Audio, SALMONN)在感知层面已经非常强大,但在处理复杂逻辑(如:根据背景环境音推断发声者的地理位置)时,往往回答得正确却说不清原因。前人尝试通过人为编写 CoT 数据进行 SFT,但这就像是让模型背诵标准答案,限制了其在未知领域的探索。Audio-DeepThinker 走的是类似 DeepSeek-R1 的路线:不喂答案,只给奖励,让模型自己学会思考。
痛点深挖:语义脱钩与粗粒度奖励
现有 RL 增强音频推理的方法面临两大挑战:
- 形式主义:模型学会了写
<reasoning>标签,但里面的内容可能是一本正经地胡说八道,与音频内容完全没关系。 - 信号稀疏:如果只奖励“答对了”,模型可能会为了凑对答案而牺牲推理逻辑的严谨性。
核心动力学:混合奖励与两阶段课程
针对上述痛点,Audio-DeepThinker 设计了一套高精度的“导航系统”。
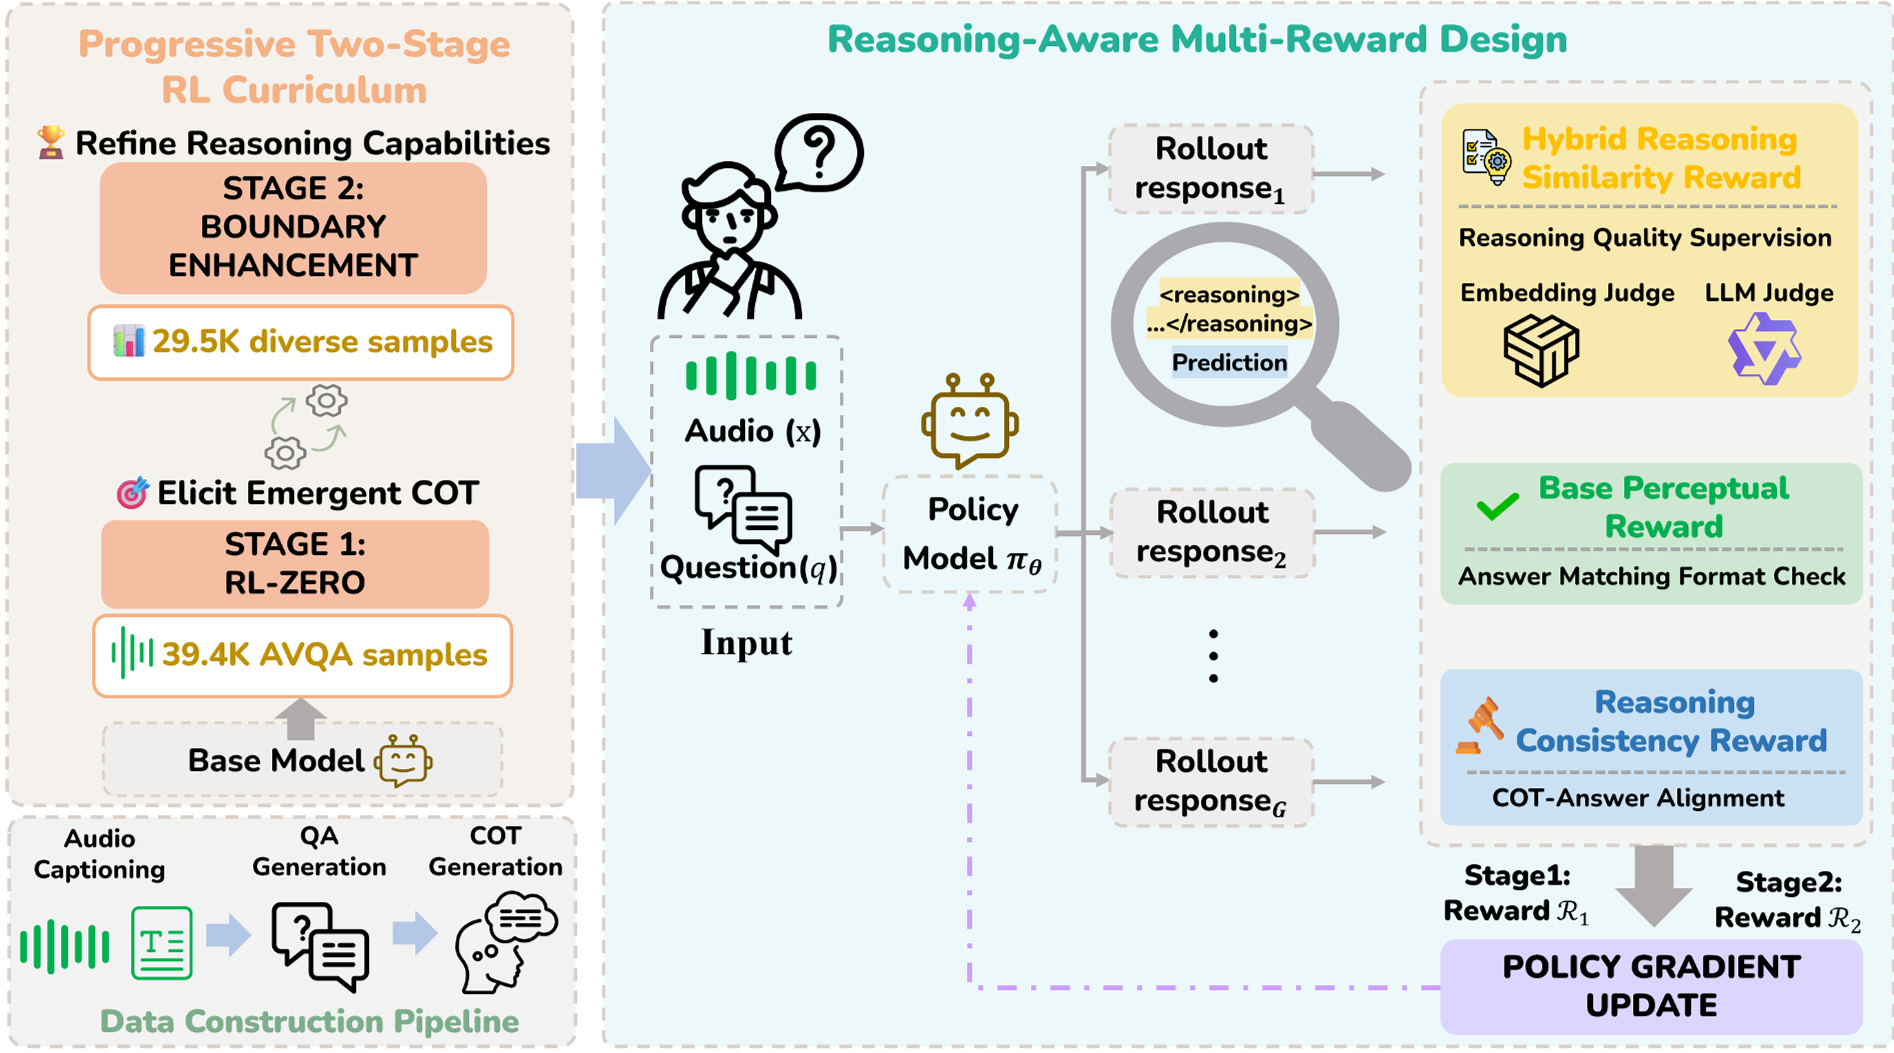
1. 混合推理相似性奖励 (Hybrid Reward)
为了防止语义脱钩,作者不仅比对最终答案,还对推理过程进行打分:
- LLM 逻辑评估:利用强力 LLM 作为裁判,评估推理路径的逻辑性、步骤覆盖率和分析深度。
- 嵌入相似性 anchor:通过 BGE-M3 向量对比,确保生成的推理链在语义上靠近由详细 Audio Caption 转化而来的参考路径。
2. 两阶段强化学习架构图
训练并非一蹴而就,而是采用了从易到难的渐进式课程:
- Stage 1 (模式演练):在基础音频 QA 上进行,此时使用最严格的混合奖励,强制模型养成“先思考再回答”且“思考要有凭据”的习惯。
- Stage 2 (极限挑战):转向极具挑战性的边界案例(Boundary Cases),此时撤掉部分约束,赋予模型更大的自由度去探索不同的逻辑路径。
实验战绩:全线霸榜
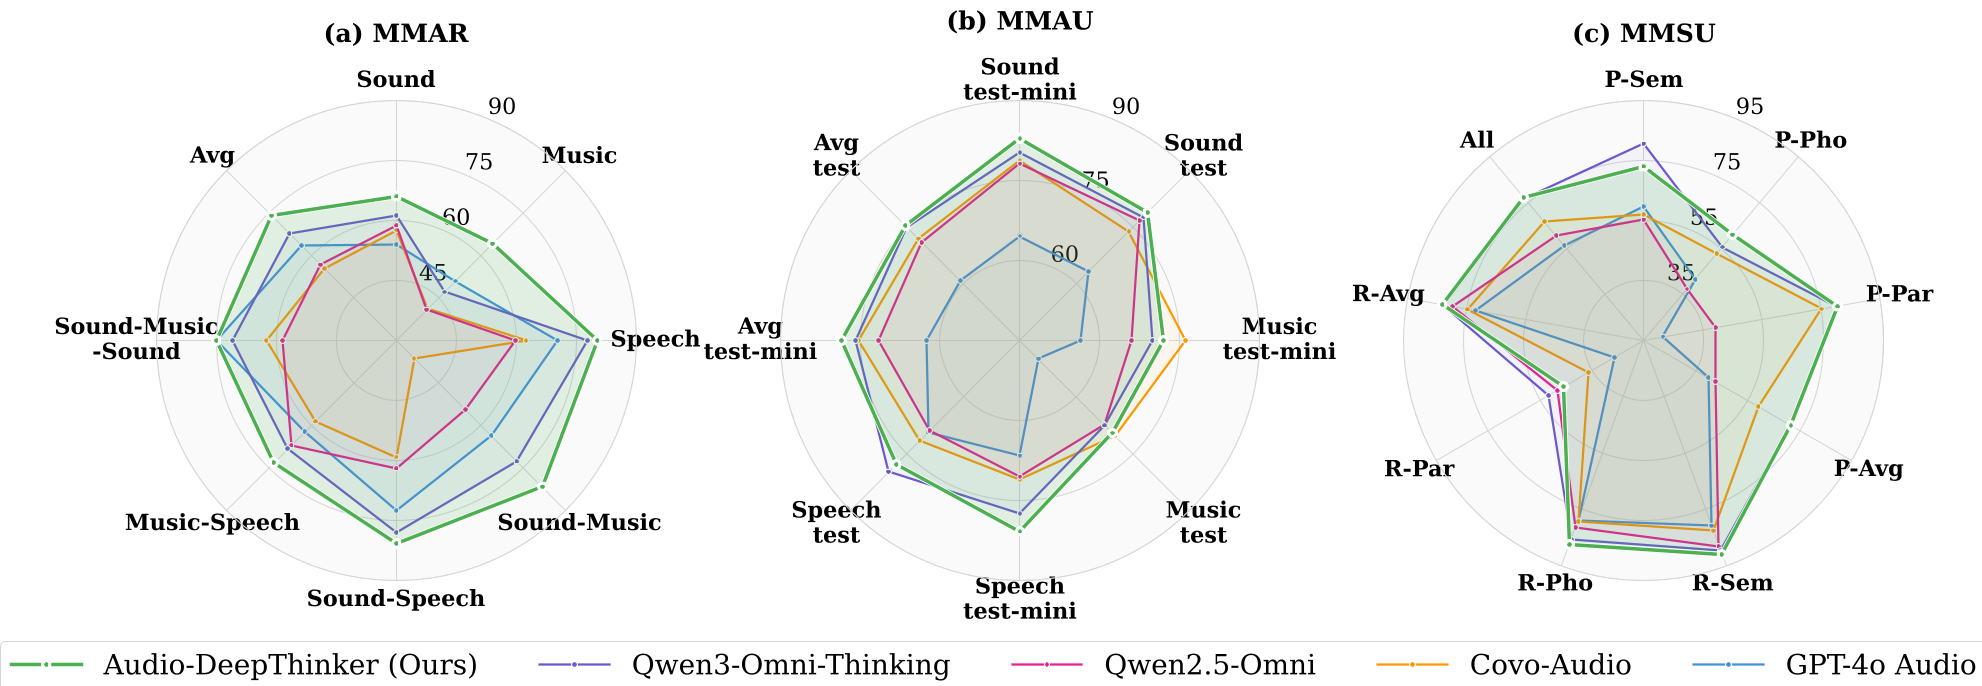
Audio-DeepThinker 在 MMAR、MMAU 和 MMSU 三大榜单上展现了恐怖的统治力。
- SOTA 突破:在 MMAR 上以 74.0% 的准确率超越了包括 Gemini 2.0 Flash 在内的众多劲敌。
- 感知与推理的双重进化:在音乐(Music)维度,推理能力带来的准确率提升高达 6.8%,证明了复杂的声学结构(如旋律、配器分析)极其依赖显性的逻辑拆解。
深度洞察:推理是如何“长出来”的?
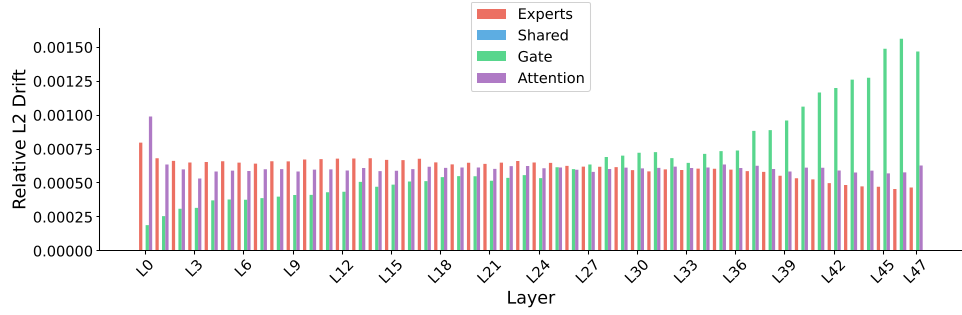
作者通过 Mechanistic Interpretability(机械解释性分析) 揭示了 RL 训练模型背后的运行逻辑,这是本论文最具技术深度的部分:
- MoE 路由的重组:分析发现,RL 训练并没有改变 Expert(专家模块)存储的知识,而是极大地改变了 Upper-layer MoE Gating(上层门控机制)。这意味着 RL 实际上是在教模型如何更聪明地“调度”已有的知识。
- 决策层的集中:通过 Logit Lens 分析,推理相关的 Token(如
<reasoning>)在模型的第 40 层之后才开始显著结晶。这表明推理是一种高阶的、“临门一脚”的计算行为,主要集中在变压器架构的顶层。
总结与局限
Takeaway:Audio-DeepThinker 证明了 LALM 的推理瓶颈不在于架构,而在于缺乏针对过程的精细奖励信号。通过 SFT-free 的 RL 路径,模型可以自主发现比人类标注更优的推理策略。
局限性:尽管两阶段 RL 非常有效,但其训练成本依然较高,且对 Reward Model 的质量依赖性极强。未来的研究方向可能会集中在参数高效的 RL(PE-RL),例如仅微调 Gating 网络而冻结专家层。