
BAGEL:大语言模型真的是“动物专家”吗?首个全方位动物知识基准发布
BAGEL: Benchmarking Animal Knowledge Expertise in Language Models
本文推出了 BAGEL,一个包含 11,852 道多选题的闭卷评测基准,旨在评估大语言模型(LLMs)在动物学知识方面的专业能力。该基准涵盖了从 Wikipedia 的百科事实到 bioRxiv 的科研推理、GloBI 的生态交互以及 Xeno-canto 的生物声学文字知识等四个核心维度。
TL;DR
尽管大语言模型在学术考试中屡破纪录,但面对“安第斯火烈鸟的腿是什么颜色”或“某种特定真菌对树木造成的生态影响”这类长尾专业知识时,它们的表现依然参差不齐。近日发布的 BAGEL (Benchmark for Animal knowledGe Expertise in Language models) 揭示了一个残酷事实:即便最强的 GPT-5 级别模型,在生物声学推理等领域也存在显著短板。
背景定位:填补自然史知识评测的空白
在 AI 领域,我们已经拥有了衡量子集(MMLU)或生物医学(PubMedQA)的工具,但在**物种级(Species-level)事实和生态网络(Ecological Relations)**方面一直缺乏统一的闭卷评测。BAGEL 的出现不仅是对模型记忆能力的测试,更是对其在复杂自然逻辑下泛化能力的深度体检。
痛点深挖:通用能力的“偏科”现象
研究者发现,模型在 Wikipedia 这种语料丰富的百科任务上表现强劲,但在处理来自 GloBI(全球生物交互数据库) 或 Xeno-canto(生物声学社区) 的专业数据时,准确率大幅下滑。这种“偏科”现象说明,现有的通用预训练并不能等同于真正的领域专家(Domain Expertise)。
方法论详解:BAGEL 的四大核心支柱
BAGEL 的独特性在于其多源数据的互补性:
- Wikipedia (百科全书):评估分类、行为、分布等通用事实。
- GloBI (生态网络):通过“掩码参与者识别”或“交互类型推理”,测试模型对捕食、共生等生态逻辑的理解。
- bioRxiv (科学文献):直接从前沿论文的摘要和实验结果中生成问题,考察 scientific reasoning。
- Xeno-canto (生物声学文字化):这是该 benchmark 的一大亮点,它将音频特征转化为文字描述,测试模型对频率、调制模式等声学特征的“常识”。
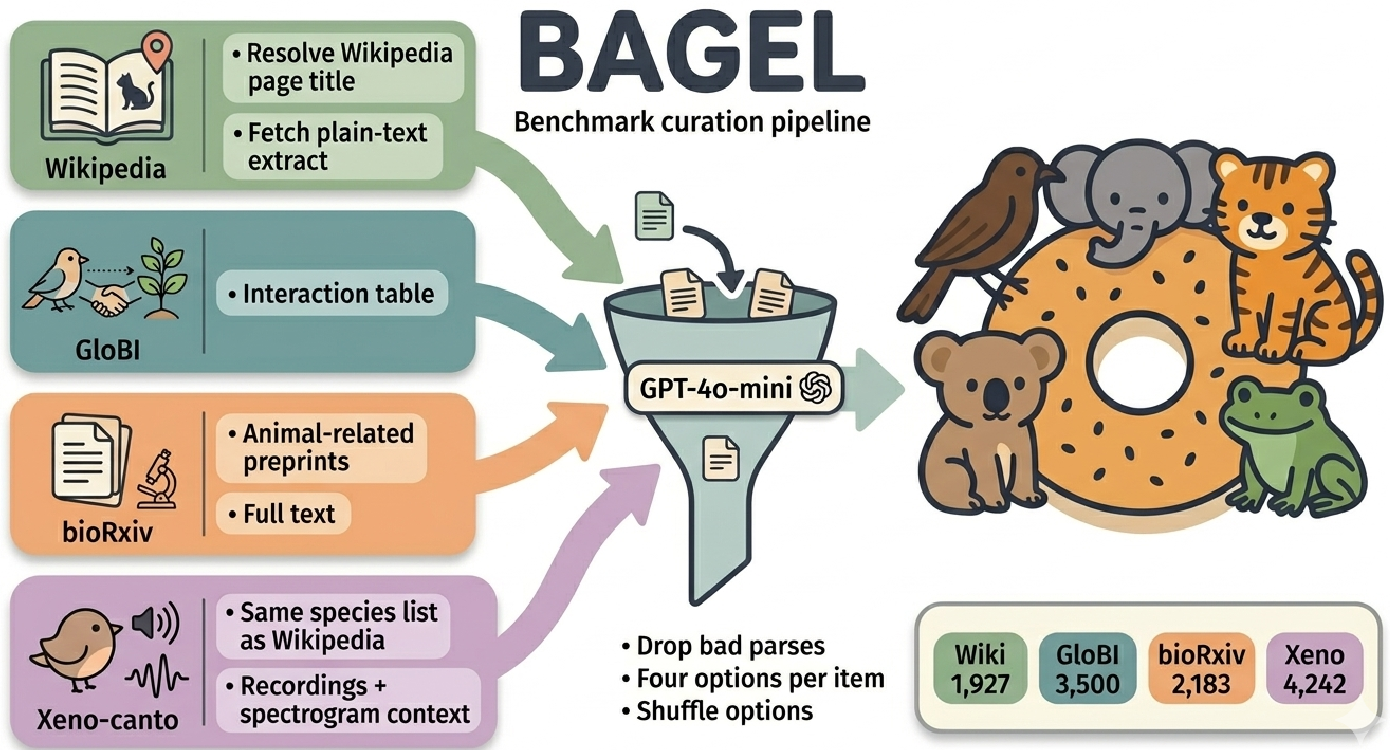 图 1:BAGEL 基准构建工作流,展示了从四类源数据到自动化问题生成的全过程。
实验与结果:参数量不是万能药
在对 GPT-5.4、Claude Opus 4.6 以及 Llama、Qwen 等开源模型进行大规模评测后,BAGEL 给出了几项关键洞察:
- 阶梯式领先:闭源模型在综合得分上依旧独一无二。
- 声学瓶颈:所有模型在 Xeno-canto 领域的表现均较差,主频率范围尚可,但“调制模式”识别准确率极低。
- Qwen3 的局限:有趣的是,Qwen3-32B 在部分声学任务上性能反而不如其 14B 模型。这说明:单纯增加参数量,并不一定能填补低频专业领域的知识空缺。
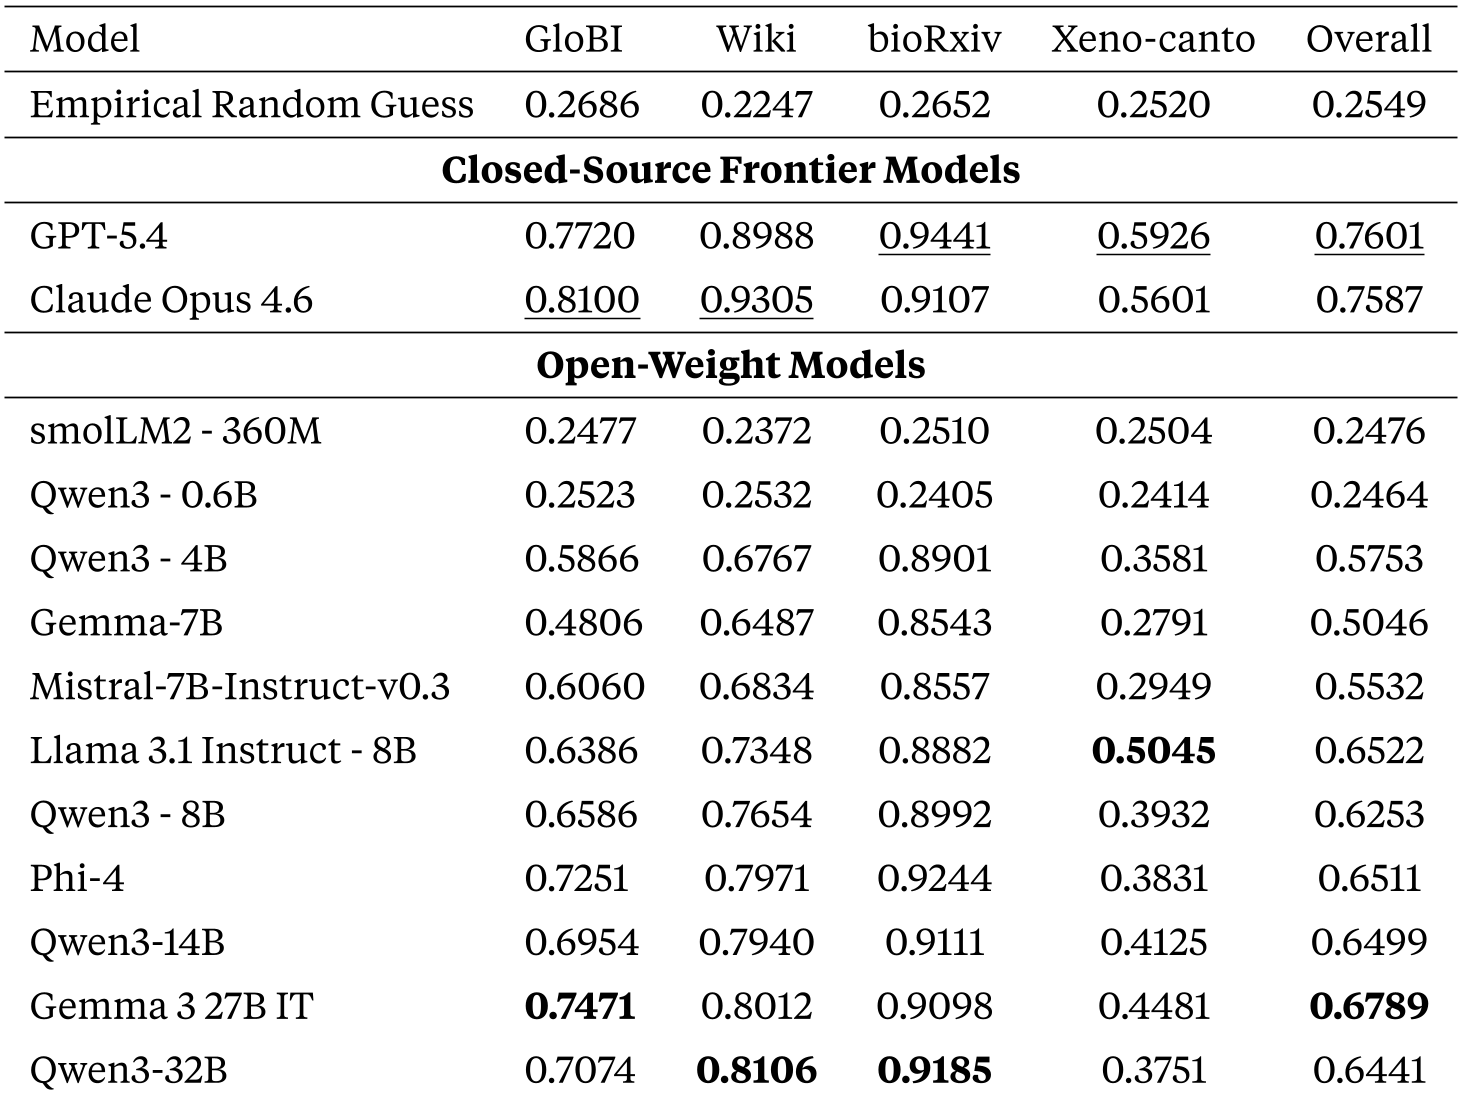 表 1:不同模型在各领域的准确率对比。注意 Xeno-canto 列普遍低迷。
深度洞察与总结
Takeaway: BAGEL 的发布证明了我们离构建“全知”的自然研究助手还有很长的路要走。
局限性分析:
- 位置偏差 (Positional Bias):作者发现小模型(如 0.6B)几乎全倾向于选 A,暴露出 LLM 应对 MC 格式时的内在脆弱性。
- 闭卷局限:BAGEL 主要测试参数化知识,而非 RAG(检索增强生成)能力,但在实际科研场景中,检索能力同样重要。
未来展望: 随着 NatureLM 等多模态基础模型的出现,将 BAGEL 扩展到音频、图像和文本的跨模态评测,将是提升生物多样性应用可靠性的必经之路。