
CityRAG:将 RAG 引入视频生成,打造真实物理世界的“任意门”
CityRAG: Stepping Into a City via Spatially-Grounded Video Generation
本文提出了 CityRAG,一种空间对齐(Spatially-Grounded)的视频生成模型,通过检索外部地理信息(RAG)来生成与真实世界物理布局一致的 3D 可导航环境。该方法基于 Wan 2.1 视频大模型,通过整合全球 10 个城市的 Street View 数据,实现了长达数分钟、物理一致的城市漫游视频生成。
TL;DR
传统的视频生成模型往往是“逻辑上的天才,现实中的路痴”——它们能生成漂亮的画面,但无法复刻真实的地理坐标。Google 与康奈尔等团队联合推出的 CityRAG 改变了这一现状。通过检索真实的街景数据作为“记忆锚点”,CityRAG 首次实现了与地理位置严格对应的 3D 一致性视频生成,支持在任意天气、动态环境下漫游真实的纽约或伦敦街头。
痛点与动机:为什么 AI 视频总是“不认路”?
在自动驾驶仿真或虚拟旅游中,我们需要的不仅是一个“看起来像城市”的视频,而是一个“就是那个路口”的环境。
- 扩散模型的局限性:Sora 或 Wan 2.1 等模型依赖训练权重的隐式记忆,一旦遇到长路径,街道就会开始“融化”或随机变异。
- 重建技术的僵硬性:NeRF 或 3D 现代模型需要对特定时刻进行密集采样,无法灵活切换“雨天”或“夜晚”模式,更难以生成真实的人流。
作者的逻辑直觉 (Insight):如果大语言模型可以通过 RAG(检索增强生成)查阅百科全书来减少幻觉,视频模型为什么不能查阅“地图街景”来对齐物理空间呢?
方法论:解耦“永恒”与“瞬间”
CityRAG 的核心在于其精妙的架构设计,它将场景拆分为:
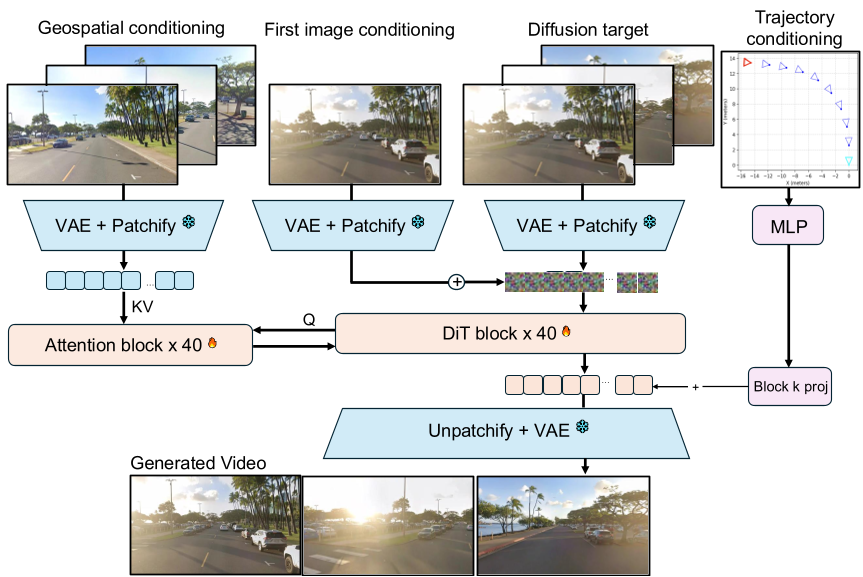
- 静态(Statics):建筑、路面、立交桥。这些通过检索街景数据库(Google Street View)获得。
- 瞬态(Transients):当前的光照、降雨、行人、违停车辆。这些由用户输入的“第一张图”设定。
架构解析
模型基于 Wan 2.1 (14B) 架构。为了引入空间约束,作者做了两个关键改变:
- 轨迹条件(Trajectory Conditioning):将相机位姿矩阵通过 MLP 注入到 DiT 块中,确保镜头移动严格受控。
- 空间交叉注意力(Geospatial Cross-Attention):模型会同时“盯着”检索出来的老视频和当前要生成的画面。即使老视频里是晴天且停着旧车,模型也能提取出其中的建筑轮廓,并在生成时将其渲染为用户要求的“雪天”。
实验与结果:从“生成”到“模拟”
CityRAG 在极具挑战性的街区进行了测试,包括圣胡安、巴黎、旧金山等。
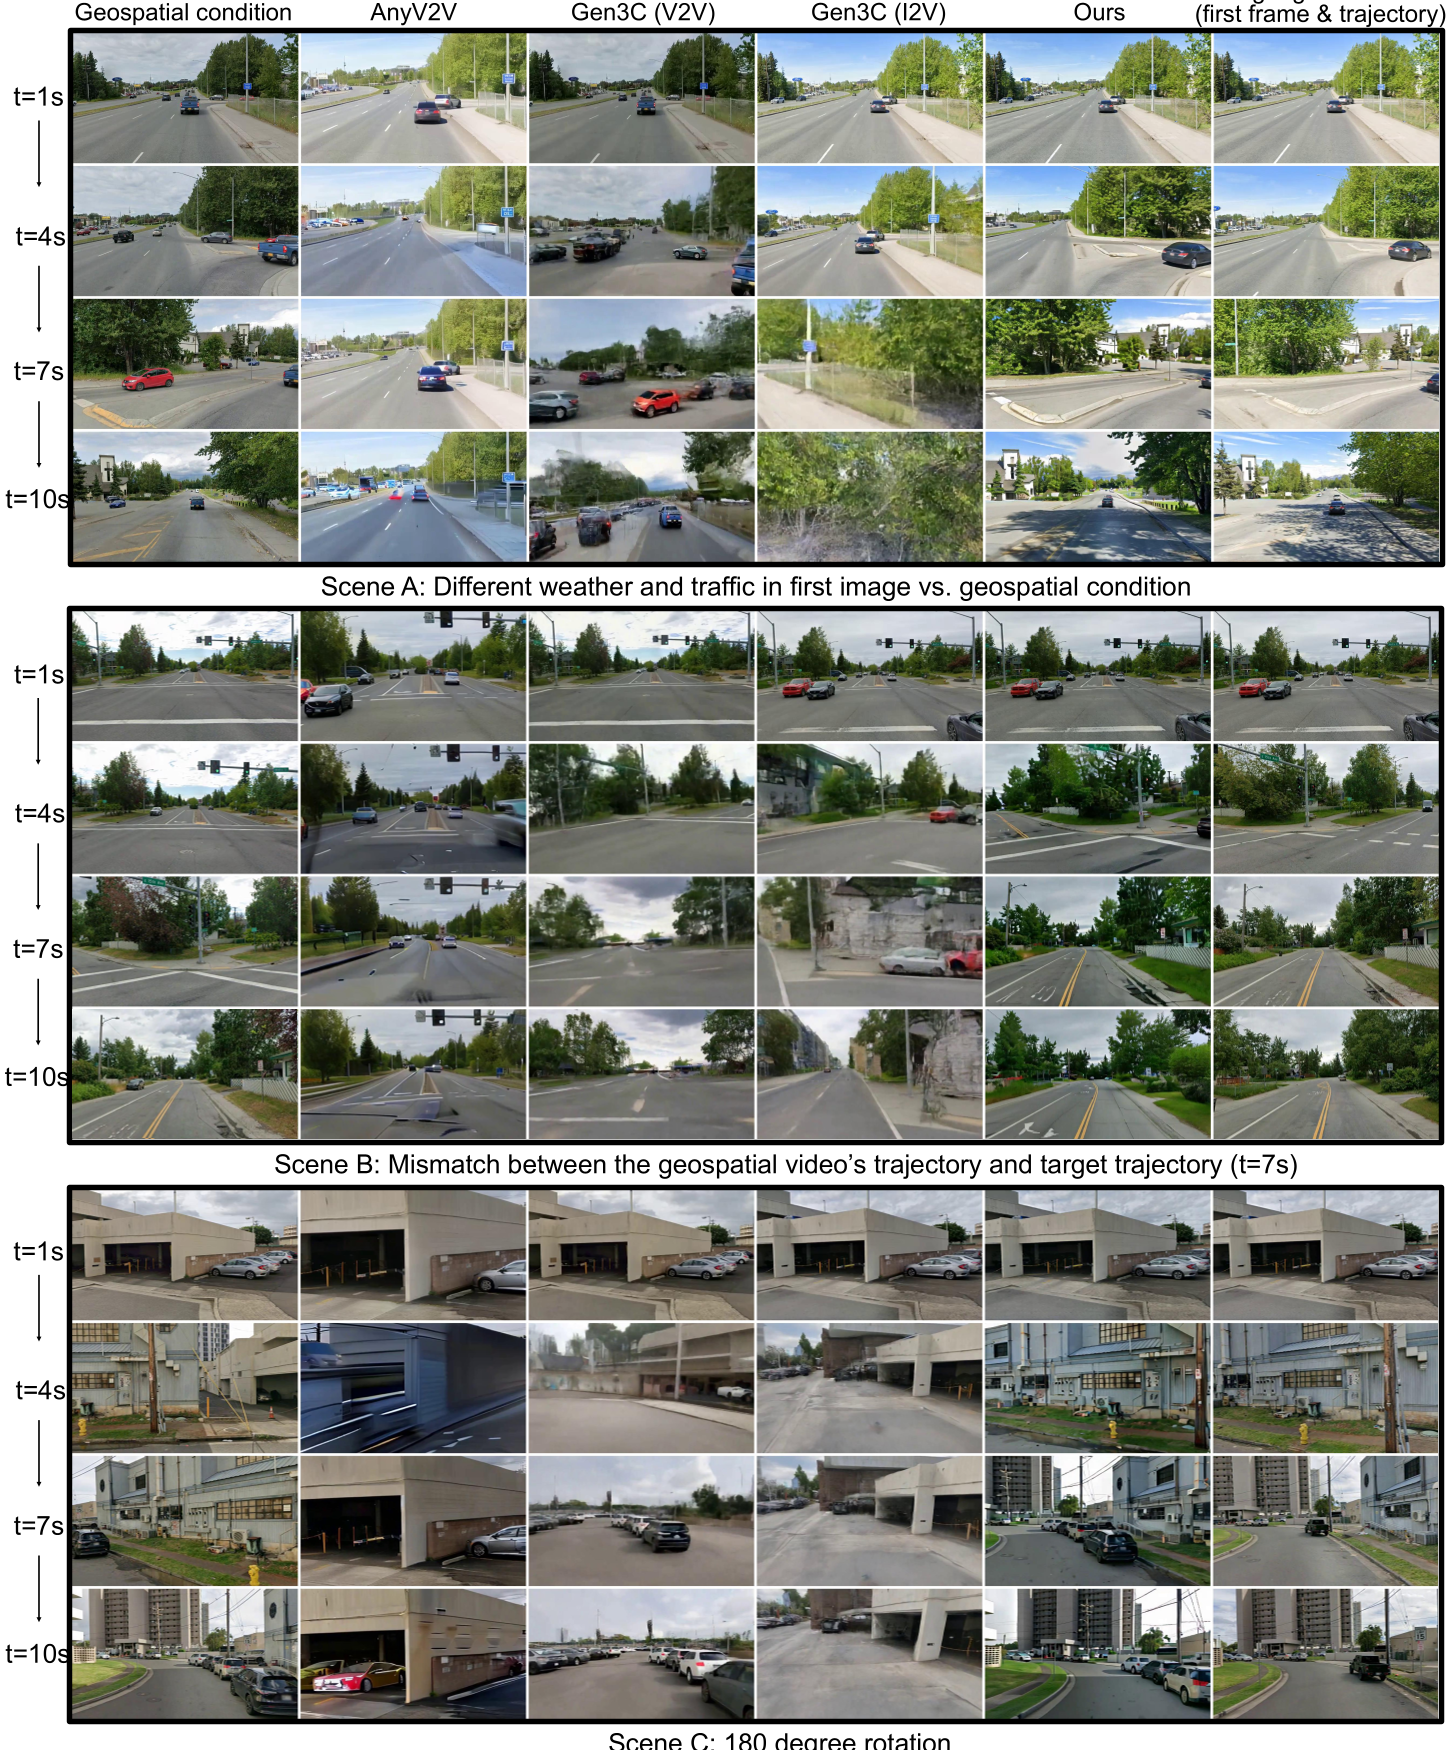
- 复杂轨迹的韧性:在场景 B 中,即便检索视频因为堵车停滞了,模型仍能根据后续的轨迹参数,“预见性”地渲染出转角后的建筑。
- 3D 一致性验证:当相机进行 180 度或 360 度大转弯回到原点时,建筑物的细节高度闭环,没有出现常见的漂移现象。
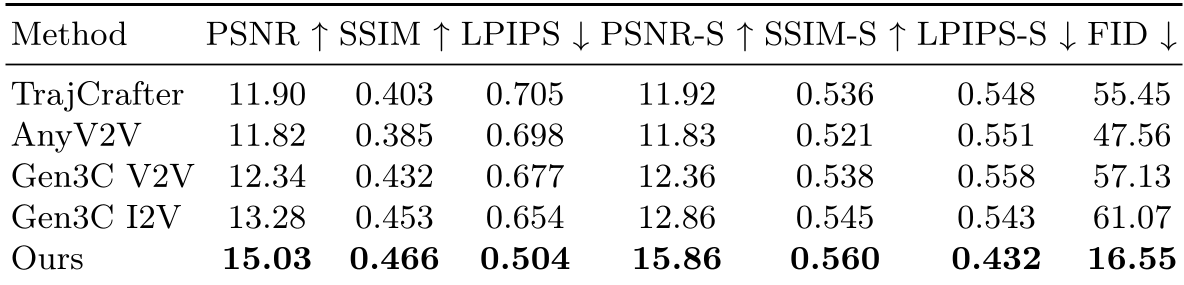
在量化指标上(见下表),CityRAG 在评估真实感与空间一致性的 LPIPS-S 和 FID 维度上展现了碾压式的优势。
深度洞察与总结
CityRAG 的意义在于它为“世界模型”提供了一种可扩展的路径。它不再试图让模型背下整个地球的所有细节,而是让模型学会**“查地图”**。这种“模型作为渲染器,外部数据作为几何源”的思想,极大地降低了长视频生成的逻辑幻觉。
局限性:
- 自回归累积误差:虽然支持分钟级视频,但由于是分段自回归生成,极远距离后仍可能存在微小错位。
- 数据偏差:街景数据大多采样于良好天气,导致模型对极端恶劣天气(如大暴雨)的物理表现仍有待精进。
未来展望: 随着这种基于检索的视频生成技术成熟,未来的游戏可能不再需要庞大的美术资产包,只需一个小巧的模型加一个街景 API,就能实时渲染出一个 1:1 的真实世界虚拟化身。