
ClawEnvKit:告别静态 Benchmark,智能体环境进入按需自动生成时代
ClawEnvKit: Automatic Environment Generation for Claw-Like Agents
本文推出了 ClawEnvKit,这是一个能够根据自然语言指令自动生成、验证并运行“爪型(Claw-like)”智能体训练与评估环境的自动化框架。基于该框架,作者构建了首个大规模基准测试 Auto-ClawEval(包含 1,040 个环境),在保持与人工标注环境同等质量的同时,将成本降低了 13,800 倍。
TL;DR
在 Agent 领域,构建高质量的评估环境一直是“手动挡”模式:耗时、昂贵、且容易数据泄露。ClawEnvKit 彻底改变了这一现状。它能根据你一句话的需求,自动生成包含 Mock 服务数据库、API 接口和评分逻辑的加密沙箱环境。作者借此发布了 Auto-ClawEval,不仅任务量扩充到了 1040 个,且成本仅为人工的万分之一。
1. 痛点深挖:静态 Benchmark 的“寿命之困”
当前的 LLM Agent(如 OpenClaw, Claude Code 等)进化极快,但我们评价它们的方式却很落后:
- 可扩展性差:手写一个带有自动评分逻辑的复杂任务(涉及邮件、日历、数据库协作)需要数小时。
- 数据污染(Data Contamination):静态 Benchmark 一旦发布,很快就会被 LLM 预训练语料“吃掉”,导致评分虚高。
- 缺乏灵活性:如果我想测试 Agent 在“特定金融合规场景”下的表现,现有的 Benchmark 往往无法覆盖。
2. 核心机制:ClawEnvKit 如何变魔术?
ClawEnvKit 的核心理念是将环境定义为三元组 :
- (Task Specification):任务的自然语言描述。
- (Interaction Interface):Agent 可调用的工具集。
- (Evaluation Functional):基于审计日志(Audit Log)的确定性评分函数。
自动化生成流水线
ClawEnvKit 内部运行着一套精密的 LLM 多智能体流水线:
- Parser (解析器):将用户的模糊需求拆解为具体的“意图原子(Intent Atoms)”,如“动作:发送邮件”、“约束:日期必须在周五”。
- Generator (生成器):生成对应的 Mock 服务、预装文件数据以及评分逻辑。
- Validator (验证器):通过格式检查(YAML 合法性)、覆盖率检查(是否包含所有意图)和可行性检查(环境是否可解)确保生成的环境有效。
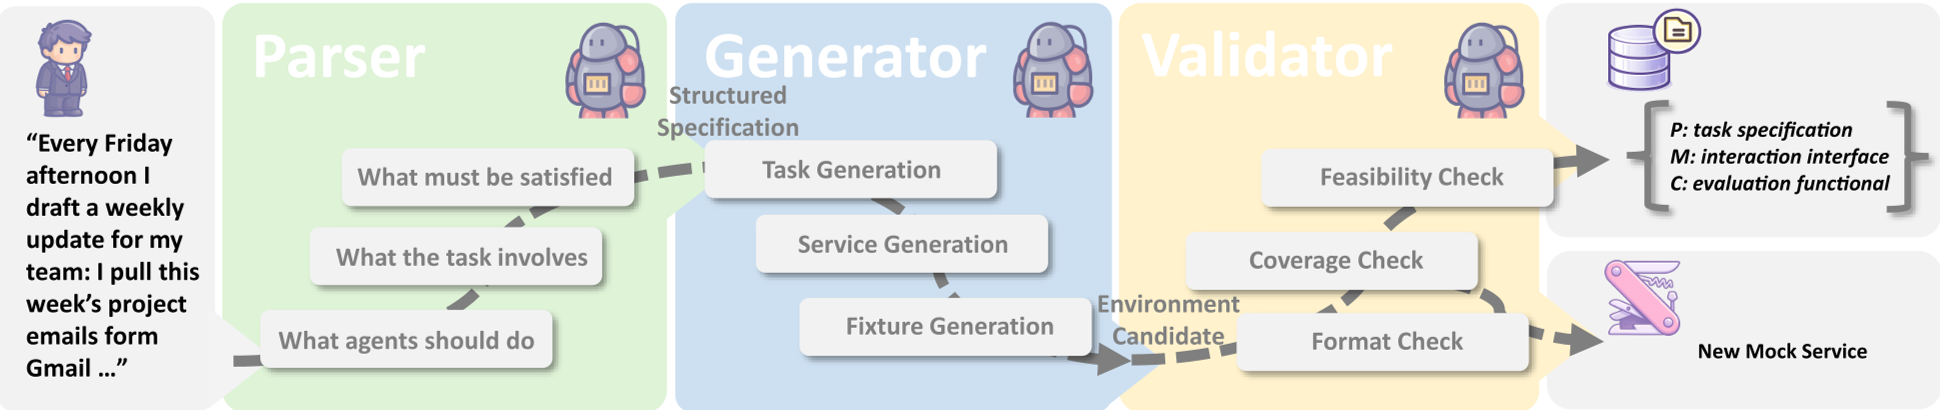 图 1:ClawEnvKit 环境生成的多智能体协作流程
3. 实验结果:自动生成的环境真的靠谱吗?
为了验证质量,作者对比了人工构建的 Claw-Eval 和自动生成的 Auto-ClawEval-Mini。
(1) 质量对比:LLM 比人更有逻辑
在连贯性(Coherence)评分上,自动生成的任务得分为 0.59,高于人工的 0.51。这是因为 ClawEnvKit 生成的 Prompt 与工具集经过了严格的匹配验证,消除了人工作业时经常出现的“指令与 API 接口不一致”的低级错误。
(2) 工具集成(Harness)的影响
研究发现,Agent 的内核模型很重要,但 Harness(挂架/工程封装) 往往决定了成败。使用结构化 Harness(如 NemoClaw 或 Claude Code)相比于裸奔的 ReAct 循环,性能最高能提升 15.7%。
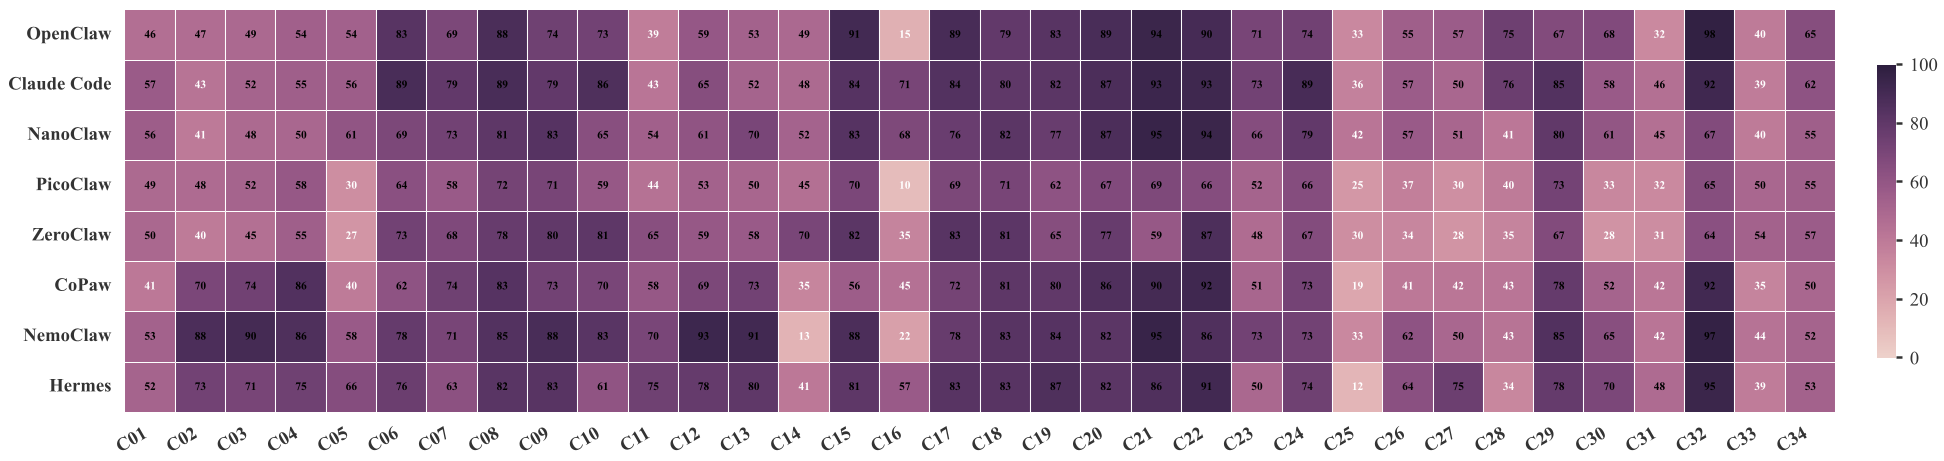 图 2:不同 Harness 在 24 个任务类别中的表现差异,暴露出当前 Agent 在特定复杂逻辑(如 C16 类别)上的普遍软肋
4. 深度洞察:让评估“活”起来
ClawEnvKit 最具前瞻性的贡献不在于那 1040 个任务,而在于 Live Evaluation(即时评估) 的概念。
- 防泄露:每次测试都可以生成全新的、从未公开发布过的环境。
- 训练闭环:该框架可以直接作为 RL(强化学习)的环境生成器,根据模型当前的弱点,定向合成训练数据(On-demand Training)。
5. 总结与反思
ClawEnvKit 证明了“用 AI 评估 AI”在环境构建这一极其繁杂的领域是完全可行的。
- 局限性:目前主要依赖于 Mock Services(模拟服务)。模拟服务虽然高效,但在身份验证(OAuth)和网络延迟等真实物理世界的复杂性表现上仍有差距。
- 未来方向:未来该工具若能接入真实的 OpenAPI 文档自动合成生产级环境,将极大加速企业级 Agent 的落地。
Senior Editor's Note: ClawEnvKit 实际上在 Agent 领域推行了“软件定义环境”的概念。在 Benchmark 迅速腐解的今天,这种“流水线即测试”的思路是学术界和工业界对抗数据污染的必经之路。