
CoEvolve:打破静态数据桎梏,让 LLM Agent 在自我博弈中进化
CoEvolve: Training LLM Agents via Agent-Data Mutual Evolution
本文提出了 CoEvolve,一个 LLM Agent 与训练数据“双向演化”的强化学习框架。该方法通过从训练轨迹中提取遗忘、边界和稀缺信号来识别 Agent 的薄弱环节,并据此动态合成新任务进行针对性训练,在 AppWorld 和 BFCL 榜单上显著提升了开源模型(如 Qwen2.5/Qwen3)的性能。
TL;DR
阿里巴巴 AMAP 团队提出的 CoEvolve 框架,通过一种“智能体与数据双向演化”的思路,解决了 LLM Agent 训练中数据分布滞后的难题。它不再喂食固定的语料,而是通过监测模型的遗忘、犹豫和认知盲区,动态“定制”高难度的合成任务。实验证明,这一机制能让 4B 规模的小模型在工具调用能力上逆袭 GPT-4。
背景定位:从“喂养”到“演化”
在强化学习(RL)训练 LLM Agent 的过程中,我们通常面临两个极端:
- 人工示范 (Expert-Supervised):质量高但极度昂贵,像是一本读不完的字典,涵盖不了现实世界的无穷变数。
- 静态合成 (Static Synthetic):用 LLM 盲目生成数据,看似量大,实则大量重复,且与 Agent 当前的学习进度脱节。
CoEvolve 提出:数据不应该是死的,它应该像 Agent 的“教练”一样,模型哪里强,教练就换个花样考哪里。
核心机制:捕捉 Agent 的“焦虑”信号
CoEvolve 的精妙之处在于它定义了三种捕捉模型弱点的反馈信号 (Feedback Signals):
- 遗忘信号 (Forgetting Signals):模型曾经能做对、但现在由于权重更新反而做错的任务。这预示着灾难性遗忘的苗头。
- 边界信号 (Boundary Signals):模型在面对同一个任务时,多次尝试表现极其不稳定(时好时坏)。这说明该任务处于模型的“决策边界”。
- 稀缺信号 (Rare Signals):在训练中极少出现的操作模式。这代表了模型未曾谋面的“长尾分布”。
架构拆解:闭环进化的三大阶段
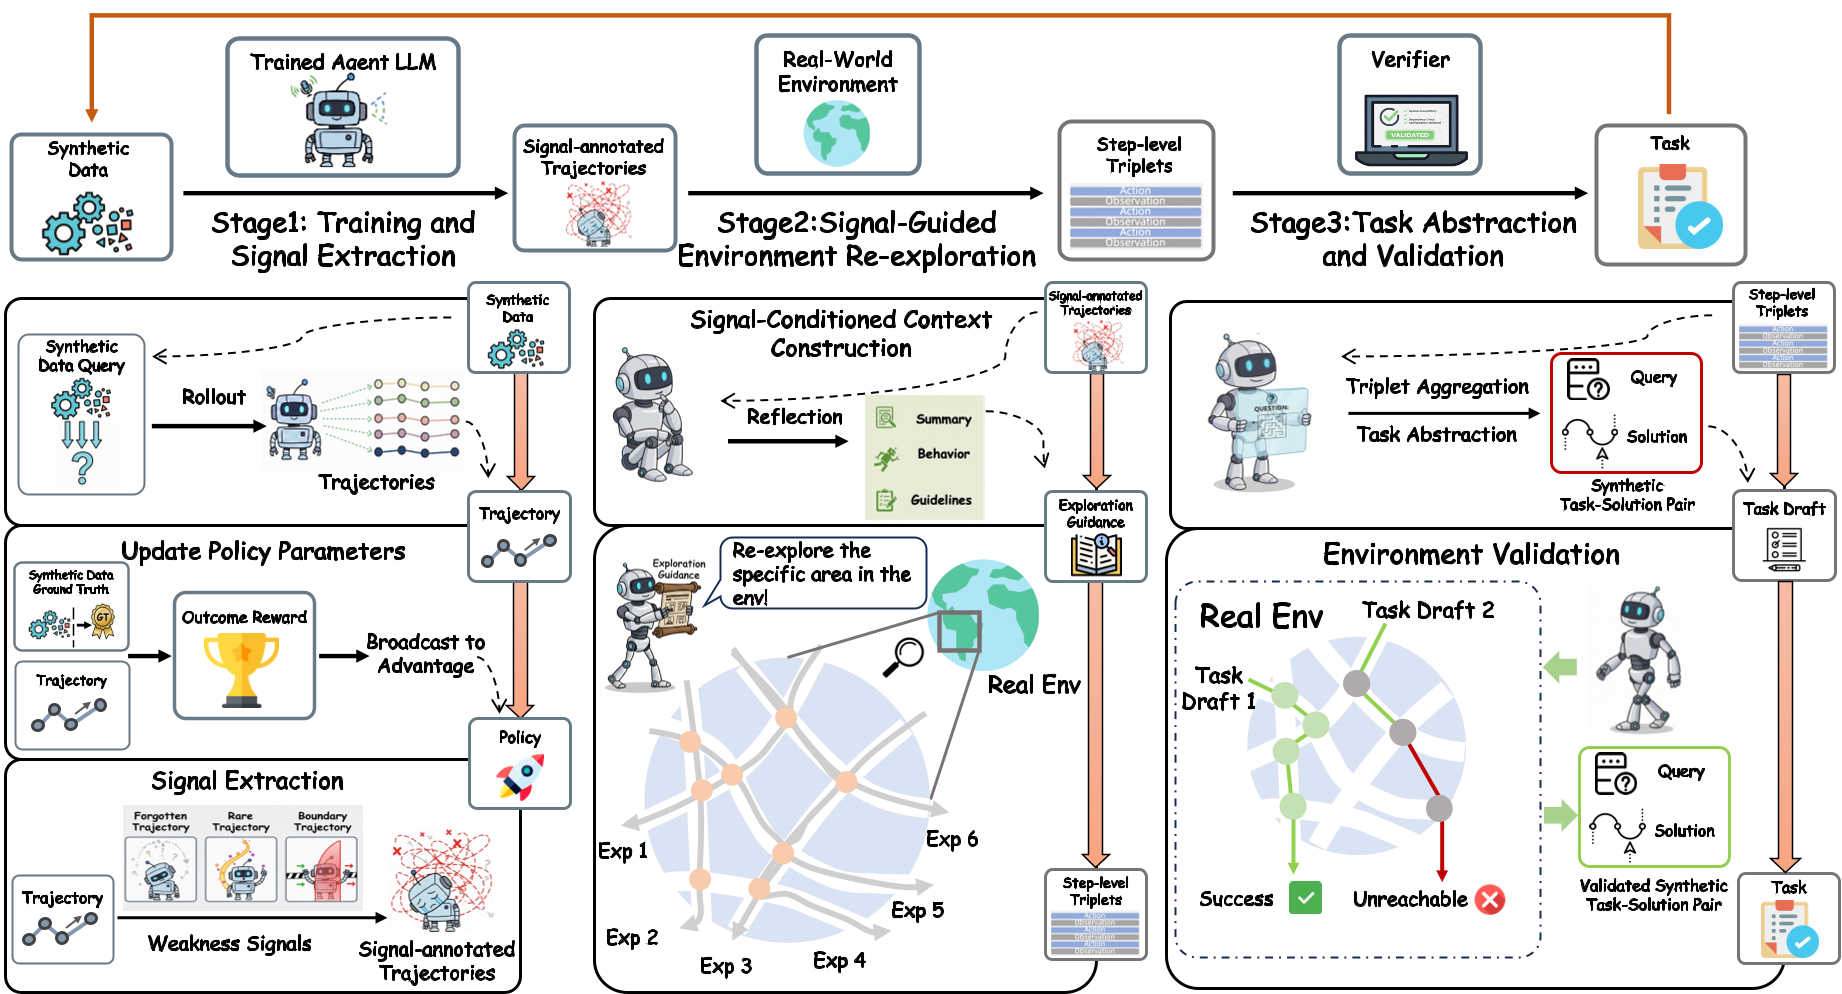
1. 信号驱动的再探索 (Signal-Guided Re-exploration)
一旦在训练过程中识别出上述信号,系统会调用专门的“探索 LLM”对该轨迹进行复盘。它不只是简单的复试,而是基于失败原因生成“探索导引”,指导模型去尝试不同的参数组合或边缘条件。
2. 任务抽象与验证 (Abstraction & Validation)
探索出的原始交互非常杂乱。CoEvolve 会将其通过 LLM 抽象为清晰的“任务描述-解决方案”对,并必须通过真实的环境执行验证(例如真正的 API 调用)。只有执行成功的轨迹,才能被加入“进化训练集”中。
3. 指令微调与策略优化
使用 GRPO (Group Relative Policy Optimization) 算法进行迭代。由于训练数据始终围绕着模型的弱点在更新,梯度的指向性极强,有效避免了在已知领域的重复训练。
实验战绩:小模型的大反扑
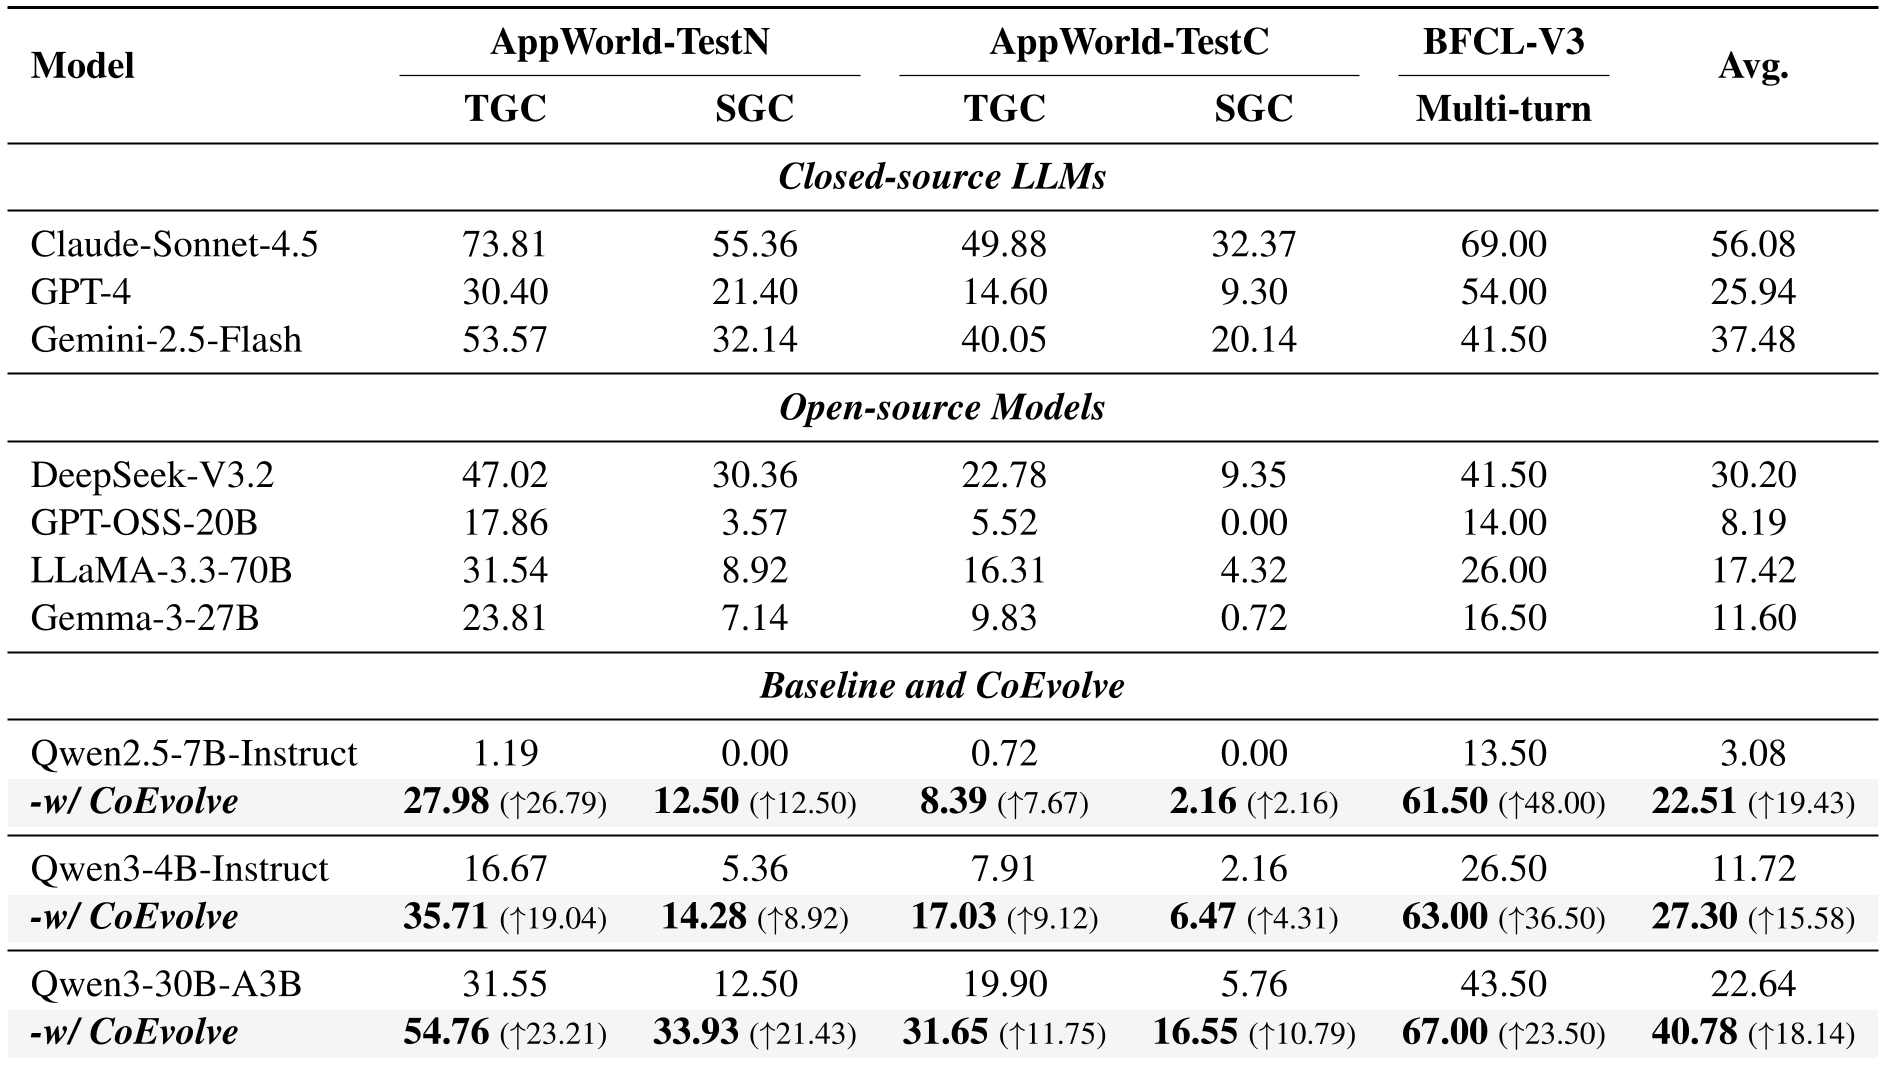
在主流的 Agent 评测集 AppWorld 和 BFCL 上,CoEvolve 展现了惊人的增长曲线:
- 规模溢价:Qwen3-4B 在加入 CoEvolve 训练后,其 function-calling 综合表现不仅超越了多款 70B 开源模型,甚至击败了 GPT-4。
- 稳定性验证:消融实验显示,即便只增加 10% 的额外计算开销,带来的性能增益也远超单纯增加训练步数。
深度洞察:为什么这种做法能行?
传统的 RL 往往陷入局部最优,或者由于数据分布偏移而导致性能崩塌。CoEvolve 实际上是一种自动化的课程学习 (Curriculum Learning)。通过“遗忘信号”查漏补缺,通过“边界信号”细化认知,通过“稀缺信号”开拓眼界。
更重大的意义在于:它降低了对人类专家数据的依赖。在未来,我们可以通过一个极其轻量的模型,在不断自我博弈和环境交互中,通过 CoEvolve 架构“进化”出具备极强鲁棒性的行业专家。
局限性与未来
尽管表现卓越,论文也指出:在训练初期模型极度不成熟时,产生的反馈信号可能存在大量噪声。未来的方向在于引入更稳健的安全过滤器以及跨领域迁移能力,防止 Agent 在自我进化的过程中“走火入魔”(偏离安全或业务逻辑边界)。
总结:CoEvolve 证明了 Agent 的智能不仅在于参数规模,更在于它与环境、与数据交互的深度和反馈闭环的质量。