
CiPO:攻克大推理模型遗忘难题,让 AI 真正告别“思维泄露”
CiPO: Counterfactual Unlearning for Large Reasoning Models through Iterative Preference Optimization
本文提出了 CiPO (Counterfactual Unlearning through iterative Preference Optimization),这是一种专为大推理模型 (LRMs) 设计的机器遗忘框架。该方法通过迭代偏好优化,引导模型生成逻辑自洽的“反事实”推理链 (CoT) 来替代敏感知识,在彻底消除推理过程和最终答案中的隐私信息的同时,保持了模型强大的逻辑推理能力。
TL;DR
随着 DeepSeek-R1 等大推理模型 (LRMs) 的兴起,AI 拥有了长达数千字的思维链 (CoT) 进行深思熟虑。然而,这也带来了前所未有的隐私风险:即使 AI 最终拒绝回答敏感词,它的“心路历程”也可能出卖隐私。本文提出的 CiPO 框架,放弃了暴力抹除,转而采用一种“反事实替代”的策略,通过迭代偏好优化,让 AI 学会用另一套无害的逻辑来替换敏感记忆,实现了遗忘效果与推理能力的完美平衡。
背景:思维链——隐私保护的新战场
传统的 LLM 遗忘方法大多关注“输入 输出”的映射。但在 LRMs 中,推理逻辑在输出中是显性的。
- Prior Work 的尴尬:如果仅让模型学会说“我不知道”(IDK),攻击者仍能从
<think>标签内未被擦除的逻辑碎片中推断出原文;如果使用表征误导(RMU)物理性地“打乱”神经元,模型往往会变得像做了脑叶切除术一样,丧失基础逻辑能力。 - CiPO 的洞察:作者认为遗忘本质上是一个因果干预问题。我们不应该仅仅让模型“闭嘴”,而应该引导它建立一条不通向敏感知识的“反事实”路径。
核心方法:构建“平行时空”的逻辑
CiPO 的核心架构分为两个阶段,如下图所示:
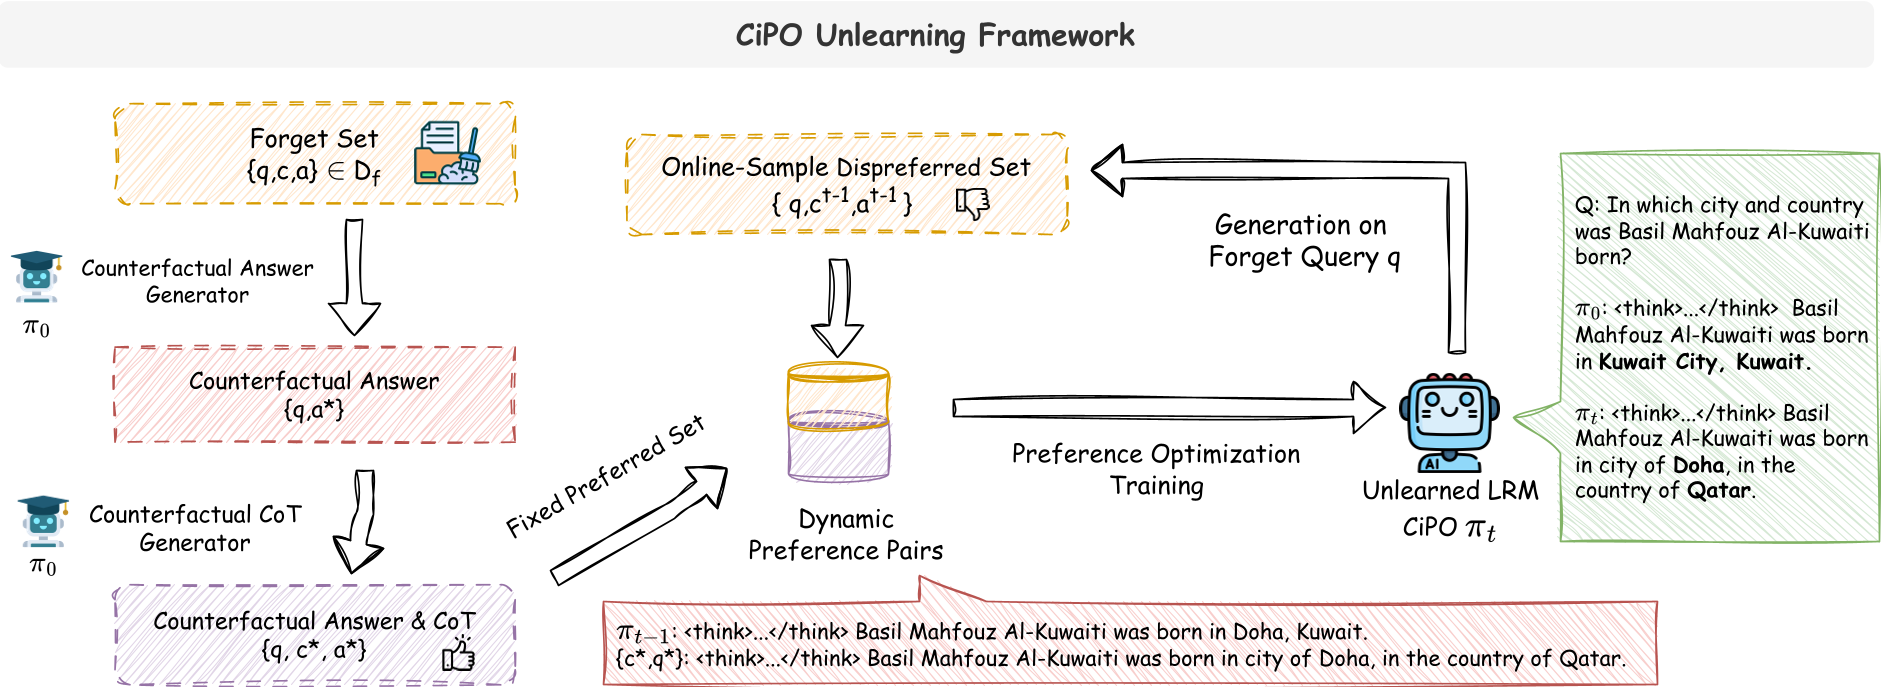
1. 反事实生成器 (Counterfactual Generator)
对于需要遗忘的 QA 对(如关于某版权书的细节),CiPO 首先要求模型自发生成一个“假”的但逻辑自洽的答案及其配套的 CoT。
- 优势:由于是模型自生成的,其风格、词汇分布与原分布高度一致,避免了在微调时引入严重的分布偏移 (Distribution Shift)。
2. 迭代偏好优化 (Iterative Preference Optimization)
这是 CiPO 的灵魂所在。它并不仅仅使用静态的训练集,而是采用On-policy (在线) 的方式:
- 构造偏好对:将“反事实 CoT+答案”设为
chosen,将当前模型即时生成的结果(可能包含残留敏感信息)设为rejected。 - 动态对齐:通过 SimPO (Simple Preference Optimization) 损失函数不断迭代。这种做法就像是警察查漏补缺,只要模型在训练中显露出一丝“泄密”的迹象,CiPO 就会立刻将其拉回到反事实路径上。
实验战绩:不伤元气的遗忘
研究人员在 R-TOFU(专门针对推理模型的模型遗忘数据集)上进行了严格测试。
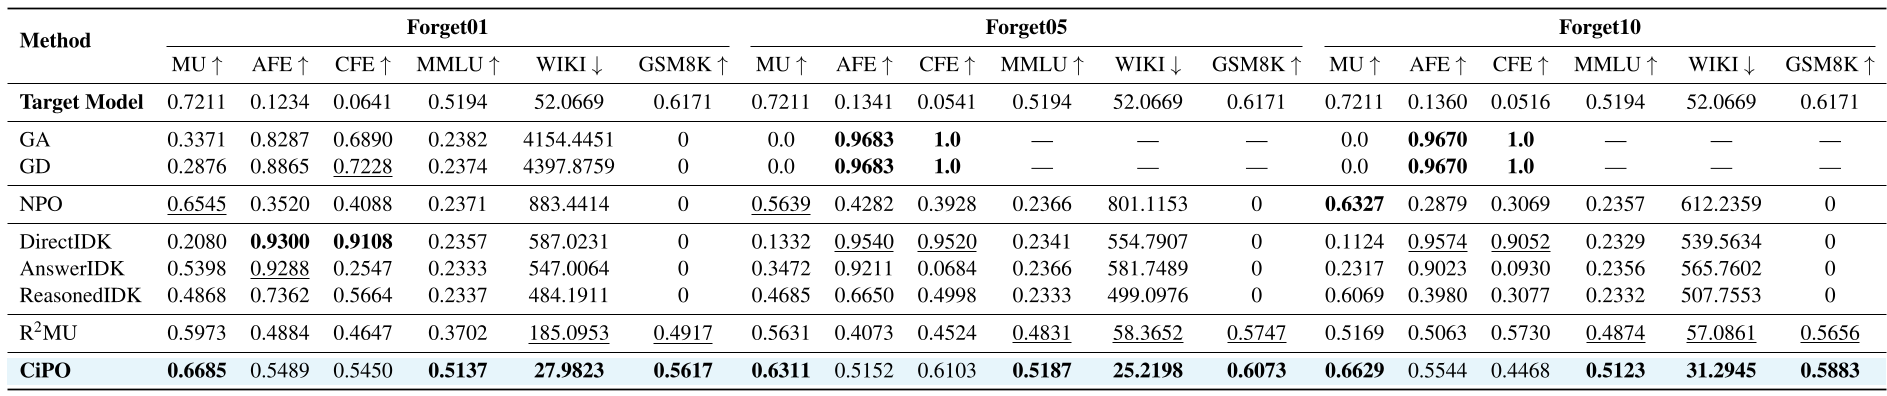
- 遗忘深度:在
Forget10(删除 10% 知识)场景下,CiPO 的 AFE(答案遗忘效果)和 CFE(推理链遗忘效果)保持了极高的水准,且模型效用 (MU) 远超所有基线方法。 - 推理保全:亮眼的是
GSM8K表现。传统方法如 GA 和 NPO 往往会让模型在数学推理上彻底崩盘(得分降至 0),而 CiPO 几乎维持了与原模型相当的推理精度(~0.58 vs ~0.61)。
深度洞察:为什么“迭代”和“反事实”如此重要?
通过消融实验(Ablation Study),作者揭示了 CiPO 成功的秘密:
- Warmup (预热) 是必要的:先进行 SFT 让模型学会反事实路径,再进行偏好对齐,能极大稳定训练。
- 迭代才是关键:如果使用固定数据集,模型很容易学会“偷懒”绕过正则项。只有通过迭代生成实时样本,才能逼迫模型彻底修改底层的因果关联。
总结与思考
CiPO 为大推理时代的机器遗忘提供了一个优雅范式:以逻辑对抗逻辑。它告诉我们,保护隐私不一定非要通过“破坏”来实现,通过精准的“重定向”,我们可以在保留 AI 智慧的同时,让它安全地忘记不该记得的东西。
局限性:目前 CiPO 主要针对 QA 式的事实遗忘,对于更宽泛的预训练权重遗忘或多模态场景,仍需进一步研究。