
[CVPR 2026] ESTF-SSM:利用非对称 Mamba 架构突破长视频动作检测瓶颈
Efficient Spatial-Temporal Focal Adapter with SSM for Temporal Action Detection
本文提出了 ESTF-SSM,一个针对时序动作检测(TAD)的新型架构。该方法通过引入 Efficient Spatial-Temporal Focal (ESTF) Adapter 和 Temporal Boundary-aware SSM (TB-SSM),在保持线性计算复杂度的同时,显著提升了长视频序列中的全局依赖建模与动作边界定位精度。
TL;DR
时序动作检测(Temporal Action Detection, TAD)一直以来都在“长序列全局建模”与“计算效率”之间挣扎。本文提出的 ESTF-SSM 框架,通过参数高效的 ESTF Adapter 和创新的 TB-SSM (Temporal Boundary-aware SSM) 模块,成功在保持 线性复杂度的前提下,提升了动作边界的定位精度。在 THUMOS14 等主流榜单上,它以更低的显存消耗刷新了 SOTA 纪录。
1. 痛点:Transformer 的重负与 SSM 的平滑诱惑
在 TAD 任务中,我们需要在长达数分钟的未经剪辑视频中精准找到动作的“秒级”起止点。
- Transformer 的困境:自注意力机制的二次方复杂度使其在处理高帧率、长视频时捉襟见肘,且容易产生特征冗余。
- SSM 的局限:虽然 Mamba 等状态空间模型带来了线性效率,但其本质上的“全局聚合”特性容易导致特征过度平滑(Oversmoothing)。对于 TAD 而言,动作的起始(Onset)和结束(Offset)通常具有不同的视觉模式,简单的双向参数共享 SSM 难以捕捉这种非对称的边界细节。
2. 核心贡献:ESTF Adapter 及其非对称动力学
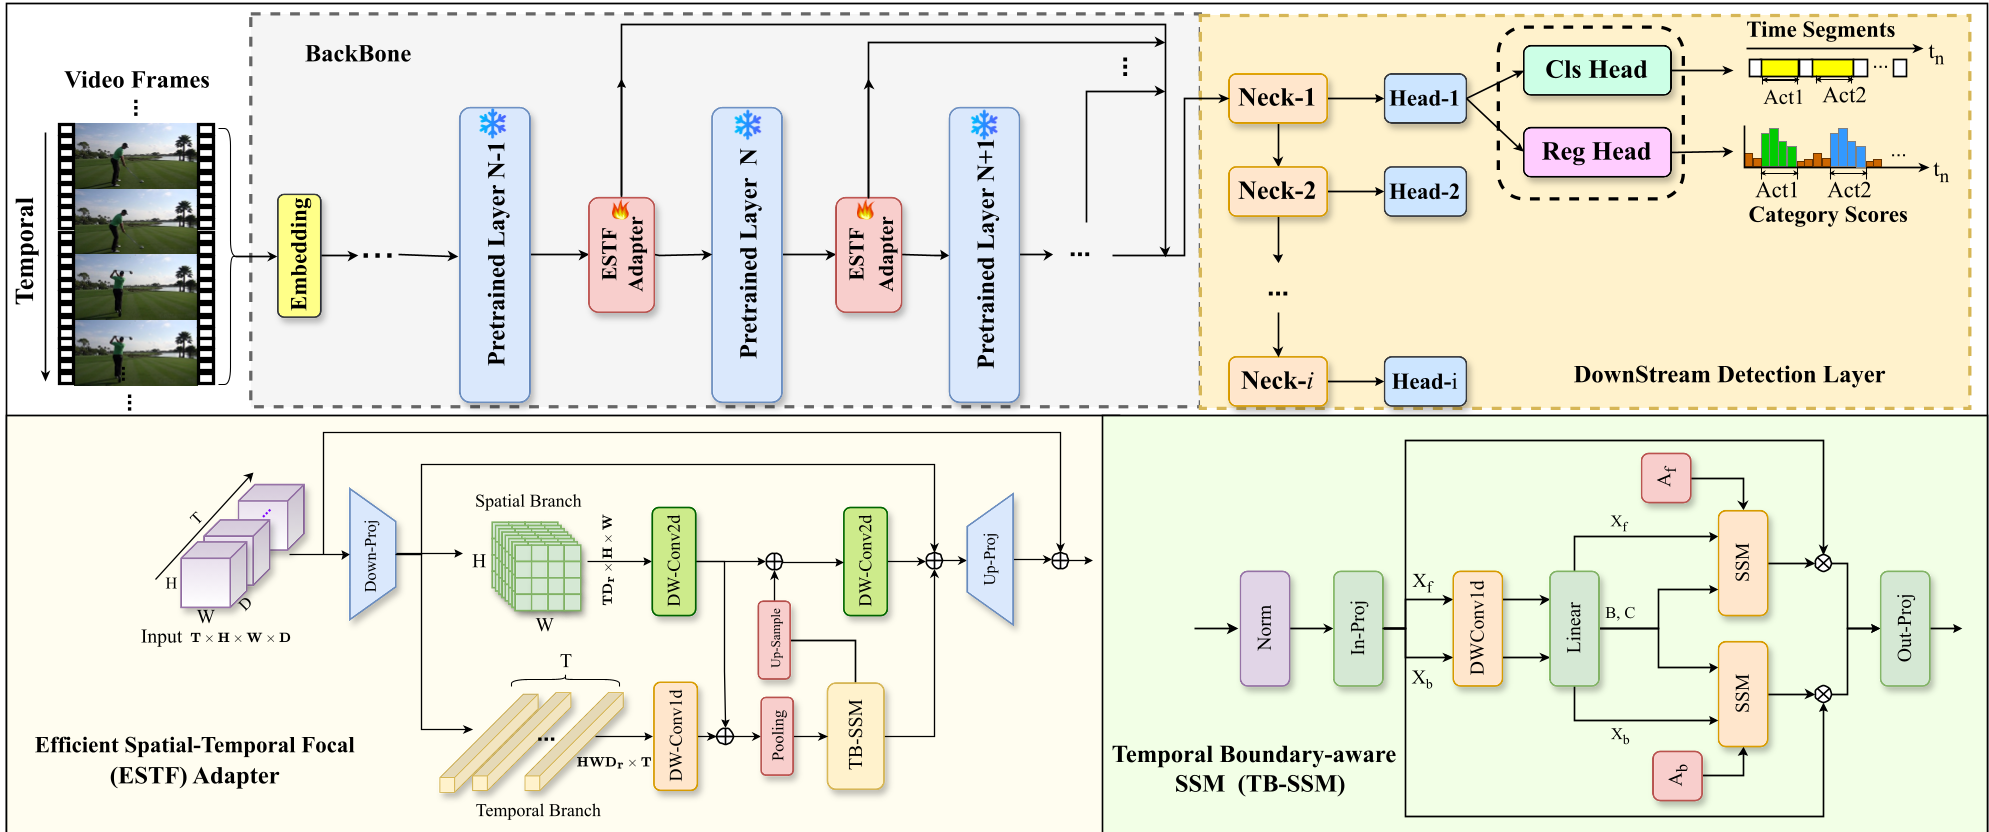
为了解决上述问题,作者在预训练的视频 Backbones 中嵌入了 Efficient Spatial-Temporal Focal (ESTF) Adapter。
2.1 解耦的空间-时序建模
ESTF 模块并没有简单地进行时序堆叠,而是采用了空间与时序解耦的策略:
- 空间分支:使用深度可分离卷积(DWConv)提取局部结构线索。
- 时序分支:引入 TB-SSM 捕捉长程依赖。
- 交互融合:通过上采样与特征加和,使空间细粒度信息指导时序建模,有效缓解了全局建模带来的边界模糊。
2.2 边界感知:TB-SSM 的物理直觉
这是本文最精妙的设计。作者认为动作的发生具有方向性,因此提出了 Temporal Boundary-aware SSM。
- 独立状态转换矩阵:针对前向(Forward)和后向(Backward)扫描,模型通过参数化不同的转换矩阵 和 来学习不同的动力学特征。
- 逻辑含义:前向扫描更关注动作如何从背景中“浮现”,而后向扫描则擅长捕捉动作如何“消退”至背景。这种非对称的电荷式状态更新,为边界回归提供了更强的感官归纳偏置(Inductive Bias)。
3. 实验结果:效率与精度的平衡艺术
在 THUMOS14、ActivityNet-1.3 和 Charades 三大数据集上,ESTF-SSM 均表现出极强的竞争力。
3.1 量化战绩
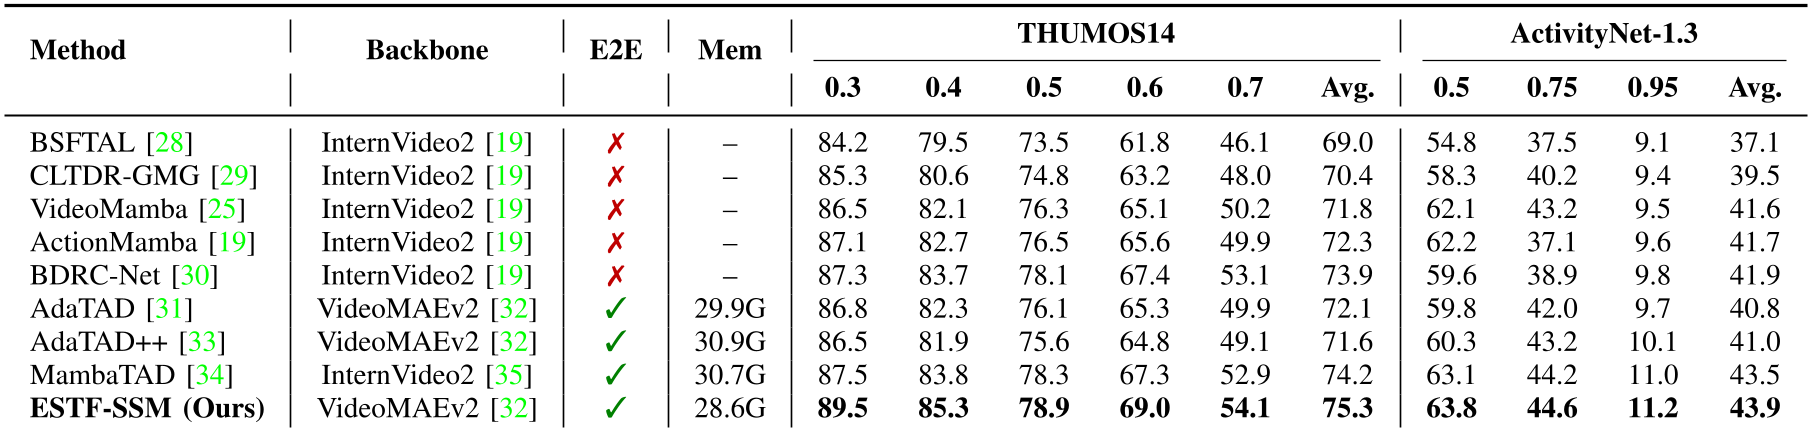
在 THUMOS14 上,ESTF-SSM 的平均 mAP 达到了 75.3%。值得注意的是,在较高的 tIoU 阈值(如 0.7)下,性能提升尤为显著,这有力证明了 TB-SSM 在精确定位上的优势。
3.2 低资源消耗
在端到端(E2E)训练设置下,即便配合强大的 VideoMAEv2 Backbone,ESTF-SSM 的显存需求仅为 28.6G,低于传统的 Transformer 变体及其他 SSM 改进版,展现了极佳的工业应用潜力。
4. 深度洞察与总结
为什么有效? ESTF-SSM 的成功在于它精准捕捉到了视频动作检测的物理本质:动作不是对称的。通过在 复杂度的 SSM 中引入非对称参数,它既规避了 Transformer 的计算黑洞,又通过 Focal 设计克服了传统 SSM 的平滑软肋。
局限性与展望 虽然在离线检测上表现卓越,但该方法目前仍基于全局扫描,如何在**在线动作检测(Online Action Detection)**中实时应用非对称 SSM 仍是一个开放课题。此外,将这种边界感知的 Adapter 推广到多模态(如音频驱动的动作定位)将是极具前景的方向。
Takeaway:ESTF-SSM 不仅是一个更强的 TAD 模型,它也为我们提供了一个冷思考:在追求全局建模的同时,不要忘记时序特征在细粒度边界上的异质性与非对称性。