
EMF:打破步数魔咒,让 MeanFlow 真正读懂文本
Extending One-Step Image Generation from Class Labels to Text via Discriminative Text Representation
本文提出了 EMF (Extending MeanFlow to T2I),首次将基于 MeanFlow 的一步生成技术从简单的类别标签扩展到了复杂的文本条件成像。通过集成强大的 LLM 文本编码器,该方法在保持高语义保真度的同时,实现了极速的图像合成。
TL;DR
在 AI 绘画领域,“一步成像”始终是效率提升的终极梦想。然而,现有的 MeanFlow 框架在面对复杂的文本描述(Text-to-Image)时往往“反应迟钝”,容易漏画物体或理解错语义。本文提出的 EMF 成功破解了这一难题,通过增强文本表示的判别性与解耦性,让模型在 1-4 步内就能生成媲美 30 步迭代的高质量大片,推理速度提升超 10 倍。
痛点深挖:为什么“一步到位”这么难?
传统的扩散模型(Diffusion Models)像是一个细致的画家,需要几十步精雕细琢。MeanFlow 的出现本是为了通过预测“平均速度”来一蹴而就,但它在处理文本时遇到了物理直觉上的挑战:
- 语义漂移:类别标签(如“猫”)在空间中是离散且好区分的,但文本(如“蓝色茶壶”与“红色茶壶”)在表征空间中离得极近。在只有 1 步的采样中,模型极易由于区分度不够而“跑偏”。
- 轨迹曲率:复杂文本导致的生成轨迹非常扭曲。如果文本编码器不够强大,模型无法准确估算平均速度,导致第一步“起笔”就画错了。
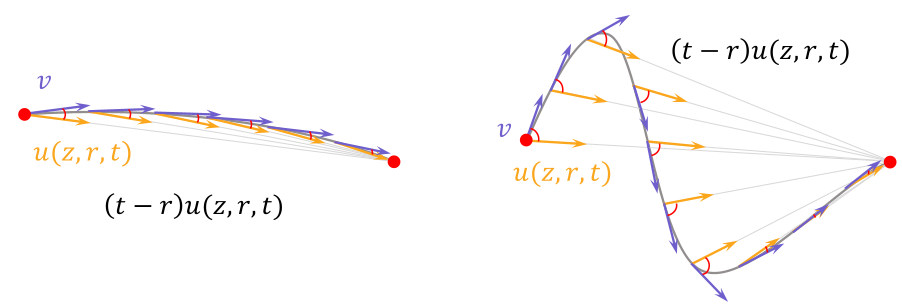 上图展示了直觉差异:类别标签驱动的轨迹(左)平滑易测,而复杂文本驱动的轨迹(右)弯曲复杂。
核心算法:判别性表征的力量
作者发现,MeanFlow 能否成功的关键在于 Text Encoder 的素质。他们提出了两个核心指标:
- Discriminability(判别性):文本特征必须能精准对应图像特征(跨 modal 对齐)。
- Disentanglement(解耦性):长文本中的不同属性(颜色、位置、物体)不能揉成一团,必须清晰可分。
通过实验发现,基于 LLM(如 BLIP3o-NEXT)的编码器在这些指标上远超 T5 或 CLIP。
架构升级
为了适配文本条件,EMF 对 MeanFlow 的时间嵌入层进行了改造:
- 时间编码重构:不再只传入当前时间 ,而是同时注入时间间隔 和终点时间 ,帮助模型更好地理解它要在这一步跨越“多长的路”。
- JVP 优化:利用 Jacobian-vector products 高效计算速度场导数,确保训练稳定性。
实验战绩:少即是多
在最具代表性的 GenEval(关注物体数量、颜色、位置的准确性)评测中,EMF 表现惊人:
- 4 步性能:0.90 分,直接叫板 30 步的基准模型(0.91)。
- 1 步性能:0.74 分,远超此前所有的蒸馏模型(如 SDXL-Turbo 的 0.56)。
 实验数据证明,EMF 在 1 步和 2 步时的领先优势是断层式的。
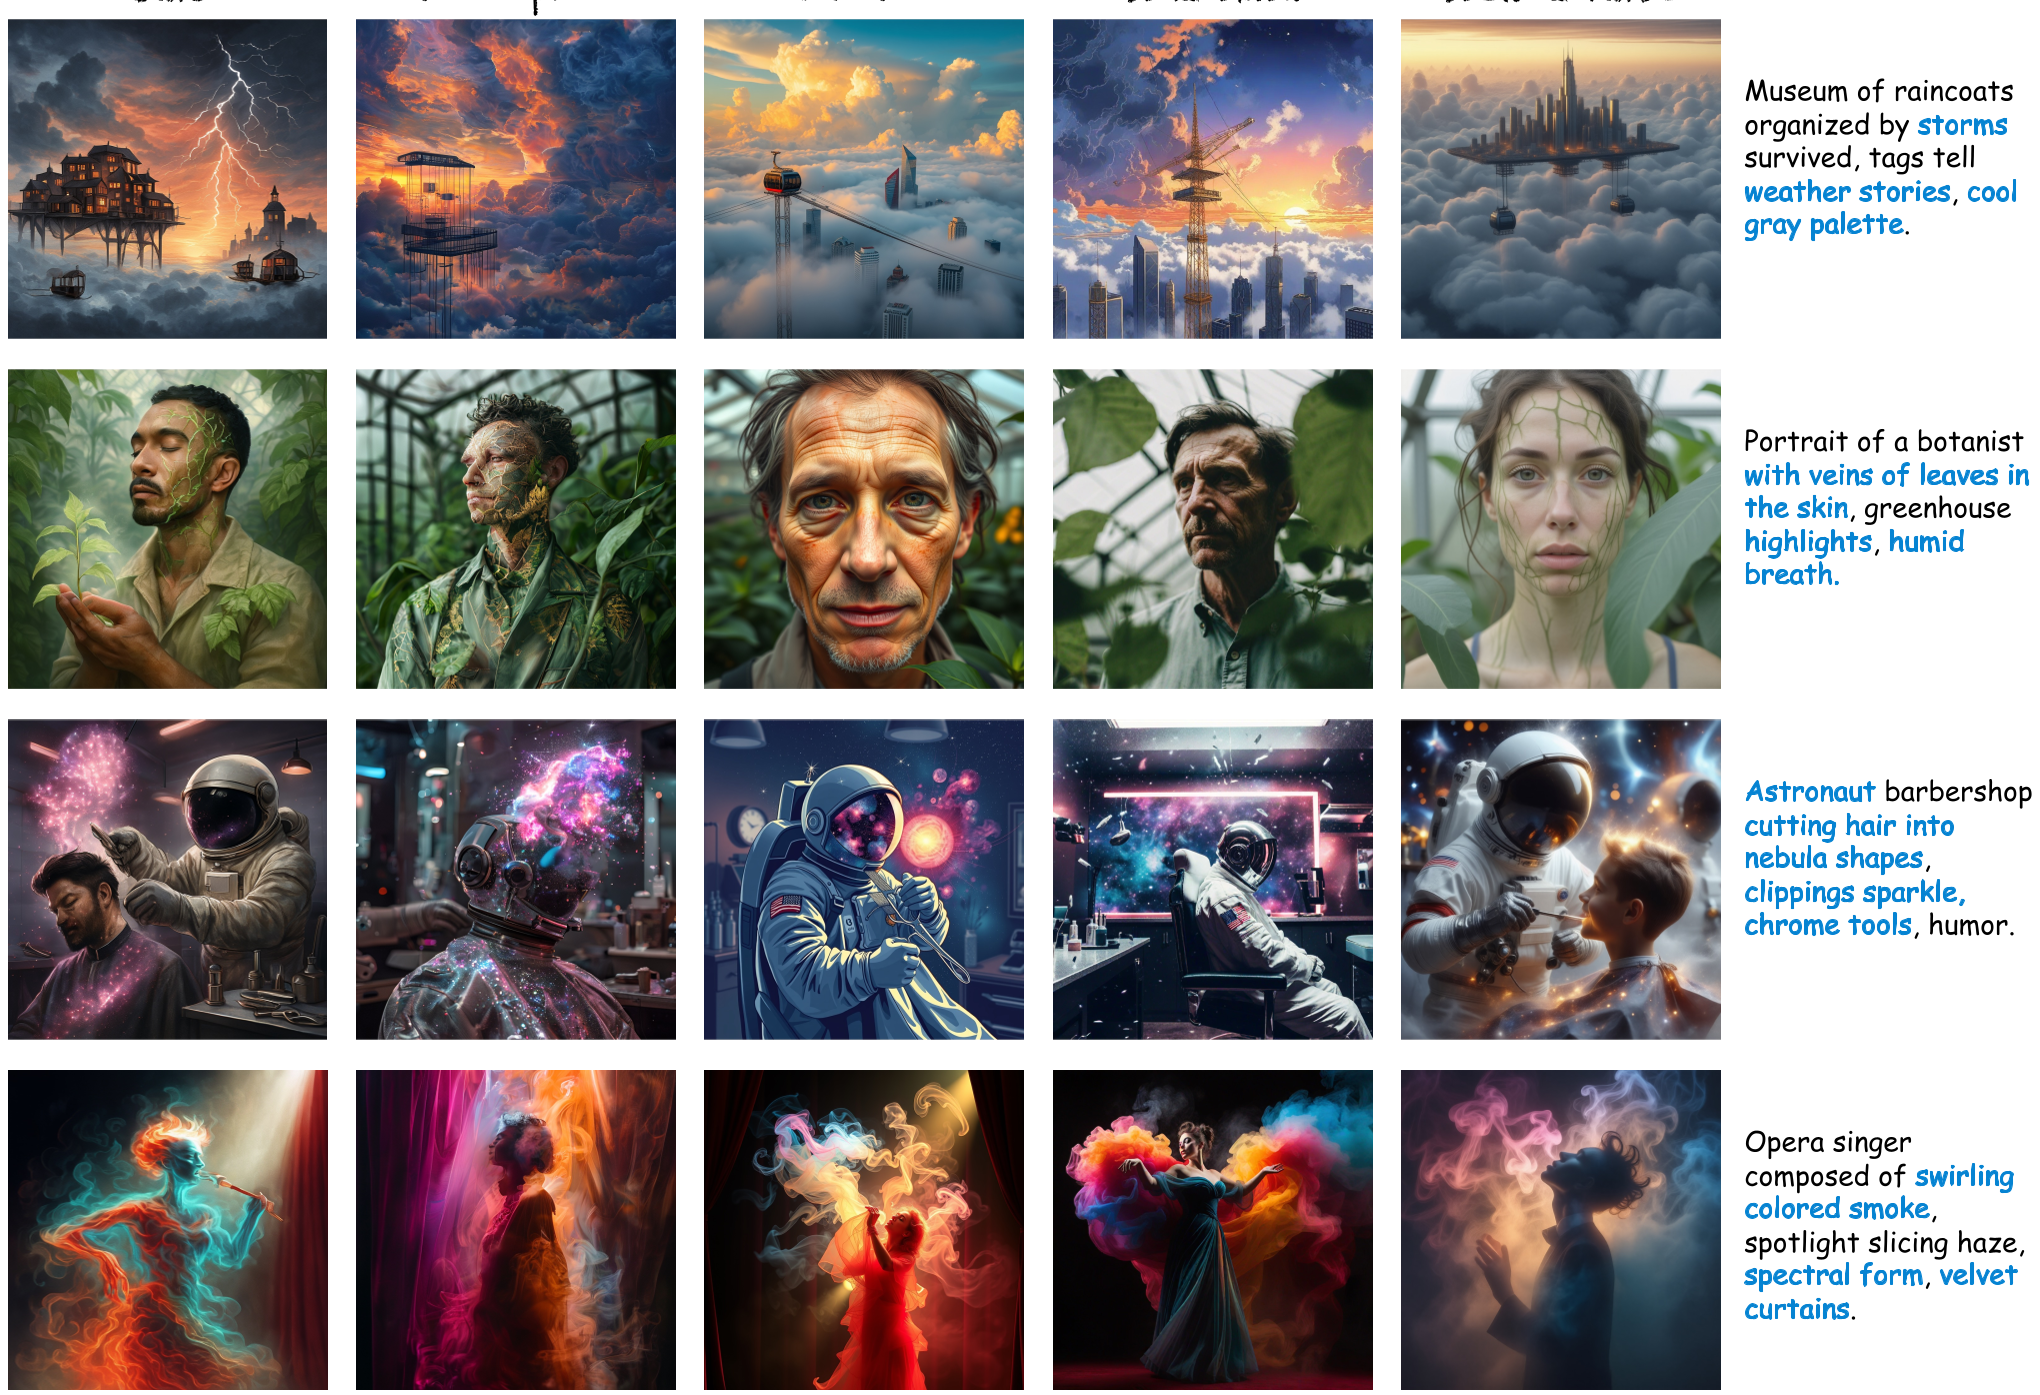
可视化对比更能说明问题:在处理复杂的长提示词时,EMF 的 4 步结果比其他加速模型(如 SANA-Sprint)更贴合指令,没出现漏画物体的情况。
深度洞察与总结
EMF 的成功说明了:在生成式任务中,前端编码器的“认知深度”直接决定了后端生成器的“执行效率”。 传统的蒸馏方法通过牺牲质量换取速度,而基于 MeanFlow 的方法则是在优化生成路径的本质。
局限性:虽然 4 步已经很强,但在极致的 1 步生成下,图像的细节纹理仍有提升空间。 未来展望:这种“高质量表征引导少步生成”的思路,极有可能会成为视频生成(Video Generation)领域解决渲染成本过高问题的标准答案。