
概率只在你的脑海中:贝叶斯因子如何作为物理定律的“奥卡姆剃刀”?
It's all in your head -- fine-tuning arguments do not require aleatoric uncertainty
本文由 Andrew Fowlie 撰写,探讨了理论物理中“自然性(Naturalness)”争论的统计学基础。文章指出,贝叶斯推断中自动存在的“奥卡姆剃刀(Automatic Occam's Razor)”足以惩罚需要精细调节(Fine-tuning)的非自然模型,且这一过程仅依赖认识论不确定性(Epistemic Uncertainty)。
TL;DR
在理论物理和机器学习中,我们常说“越简单的模型越好”。但这仅仅是审美偏好吗?Andrew Fowlie 的最新综述论文指出:自然性论证(Naturalness arguments)完全建立在贝叶斯概率的认识论基础上。 你不需要上帝掷骰子,也不需要多元宇宙,只要你承认对参数的“无知”,贝叶斯推断就会自动通过“奥卡姆剃刀”机制剔除那些过度精细调节的复杂模型。
背景:自然性之争
自 1980 年代以来,“自然性”一直是粒子物理学的核心指导原则。一个“自然”的理论不应该要求参数被精确地调节到小数点后几十位才能与实验吻合。然而,随着大型强子对撞机(LHC)未发现预言中的新粒子,诸如 Sabine Hossenfelder 等学者开始质疑这一原则,认为它只是物理学家的“审美执念”。
本文的核心洞察是:这种质疑源于对概率本质的误解。
核心机制:自动奥卡姆剃刀 (Automatic Occam's Razor)
1. 认识论 vs 偶然性
作者借用统计学大师 de Finetti 的观点——“概率并不存在(客观实体上)”,强调概率是描述我们缺乏知识(Epistemic)的工具,而非必须基于物理上的随机过程(Aleatoric)。即使宇宙是决定论的,只要我们不知道参数的确切值,使用概率分布就是科学且严谨的。
2. 证据稀释效应 (Evidence Dilution)
为什么贝叶斯推断会偏好简单模型?
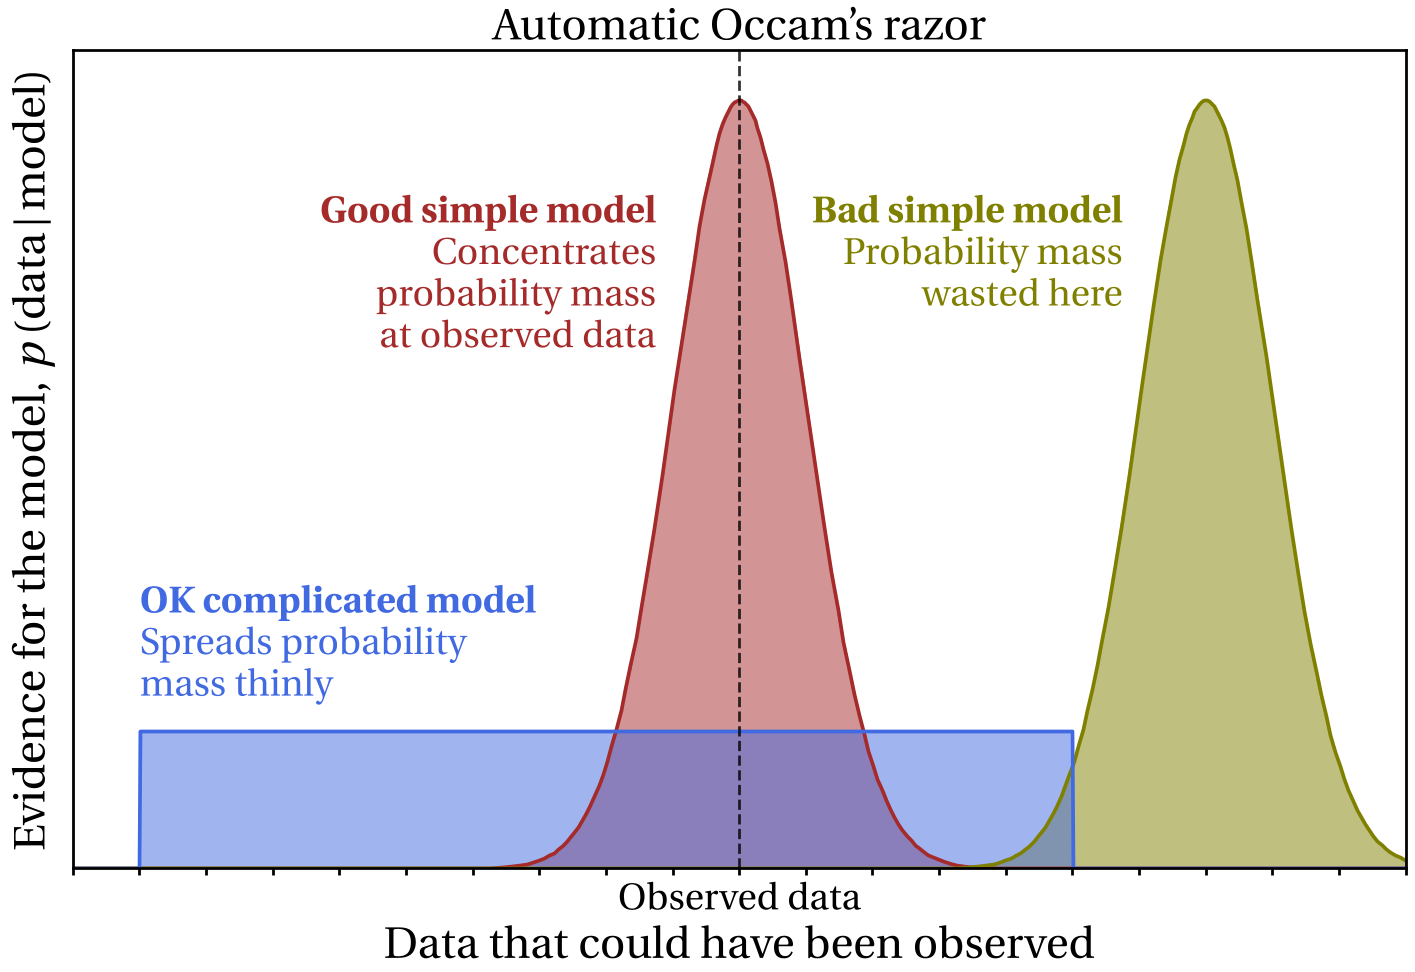 图 1:MacKay 展示的自动奥卡姆剃刀原理。简单模型()的预测集中在狭窄区域;复杂模型()因为参数空间大,将其预测能力“稀释”到了广阔的区域。当数据落在 的峰值附近时, 胜出。
这就是 Evidence (Z) 的力量。在贝叶斯框架下,证据是对参数进行积分所得: 一个复杂的模型如果不必要地扩大了参数空间 ,就会在积分中由于“分母过大”而被惩罚。
实验演示:自由落体与分层问题
案例 1:自由落体
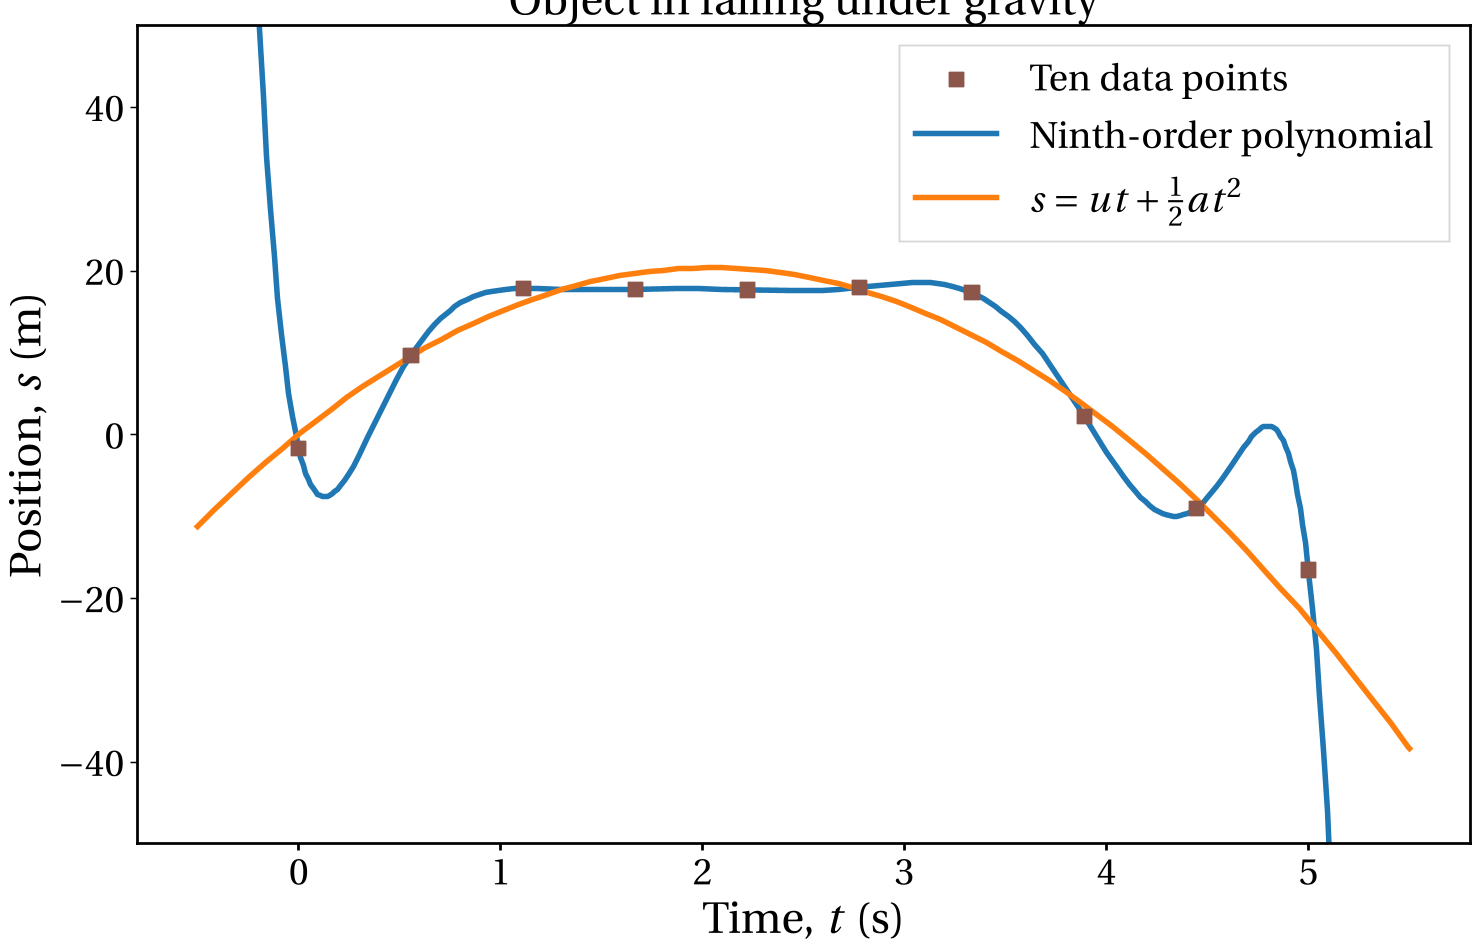
作者通过一个简单的抛物线公式 vs 九次多项式的例子重申了 Jeffreys (1961) 的观点。虽然九次多项式可以完美拟合 10 个数据点(Loss 为 0),但贝叶斯因子会因为其巨大的预测不确定性而坚决支持二次项公式。
案例 2:物理学中的分层问题
这是本文的重头戏。作者对比了两个模型:
- (自然模型):
- (非自然模型): (其中 是极大的普朗克尺度)
在 中,为了得到观测到的 (约 100 GeV), 必须被极其精确地设为接近 的值。计算结果显示,贝叶斯因子对 的惩罚因子高达 倍。
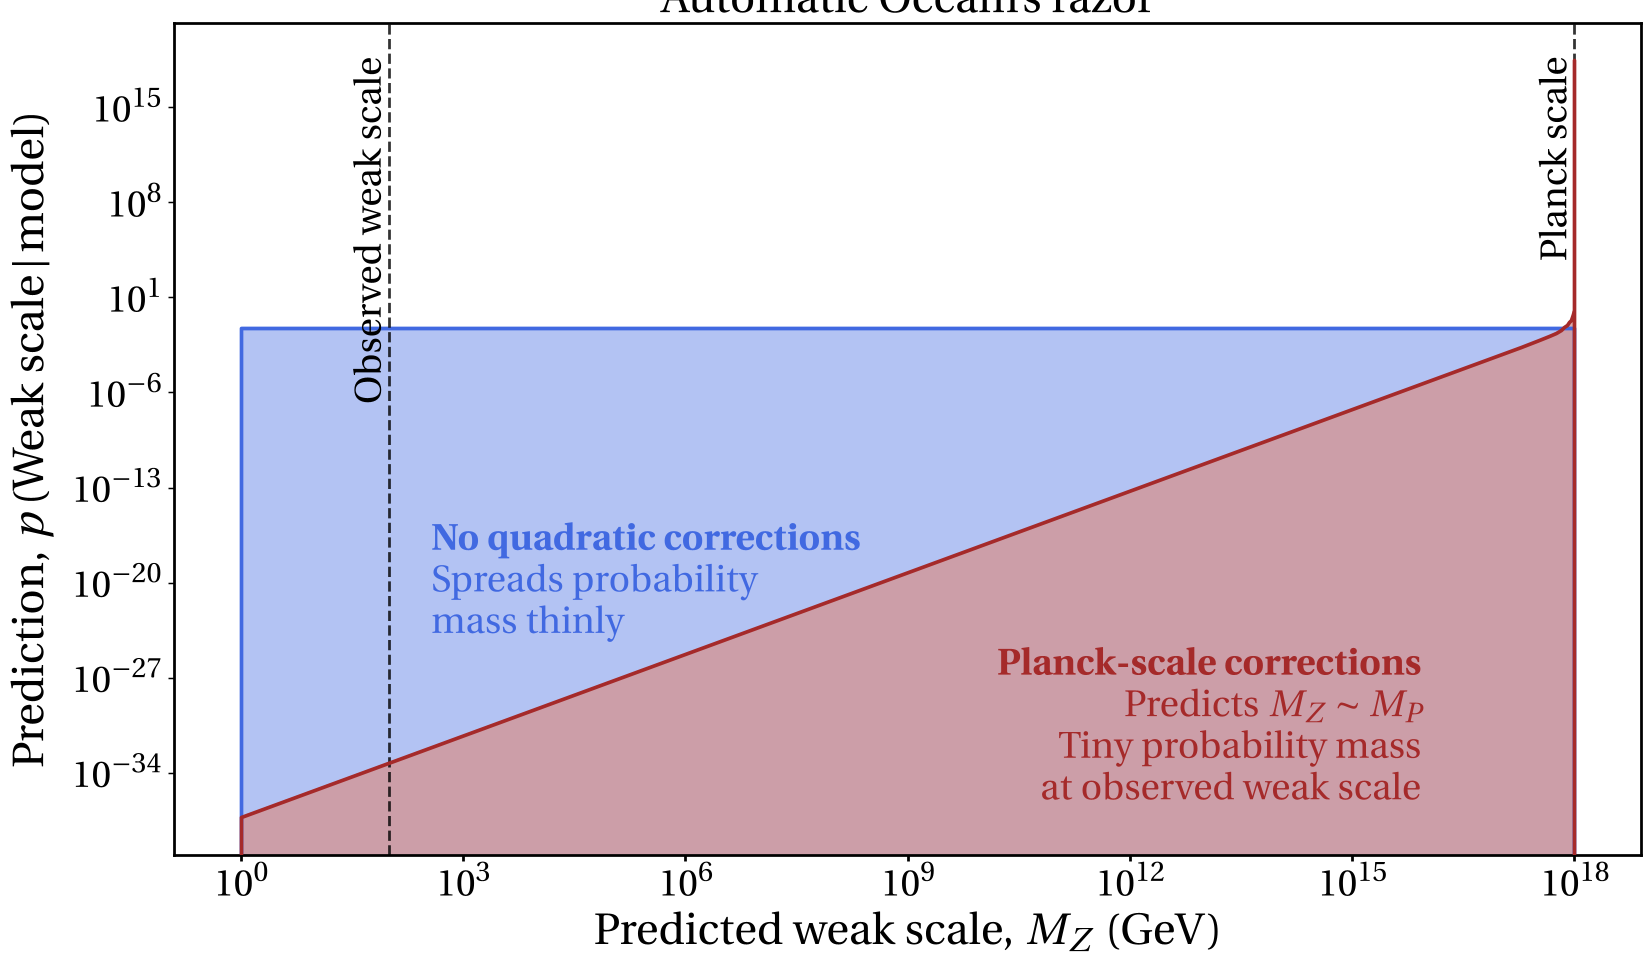 图 2:包含二次修正的模型(红色)预测的弱电量级倾向于出现在普朗克尺度附近,而观测值(虚线)处于极低概率区,显式展现了“非自然性”。
深度洞察:反驳 Hossenfelder 与 Wells
针对 Hossenfelder (2019) 提出的“概率分布向理论添加了不必要的额外结构”这一观点,Fowlie 犀利地反驳:概率分布是在你脑子里的,不是在能量方程里的。
- 它不属于理论的本体(Ontology)。
- 它是推断过程的必要组件,而非物理实体。
- 忽略概率分布而只谈模型敏感度,相当于在统计学中“蒙眼狂奔”。
总结与展望
本文精辟地论证了,所谓的“自然性”不是一种玄学审美,而是贝叶斯逻辑在处理不确定性时的必然产物。
Takeaway for Techies: 无论是在物理建模还是深度神经网络的架构选择中,如果你发现必须通过极度精细的超参数调节(Fine-tuning)才能让模型收敛,那么贝叶斯原理告诉我们:你的模型架构可能本身就背离了“自然性”,它在泛化性上的失败已经命中注定。
未来的研究或许能进一步将这种“自动奥卡姆剃刀”量化为 AI 模型搜索的直接 Loss 函数,从而真正实现物理直觉与统计推断的逻辑闭环。