
为什么微调会助长幻觉?从持续学习视角揭秘 SFT 的“事实遗忘”与修复方案
Why Fine-Tuning Encourages Hallucinations and How to Fix It
本文提出将 SFT 诱导的幻觉视为持续学习中的“事实遗忘”现象,并证明了通过自我蒸馏(Self-Distillation)或选择性参数冻结可以显著缓解这一问题。在 Qwen 和 Llama 系列模型上的实验表明,该方法能将事实遗忘率从约 15% 降低至 3%,同时保持对新知识的获取能力。
TL;DR
在 LLM 的标准 SFT(监督微调)过程中,模型往往在学会新知识的同时,丧失了预训练阶段掌握的“旧知识”,从而导致严重的幻觉。本文研究发现,这并非模型容量不足,而是因为新旧事实在参数空间存在语义重叠干扰。通过引入自我蒸馏 (Self-Distillation) 或选择性冻结 FFN 层,我们可以将这种事实遗忘从 15% 降至 3%。
1. 痛点:鱼和熊掌不可兼得?
大语言模型在部署前通常要经过 SFT 阶段以对齐指令或注入领域知识。然而,开发者常发现模型在 SFT 后性能虽然提升了,但在一些基础常识上开始“一本正经地胡说八道”。
作者通过 SLiCK 方法将知识分为:
- HighlyKnown: 模型本身已经滚瓜烂熟的知识。
- Unknown: 模型从未见过的新知识。
实验结果令人沮丧:随着模型学会新知识(DUnk 准确率上升),原本掌握得很好的知识(DHeld)准确率却显著下降。这种现象在持续学习领域被称为灾难性遗忘 (Catastrophic Forgetting)。
2. 核心洞察:语义重叠是罪魁祸首
为什么会遗忘?作者提出了三种假设:
- 容量限制:模型存不下了(已被否定)。
- 行为克隆:模型学会了“强制回答”的坏习惯(部分影响)。
- 结构性干扰:新事实的表示扰动了邻近的旧事实表示。
为了验证第三点,作者做了一个精妙的实验:
- 语义 Key 组:用类似于真实地名的名字(如 Bergadena)训练新事实。
- UUID Key 组:用随机乱码(如 Loc_fcfb42)训练。
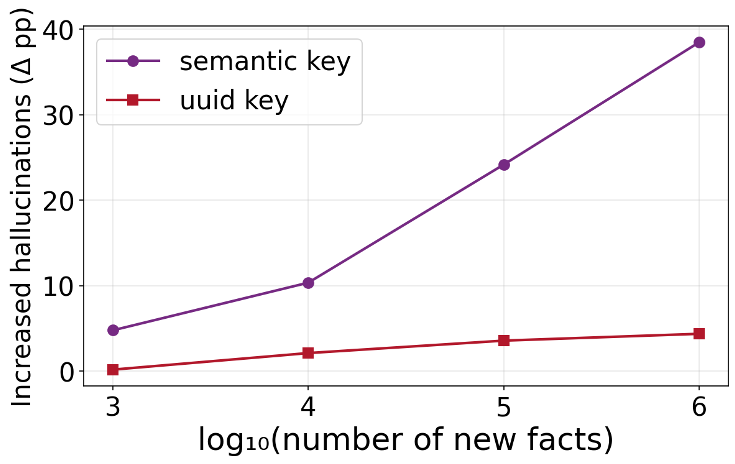
结果显示:UUID 组即使训练 100 万条新事实,旧知识也几乎不掉点;而语义组则迅速崩坏。这证明了当新内容在语义空间与旧内容邻近时,梯度的更新会强行“挤占”或扭曲原有的流形结构。
3. 解决方案:给参数加个“紧箍咒”
方案 A:自我蒸馏 (Self-Distillation)
当我们需要模型学习新知识时,这是最佳方案。在 SFT 的 Loss 中加入一个 KL 散度项,让微调中的“学生”模型在输出分布上不要偏离“老师”(微调前的时刻)太远。
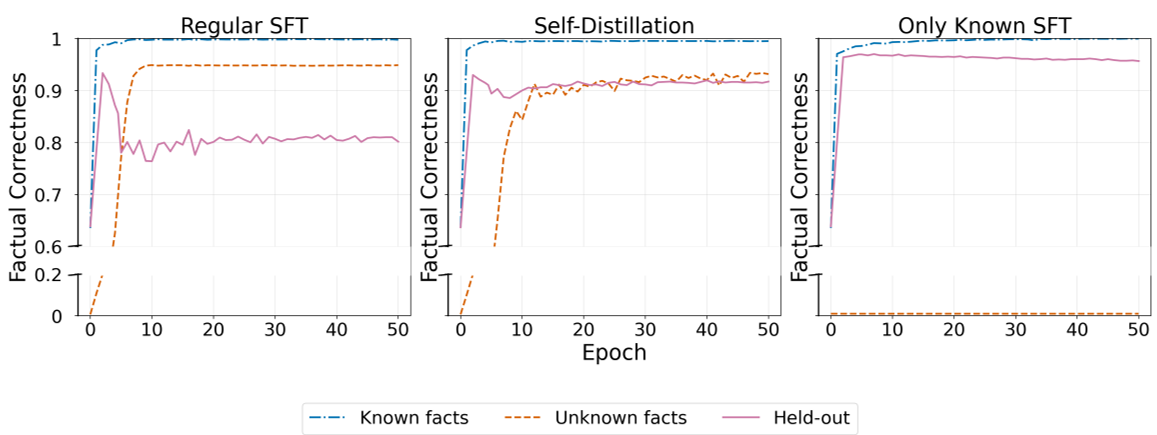
如上图所示,自我蒸馏(中间橙色/绿色曲线)成功实现了:新知识稳步增长,旧知识几乎不掉。这种方法通过约束 Logits,间接保护了中间层的表示不被剧烈扰动。
方案 B:选择性参数冻结
在不需要注入新知识(如仅仅是做格式对齐、风格迁移)时,作者发现:
- 更新 Attention 层:能学会任务格式,但几乎不吸收新事实,因此也不产生幻觉。
- 更新 FFN 层:新事实吸收快,但幻觉也随之爆发。
这再次验证了 FFN 层是大模型“事实数据库”的观点。在隐私敏感或对准确性要求极高的场景,只调优 Attention 或轻量化适配器是更稳妥的选择。
4. 实验分析与深度总结
作者在 Qwen-2.5 (1.5B/7B) 和 Llama-3.1 (8B) 上进行了广泛测试。研究发现,这种“干扰”在模型的中间层(如 28 层模型中的第 14 层)最为明显。
关键 Takeaways:
- 幻觉不是随机的:它们往往发生在与新学内容“长得像”的旧知识领域。
- 蒸馏权重 λ 是天平:较大的 λ 保护旧知识,但会减缓新知识的吸收速度。
- 未来方向:不仅要通过 SFT 学会“说话”,更要学会“保护记忆”。
结语
这项工作将幻觉问题从简单的“模型能力不足”提升到了“训练动力学冲突”的高度。对于工业界而言,这为减少 RAG 场景或垂直领域微调中的事实性错误提供了极其具操作性的指导工具:如果必须微调事实,请带上自我蒸馏;如果只调任务,请锁死 FFN。