
GAViD:融合 MLLM 上下文元数据,攻克复杂场景下的群体情感识别
GAViD: A Large-Scale Multimodal Dataset for Context-Aware Group Affect Recognition from Videos
本文推出了 GAViD,一个包含 5091 个视频片段的大规模多模态群体情感识别(GAR)数据集,并提出了 CAGNet 基准模型。该工作首次将视频、音频与 MLLM 生成的上下文元数据相结合,在三元效价(Valence)分类任务中达到了 63.20% 的准确率。
TL;DR
在情感计算领域,理解“一群人”的情绪远比理解“一个人”复杂。本文推出了 GAViD(Group Affect from ViDeos),这是目前最全面的野外多模态群体情感数据集。通过引入由 VideoGPT 生成、人工校验的上下文元数据(Context),并配套提出 CAGNet 架构,研究者在群体效价识别上取得了 63.20% 的 SOTA 性能,证明了“环境信息”在理解人类社交互动中的核心地位。
痛点深挖:为什么群体情感识别这么难?
传统的个体情感识别(Individual Affect Recognition)主要关注面部表情。但在真实的社交系统(如抗议、聚会、办公协作)中,仅仅看脸是不够的:
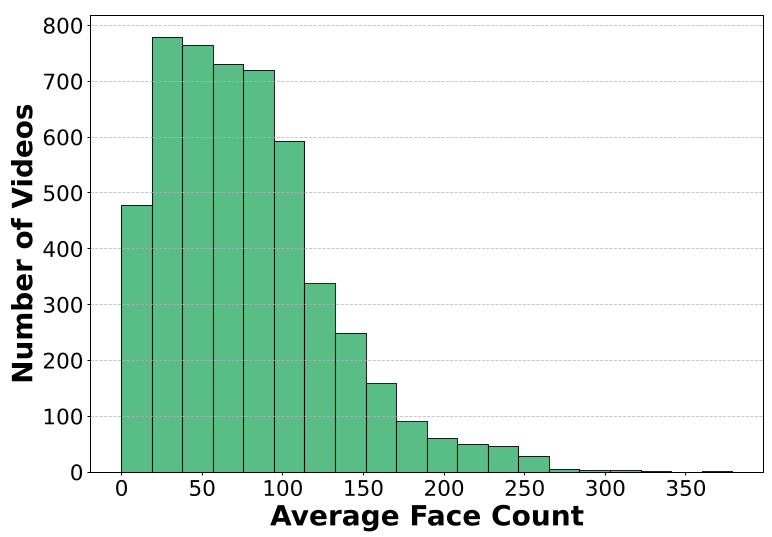
- 视觉干扰项多:光照、遮挡、运动模糊以及多变的人群数量,让面部特征提取极不可靠。
- 语义缺失:如果不知道背景(是在庆祝还是在争吵),单一的肢体或声音信号可能产生误解。
- 数据荒漠:现有数据集(如 VGAF, GCE)大多只有视频,缺乏文本描述和精细的动作标注。
方法论详解:多模态对齐与门控融合
作者设计的 CAGNet (Context-Aware Group Affect Recognition Network) 并不是简单地堆叠特征,其核心逻辑在于交叉模态对齐和动态加权。
1. 架构解析
- 特征提取层:使用冻结的 DINOv2(视觉)、Wav2Vec 2.0(音频)和 XLM-RoBERTa(文本描述)作为 Backbones,确保了强大的特征表达能力。
- 交叉注意力机制:模型构建了三组双模态对齐模块(V-A, V-C, A-C)。这允许一种模态去“询问”另一种模态中缺失的可疑信息(例如:视频模糊时,模型会更关注文本里的场景描述)。
- 门控融合(Gated Fusion):引入了类似 Squeeze-and-Excitation 的机制,根据输入内容动态调整不同模态的贡献度。
实验与结果:上下文是“救命稻草”吗?
实验结果非常直接地回答了这个问题:Yes.
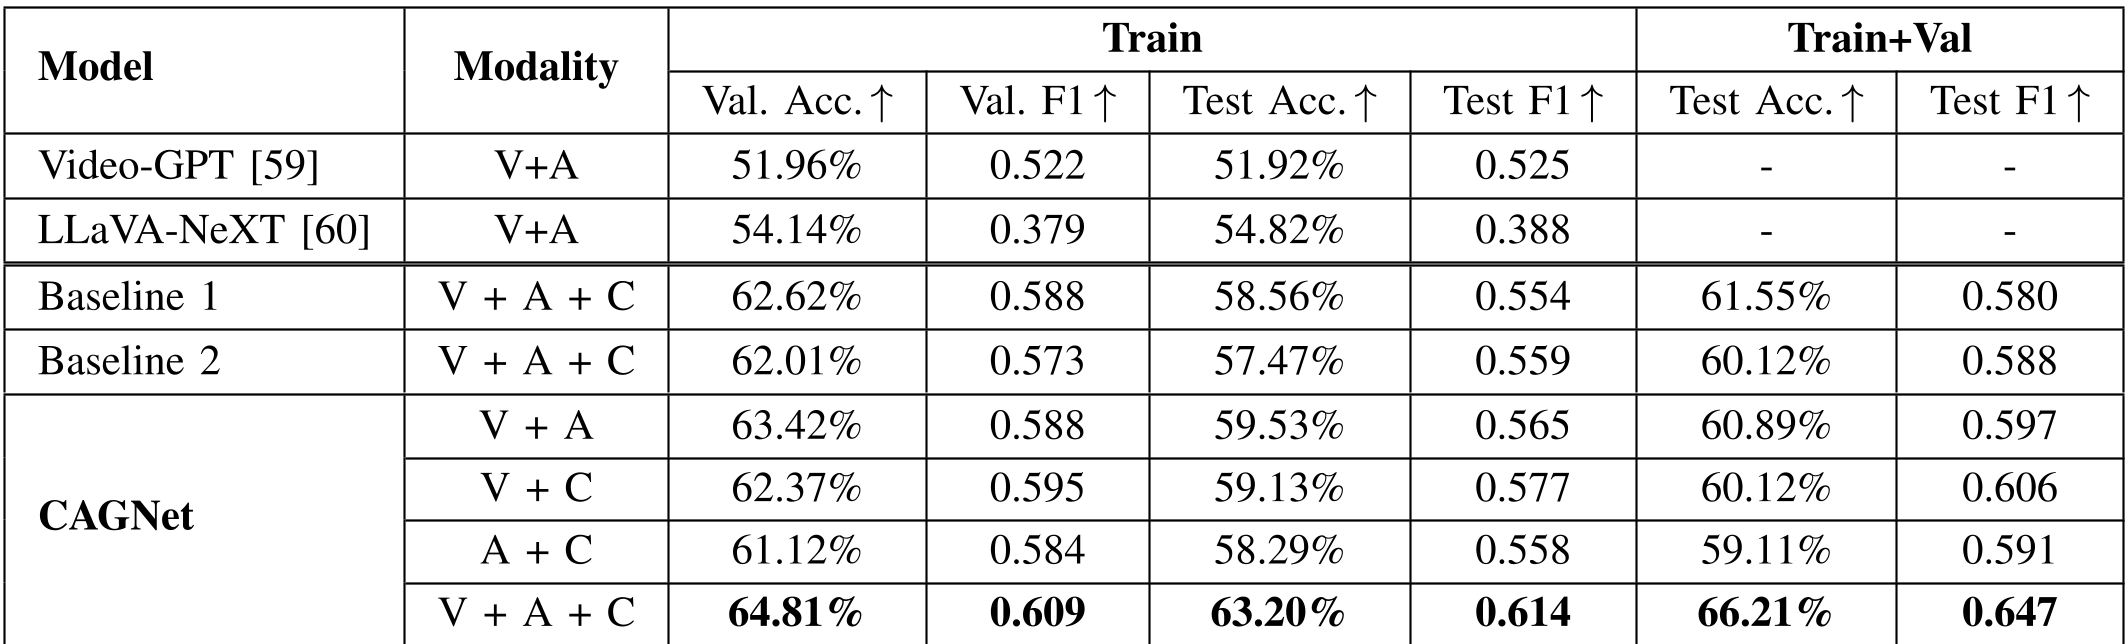
- 性能对比:在三元效价(正向、中性、负向)分类中,三模态组合(V+A+C)表现最佳。相比于最强的双模态组合(V+A),加入上下文信息使测试准确率从 59.53% 提升至 63.20%。
- 对标通用大模型:有趣的是,像 Video-GPT 和 LLaVA-NeXT 这样拥有数亿参数的通用多模态大模型,在 GAViD 任务上的表现(约 51-54%)远不如专门训练的小模型 CAGNet。这说明细粒度的 Affect 识别需要专有的上下文对齐。
消融研究
通过消融实验,作者发现视觉始终是最强的信息源,但上下文在“微妙互动的判别”上起到了决定性作用。例如,在办公室场景中,单纯看脸可能无法区分“严肃的讨论”和“激烈的批评”,但辅以文本元数据("Boss scolding employee")后,识别精度大幅提升。
深度洞察与总结
核心价值(Takeaway): GAViD 的贡献不在于模型架构的繁复,而在于数据维度的扩充。它将 MLLM 生成的语义描述 作为一种标准模态引入小模型训练,这种“大模型生成特征,小模型执行下游”的范式值得同类任务借鉴。
局限性 (Limitations):
- 时间动态性:目前仅采用 5 秒片段,对超长距离(Minutes 级)的群体情绪演化捕捉不足。
- 标签密度:目前是片段级标注,未来如果能细化到帧级的个体到群体的情绪传递(Emotional Contagion),价值将成倍增加。
未来展望: 该路线在智能监控、在线教育参与度评估以及社交机器人导航等领域具有巨大的落地潜力。