
HY-World 2.0:统一生成与重建,腾讯混元打造开源 3D 世界模型新标杆
HY-World 2.0: A Multi-Modal World Model for Reconstructing, Generating, and Simulating 3D Worlds
腾讯混元团队推出 HY-World 2.0,这是一个统一 3D 世界“生成”与“重建”的多模态世界模型框架。该系统支持文本、单图、多图及视频输入,通过四阶段流水线生成高保真、可导航的 3D 高斯点云(3DGS)场景,在多项基准测试中达到 open-source SOTA,性能直追闭源模型 Marble。
TL;DR
腾讯混元团队发布了 HY-World 2.0,这是首个系统性地将 3D 世界生成(Generation) 与 物理精确重建(Reconstruction) 完美统一的开源框架。它能够将一段文字或一张照片,转化为一个物理连贯、可交互、带碰撞检测的 3D 高斯点云(3DGS)世界。
1. 痛点:生成与重建的“柏林墙”
在 AI 领域,构建 3D 环境一直存在两条平行线:
- 重建派(如传统的 MVS 或最近的 AnySplat):追求几何精度,但“所见即所得”,无法处理遮挡和盲区。
- 生成派(如各类 Video-to-3D):想象力丰富,但在大尺度场景下往往发生“几何漂移”,导致场景在物理上不可靠。
HY-World 2.0 的核心动向就是拆掉这堵墙:通过视频生成的强力 Prior 处理未知区域,通过升级的 Feed-forward Reconstruction 确保几何严谨性。
2. 核心架构:四阶段炼就 3D 世界
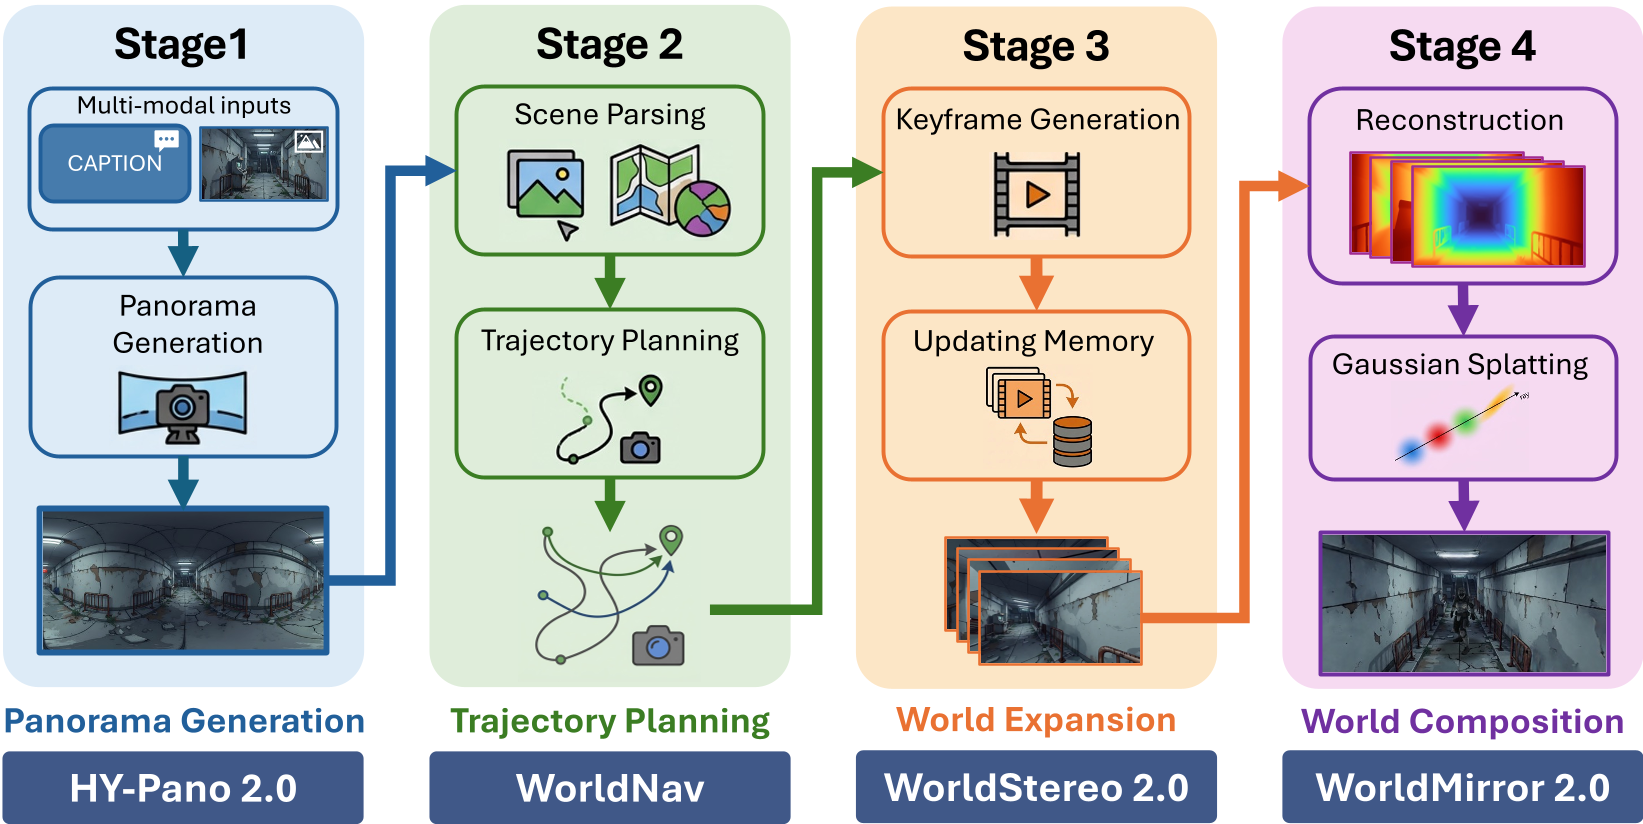
HY-World 2.0 的工作流程像是一个人类探险家:先看全局(全景生成),再定路线(轨迹规划),接着向远方探索(世界扩张),最后绘制地图(3D 组合)。
第一阶段:HY-Pano 2.0(全景初始化)
作者摒弃了传统繁琐的几何纠偏,采用 MMDiT(Multi-Modal Diffusion Transformer)在潜空间直接学习透视图像到等距柱状投影(ERP)的映射。这种“数据驱动”的方法能够生成无缝且具备全局语义一致性的 300° 视角。
第二阶段:WorldNav(语义轨迹规划)
为了让生成的 3D 世界没有死角,系统内置了一个“智能导航员”。它会利用 Qwen3-VL 进行场景理解,辨别障碍物,并设计出五种启发式路径(如:绕着物体转、专门去拍模糊区域等),确保后续重建有足够的高重叠度视角。
第三阶段:WorldStereo 2.0(世界扩张)
这是物理一致性的关键。作者提出了 Keyframe-VAE,只对空间进行压缩而保留时间维度。
- GGM(全球几何记忆):将粗糙的点云作为 3D 先验“喂”给模型,防止生成过程中房子塌了、路偏了。
- SSM++(空间立体记忆):通过“检索-拼接”机制,让模型在生成新帧时能参考之前的关键帧,细节纹理的一致性大幅提升。
第四阶段:WorldMirror 2.0 与 3D 组合
这是最后的拼图。WorldMirror 2.0 引入了 Normalized Position Encoding。传统的位姿编码在测试分辨率大于训练分辨率时会失效,而归一化编码将外插转为内插,保证了在 4K 级别渲染下依然稳健。
3. 实验结果:开源界的 Marble 挑战者
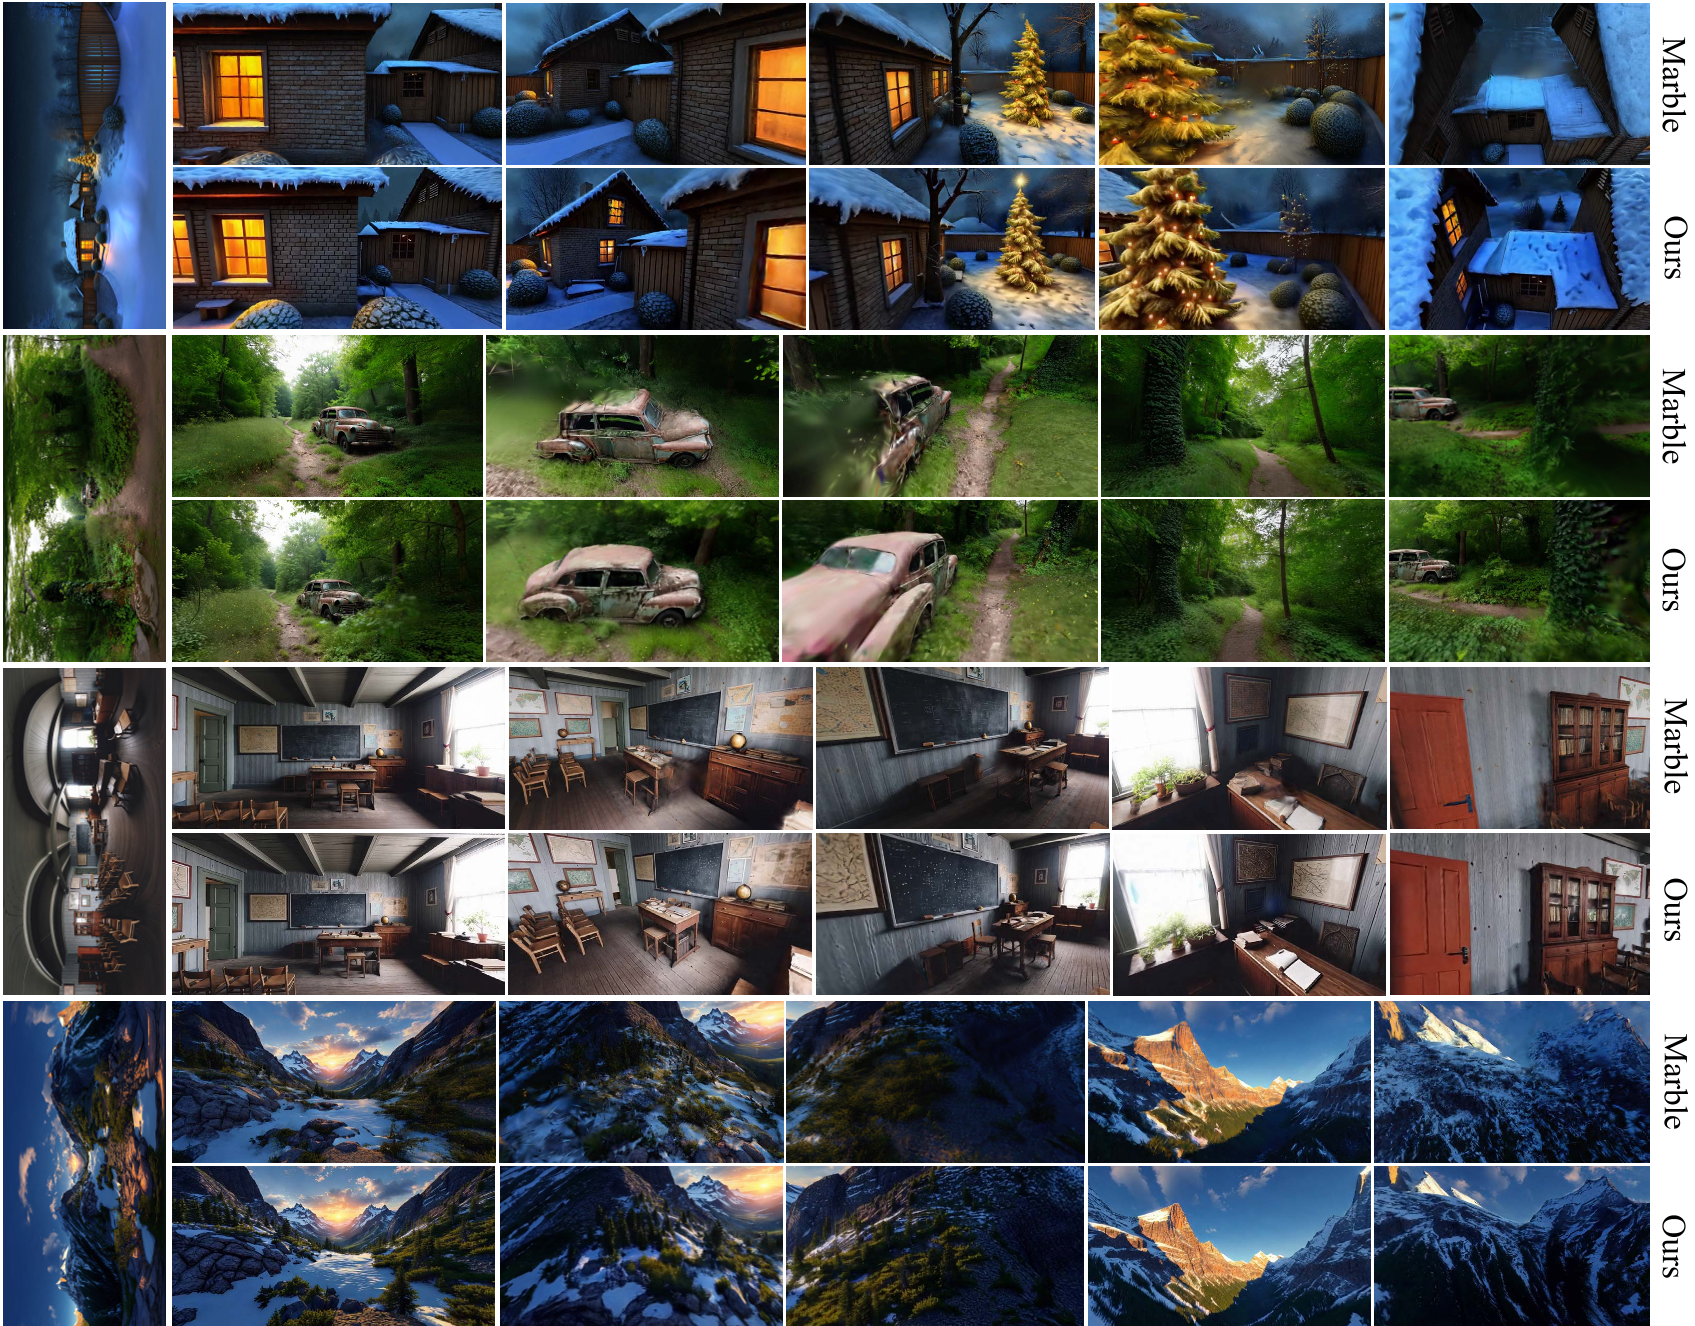
HY-World 2.0 在与目前顶尖的闭源模型 Marble 对比中表现惊艳。从对比图中可以看到, Marble 在大视角变换下经常出现模糊或几何缺失,而 HY-World 2.0 对围栏、车辆等细长结构的保持更具韧性。
在消融实验中,加入 MaskGaussian 机制后,模型自动识别并剪枝了天空中冗余的、导致渲染卡顿的虚假高斯点,使得 3DGS 数量减少了 73.7%,渲染效率大幅提升。
4. 深度洞察:为什么它能成功?
- Keyframe 胜过 Full Video:在 3D 重建中,帧与帧之间的冗余是有害的。作者选择生成关键帧而非连续视频,极大地释放了显存去提升单帧的高频细节。
- 几何驱动的 Attention:模型不是在盲目地 Predict 像素,而是在 GGM(几何记忆) 的显式引导下进行插值,这使得生成过程具备了类似传统 SLAM 的空间感。
5. 局限性与展望
尽管 HY-World 2.0 刷新了性能,但在处理极其复杂的动态透明材质(如喷泉、火焰)时,生成的深度图仍存在挑战。未来的方向可能会集中在将 SSM(状态空间模型) 引入长时记忆,以及进一步降低 3DGS 训练的冷启动耗时。
总结:HY-World 2.0 不仅仅是一个模型,它是一套完整的生成式 3D 生产力工具链路。随着权重的发布,它有望在开源社区掀起一波“世界模型”的新浪潮。