
视觉领域的“GPT时刻”:Vision Banana 证明图像生成器即通用视觉学习者
Image Generators are Generalist Vision Learners
本文提出了 Vision Banana,证明了图像生成模型(Nano Banana Pro)本质上是通用的视觉学习者。通过极轻量级的指令微调(Instruction-tuning),该模型在语义分割、深度估计和表面法线预测等任务上达到了 SOTA 水平,甚至超越了 Segment Anything 3 和 Depth Anything 3 等领域专家模型。
TL;DR
在自然语言处理领域,GPT 证明了“生成即理解”。而在计算机视觉领域,这一设想终于被 Vision Banana 证实。通过对强大的图像生成基座 Nano Banana Pro (NBP) 进行极轻量级的指令微调(Instruction-tuning),Vision Banana 不仅能画出精美图片,还在语义分割、度量深度估计等多项硬核视觉理解任务中,击败了 SAM 3 和 Depth Anything 3 等一众“领域专家”。
痛点与动机:为什么视觉理解一直“各搞各的”?
传统的计算机视觉任务(如分割、探测、深度估计)通常被视为判别任务,依赖于为任务量身定制的架构(Specialized Architectures)和损失函数。虽然 Segment Anything 等基础模型出现后有所缓解,但视觉领域依然缺乏像 LLM 那样能够靠单一生成接口处理一切任务的“通用能力”。
作者认为,图像生成器在学习如何创作视觉内容时,已经暗中“内化”了世界的几何结构和语义。以前我们觉得生成模型“理解力不行”,是因为没有找到正确的“对齐”方式。
核心方法:Image Generation as a Universal Interface
Vision Banana 的核心贡献在于其 “视觉指令微调” 策略。它没有改变模型的一行代码,而是将感知任务彻底重构为图像生成任务:
- 统一接口:不论是深度图还是分割掩码,全部要求模型输出为 RGB 图像。
- 可逆编码 (Invertible Mapping):为了让生成的颜色能变回精准的物理数值(例如深度米数),作者设计了精妙的数学映射。比如,使用 3D Hilbert 曲线在 RGB 色彩立方体内进行路径插值,将无限的深度值 映射为闭合的 颜色空间。
- 对齐训练:在生成基座的训练数据中加入极低比例(Low-ratio)的视觉任务数据,使模型学会根据 Prompt(如“用黄色分割滑板”)输出特定格式的图像。
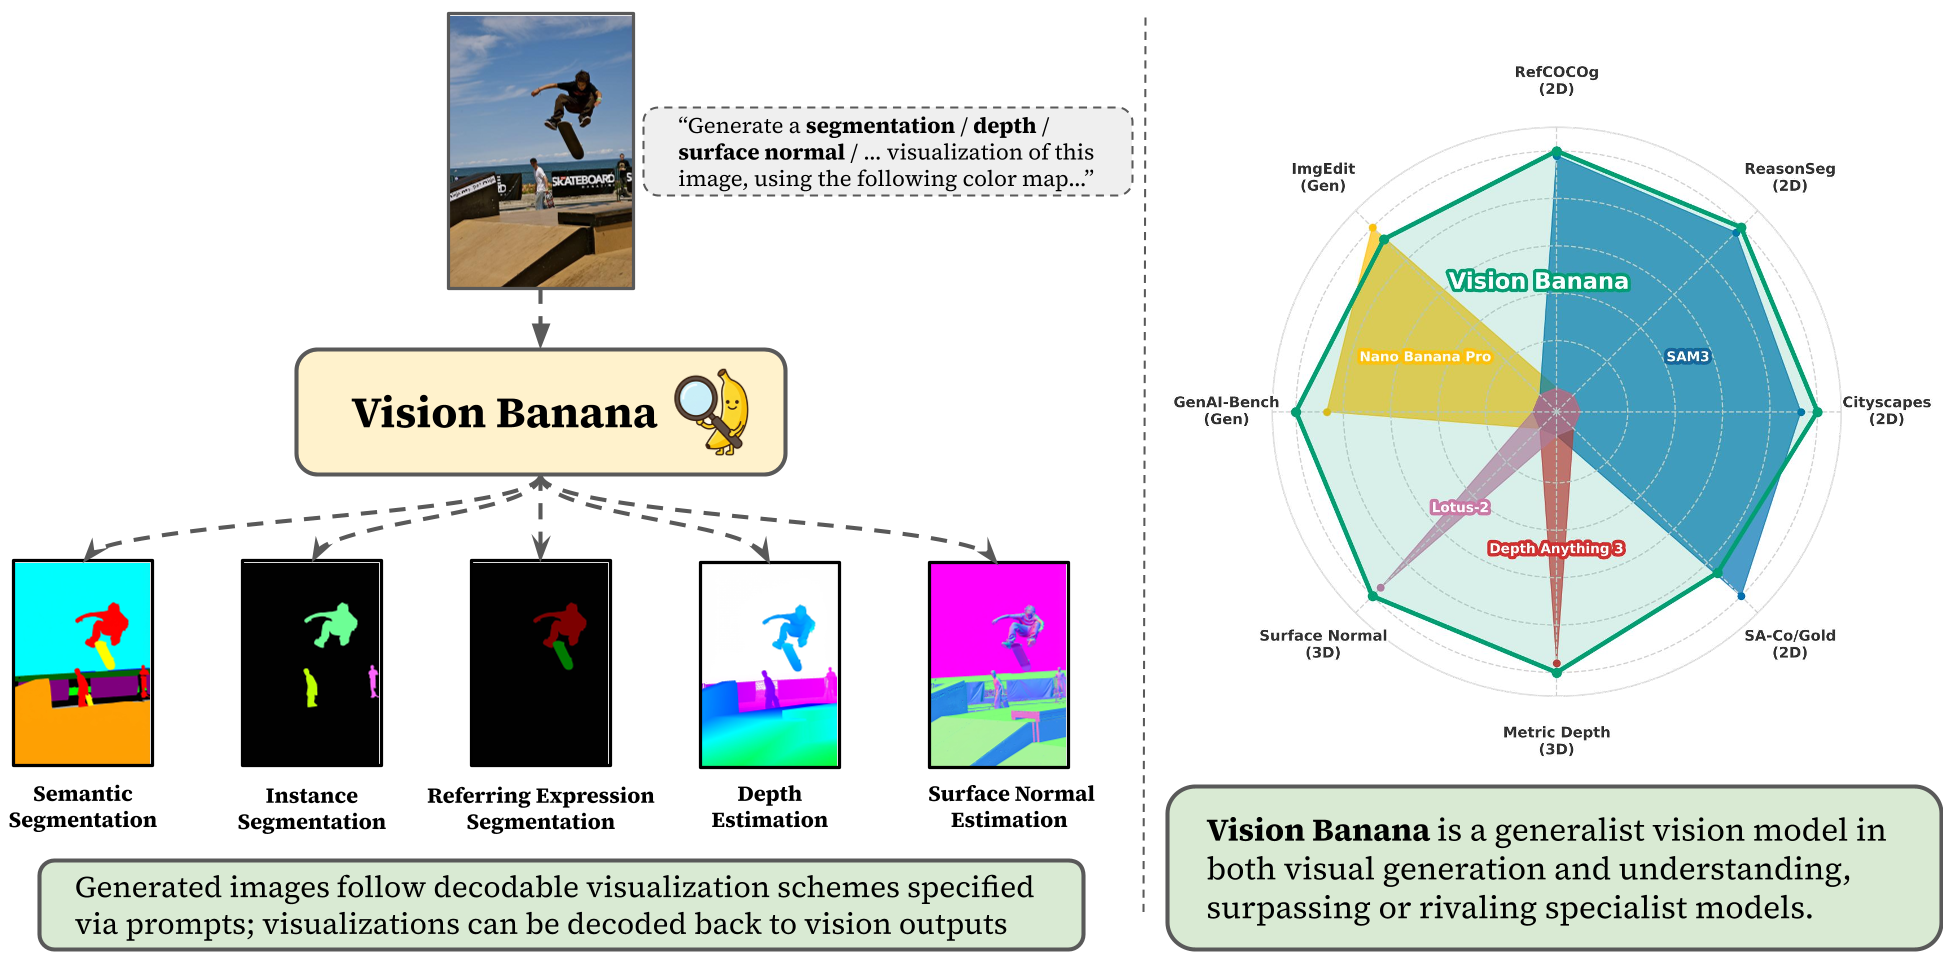 图 1:通过指令微调,将生成能力转化为理解能力
实验结果:全方位的跨界打击
Vision Banana 的表现令人震惊,它在几乎所有测试的“理解”基准上都表现得像个专业模型,同时还没忘记怎么“画画”。
1. 语义与实例分割
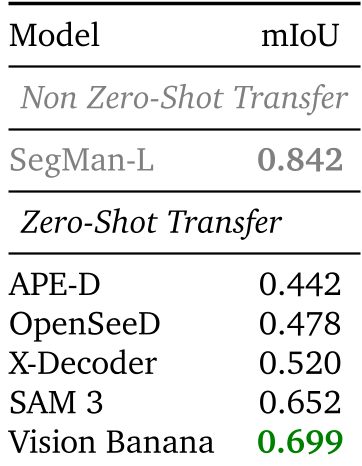
在 Cityscapes 语义分割任务中,Vision Banana 的 mIoU 达到了 0.699,高出 SAM 3 近 4.7 个百分点。在推理分割(Reasoning Segmentation)任务上,结合 Gemini 2.5 Pro,它展现出了极强的常识理解能力,能精准捕捉“月牙形的羊角面包”这种复杂指令。
2. 3D 结构理解(深度与法线)
最令学术界侧目的是其在 度量深度估计 (Metric Depth Estimation) 上的成就。传统方法极度依赖相机内参(Intrinsics),而 Vision Banana 完全不看这些数据。通过学习物体大小的先验知识,它直接从视觉特征中推断物理距离。在 KITTI、ETH3D 等多个数据集上的平均指标()达到了 0.929,超越了最强专家模型 Depth Anything 3。
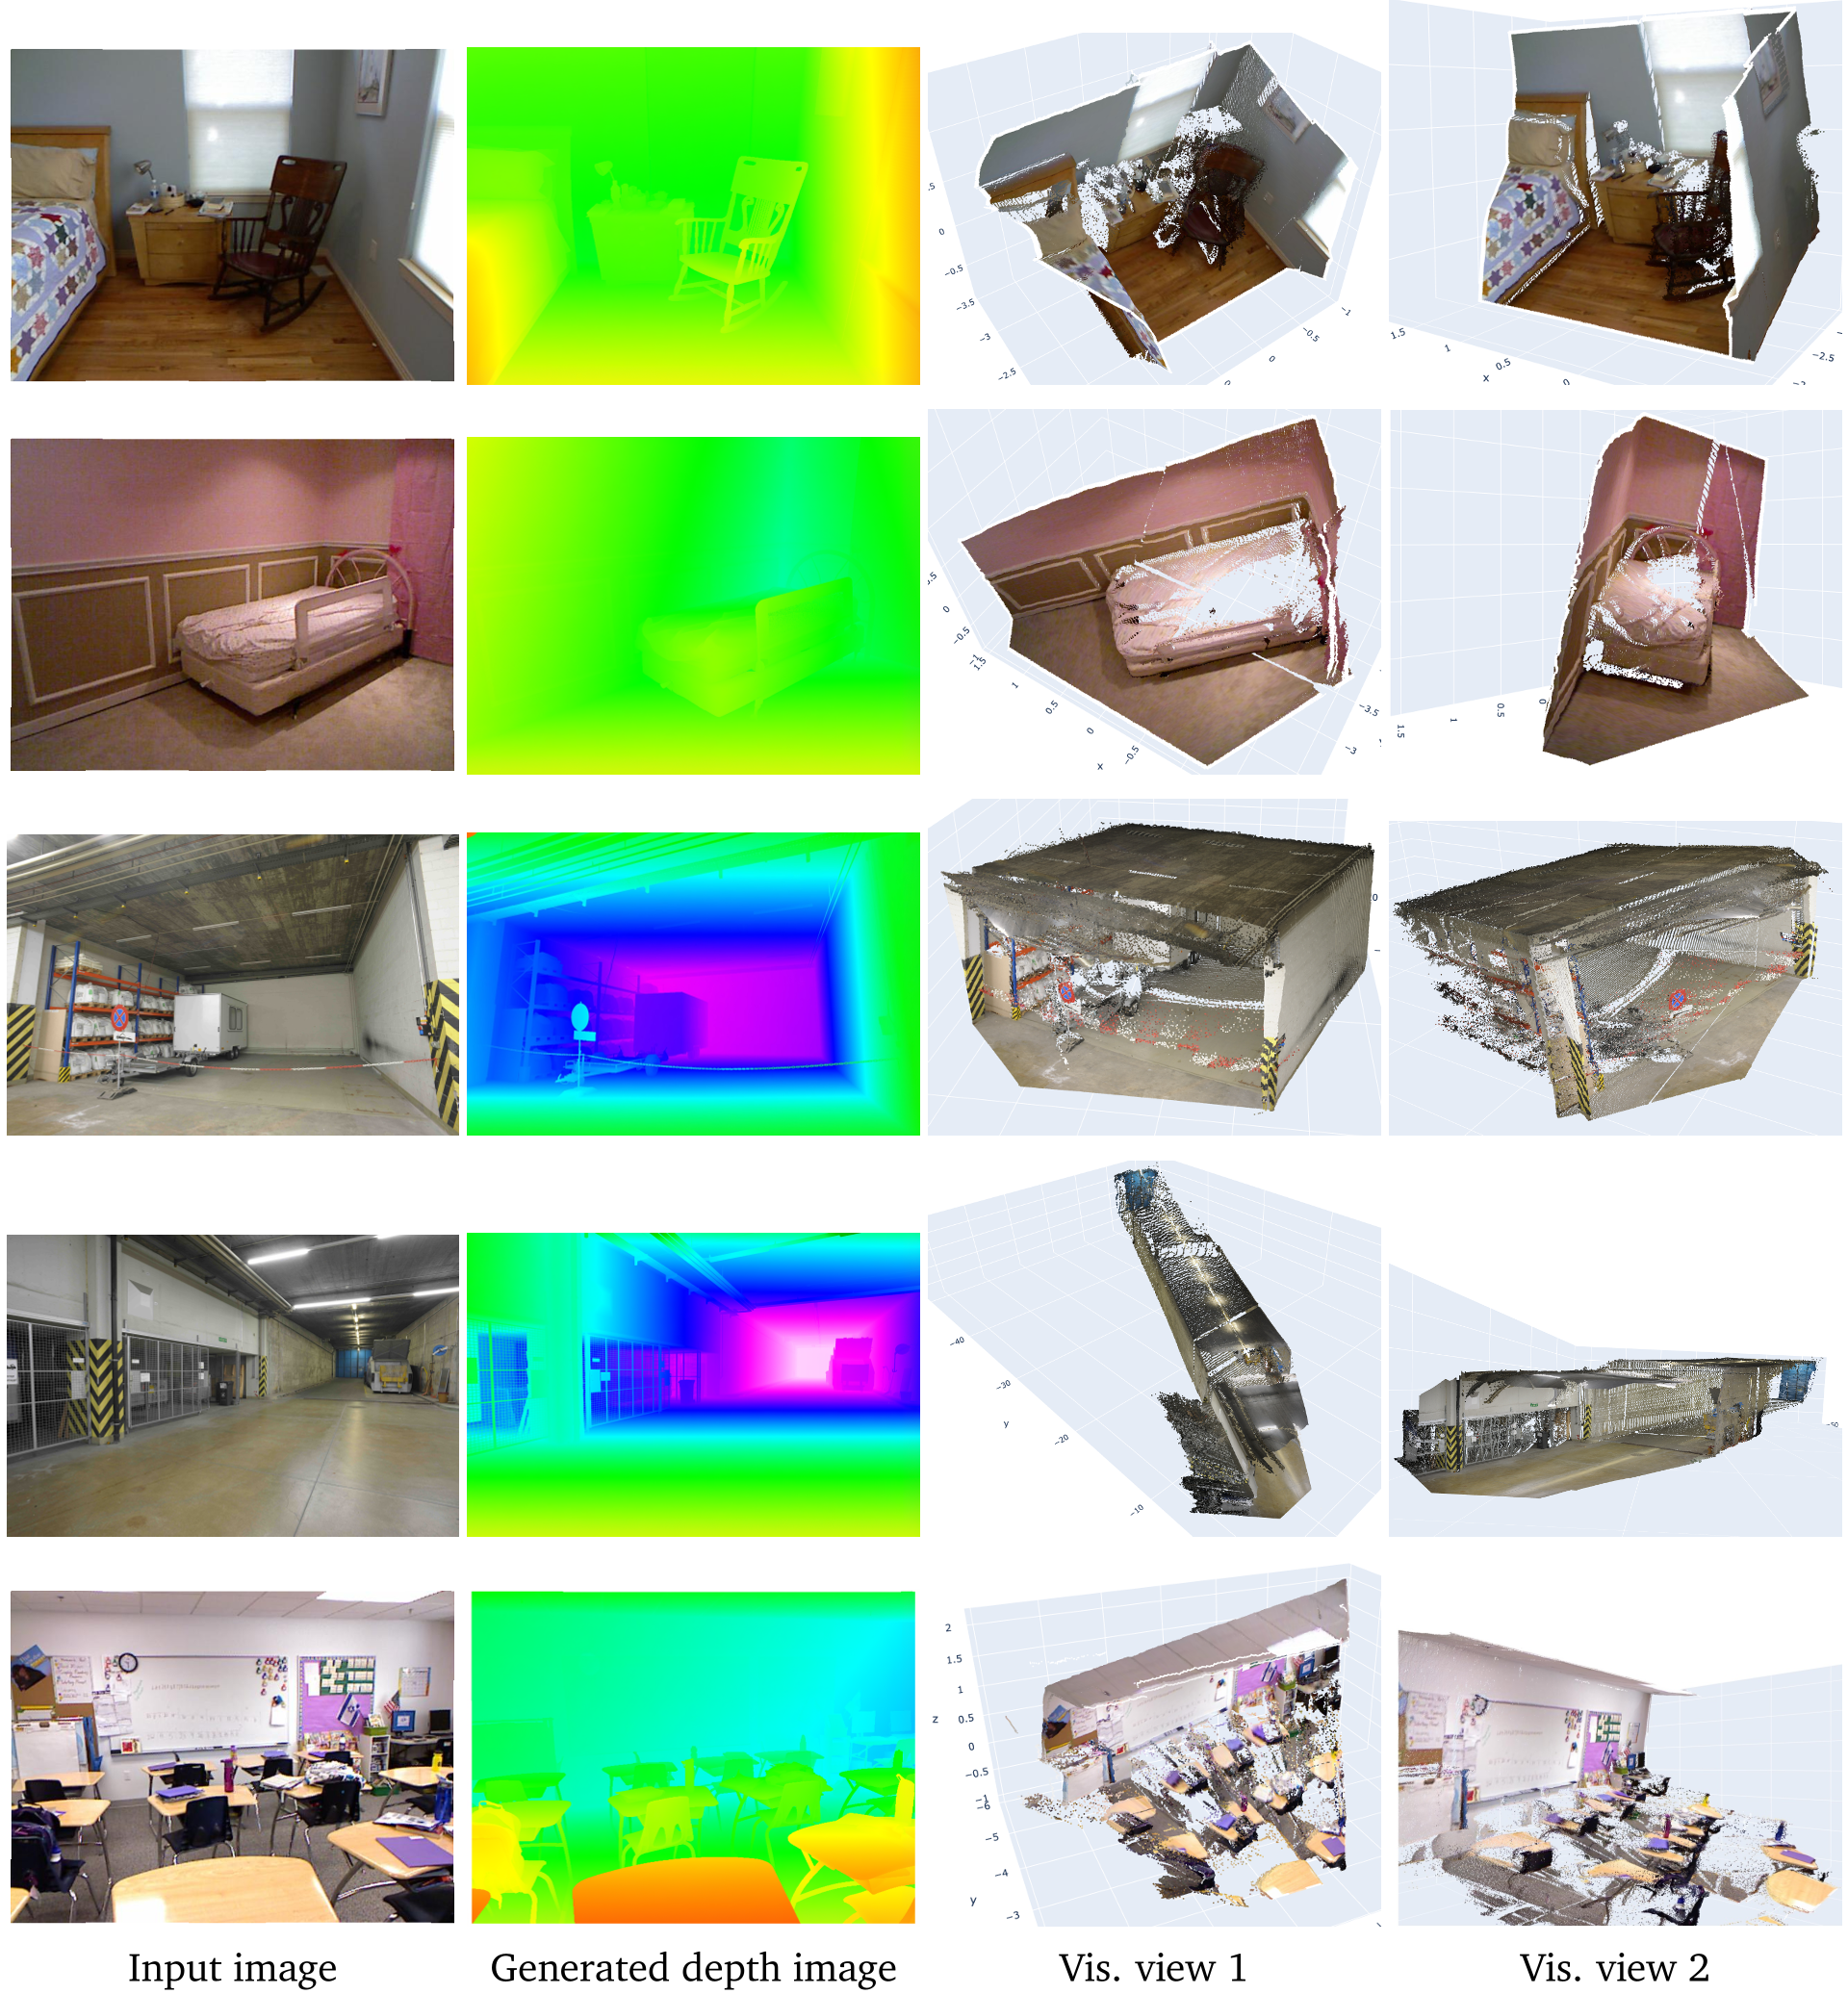 图 2:Vision Banana 生成的深度图细节锐利,全局几何关系极度一致
深度洞察:范式迁移已经到来
Vision Banana 的成功揭示了两个深层趋势:
- 生成式预训练是更强的学习器:以往我们认为判别式学习(如 DINO, CLIP)给出的特征更好,但本文证明,学习如何“重构”一个像素完美的世界,赋予了模型更深层的几何直觉。
- 架构统一化的终点:不再需要特定任务的 Header,不再需要复杂的 Loss。只要生成能力足够强,整个计算机视觉都可以被简化为“Prompt + Image Generation”。
总结与未来
Vision Banana 成功“解锁”了图像生成器隐藏的理解天赋。虽然目前其推理开销(Computational Overhead)相比轻量级专家模型依然较高,但这无疑标志着视觉基础模型(Foundational Vision Models)迈向了类 GPT 的通用路径。正如作者所言,我们可能正在见证计算机视觉的一个重大范式转移。
** takeaway**: 以后评判一个生成模型好不好,不仅要看它画得美不美,还要看它“认不认识”自己画的东西。