
DeepInsightTheorem:赋予大模型数学直觉,突破非正式定理证明的瓶颈
Learning to Reason with Insight for Informal Theorem Proving
本文提出了 DeepInsightTheorem 框架,旨在解决非正式数学定理证明(Informal Theorem Proving)中的核心技术识别难题。其核心是一套包含 10 万级高难度数学题目的分层数据集及配套的“渐进式多阶段 SFT”训练策略,在 FIMO 和 Putnam 等竞赛级基准测试中显著超越了现有模型。
在人工智能追求逻辑推理的道路上,自动定理证明 (Automated Theorem Proving, ATP) 被视为终极战场之一。与依赖 Lean 或 Coq 等符号系统的硬核“正式证明”相比,非正式证明 (Informal Theorem Proving) 使用自然语言和 LaTeX 描述,更符合人类数学家的习惯,也更能发挥 LLM 的预训练优势。
然而,当前的 LLM 在面对 IMO 或 Putnam 级别的竞赛题时,常表现出“有逻辑、无灵魂”的问题:它们能流畅地写出平凡的推导,但在需要妙手偶得的核心步骤(如构造特殊序列或调用冷门引理)时,往往会陷入混乱。
近日,来自香港城市大学、清华大学等机构的研究者发表了论文《Learning to Reason with Insight for Informal Theorem Proving》,提出了一种名为 DeepInsightTheorem 的新范式,试图教模型像专家一样思考。
1. 核心挑战:缺失的“数学洞察力” (Insight)
研究团队发现,非正式证明的失败通常源于模型缺乏 Insight(洞察力)。在数学语境下,这指的是在动笔之前,识别出解决问题的核心技术 (Core Techniques) 的能力。
作者通过实验观察到,当模型处理到关键步骤时,Token 的预测熵值 (Entropy) 会产生明显的尖峰。这意味着模型在这些位置感到“犹豫”。
- Construction (构造):如构造辅助函数、嵌套开集序列。
- Theorem Call (定理调用):识别出何时该用 Baire 范畴定理或狄利克雷抽屉原理。
- Transformation (数学变换):将代数问题转化为拓扑问题等非平凡转换。
 图注:在 Baire 范畴定理的证明中,熵值尖峰精准对应了核心技术的引入位置。
2. DeepInsightTheorem:构建层级化知识
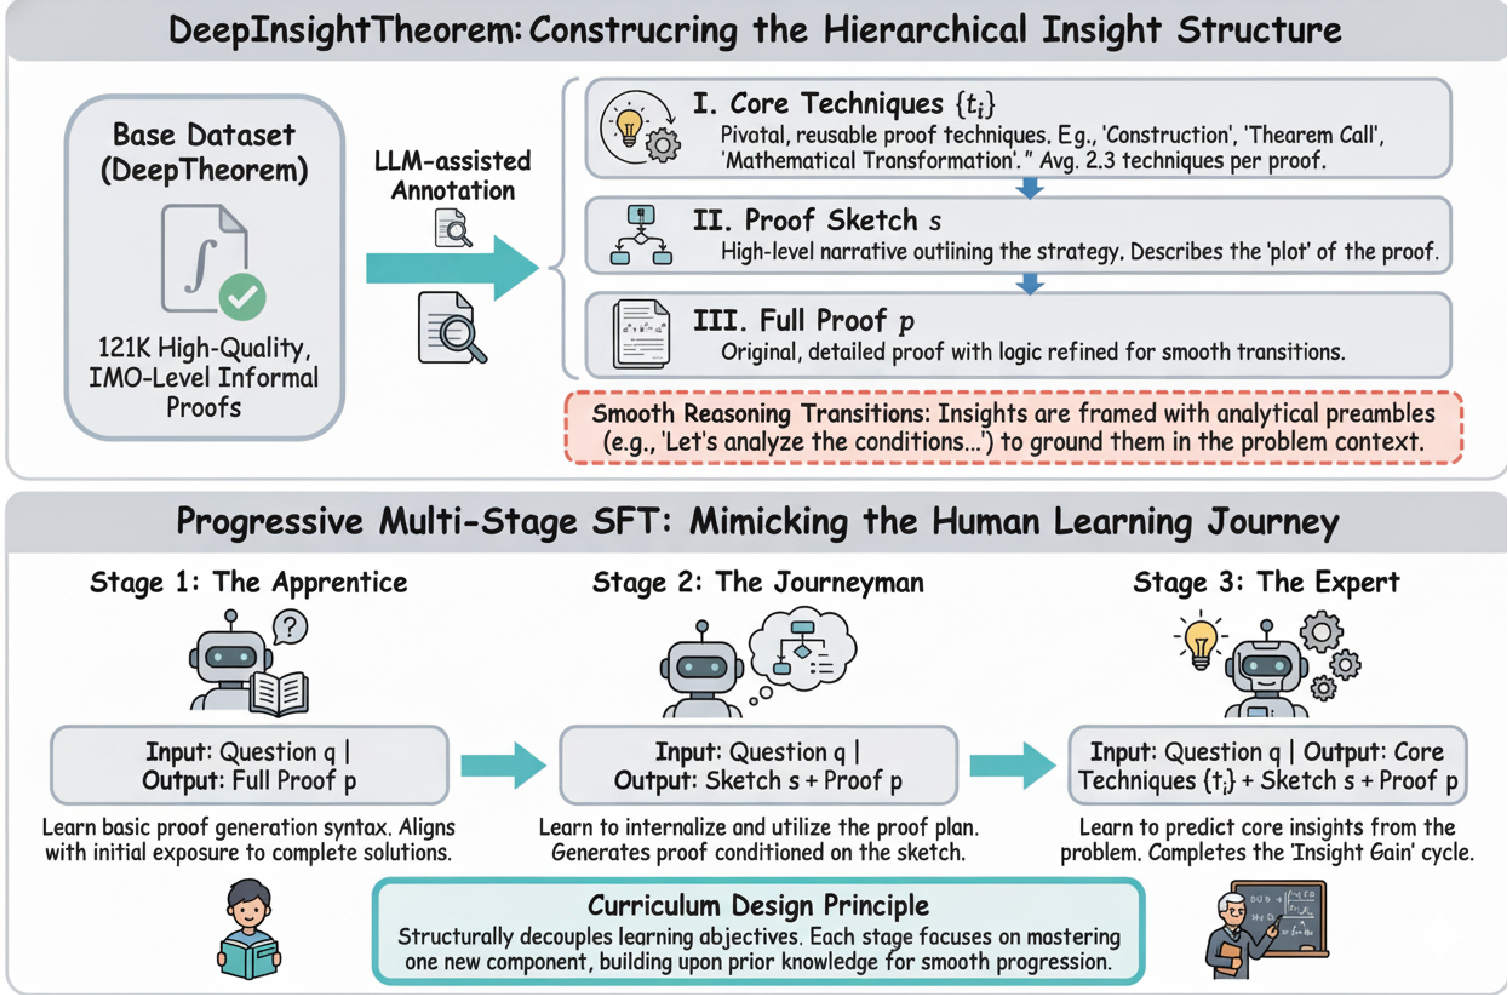
为了弥补这一短板,作者构建了一个层级化数据集。每一条数据不再仅仅是 [问题 -> 证明],而是被重构为:
- Core Techniques (核心技术):以 Heuristic 的语言分析条件,并提炼技术标签。
- Proof Sketch (证明大纲):连接高层洞察与低层推导的桥梁。
- Full Proof (完整证明):对大纲的具体实例化。
这种结构强制模型在生成最终答案前进行“深度思考”,建立起从问题条件到解题工具的直接映射。
3. 进阶式学习:从学徒到专家
直接在复杂数据上训练模型往往会导致过拟合或收敛困难。作者模仿人类的学习路径,设计了 Progressive Multi-Stage SFT(渐进式多阶段微调):
- 阶段一:Apprentice (学徒)。在基础
(问题, 证明)对上训练,打好数学语言和基本推导的底子。 - 阶段二:Journeyman (工匠)。引入
(问题, 大纲, 证明)三元组,训练模型捕捉逻辑骨架。 - 阶段三:Expert (专家)。在全层级数据
(问题, 核心技术, 大纲, 证明)上训练,最终培养出识别本质问题的直觉。
 图注:DeepInsightTheorem 的数据构建流程(上)与多阶段训练策略(下)。
4. 实验结果:小模型也能拥有“直觉”
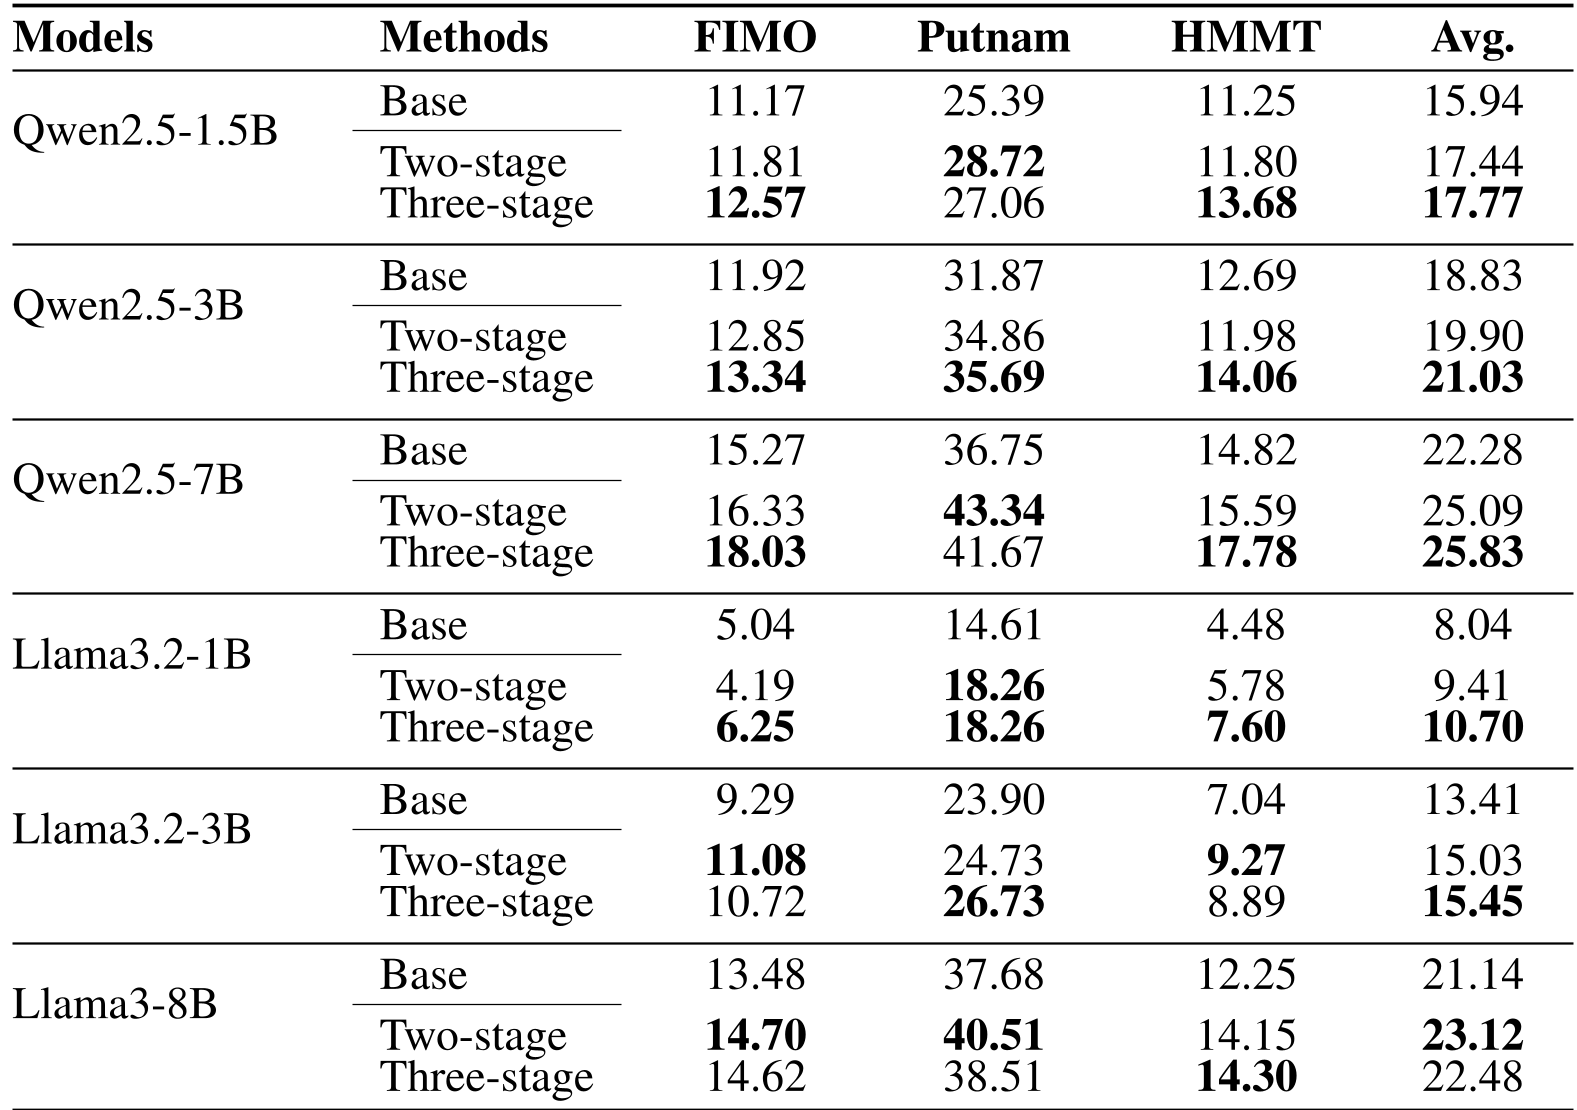
在 FIMO、Putnam 和 HMMT 三大数学基准测试中,DeepInsightTheorem 表现优异:
- 性能超越 Base 模型:在 Llama 和 Qwen 全系列上均有显著提升,Qwen2.5-7B 在 Putnam 上的得分从 36.75 跃升至 43.34。
- 打破能力天花板:即使像 1.5B 这样的小规模模型,在引入 Insight 指导后,其推理能力的提升甚至比大模型更明显。
- 媲美强化学习:仅靠 SFT,模型就达到了很多采用强化学习(RL)后训练模型的水平。
5. 深度洞察:为什么这有效?
传统的 CoT(思维链)虽然增加了推理步骤,但往往是无目的的“滚动”。DeepInsightTheorem 的成功在于其引入了锚点。通过显式标注核心技术,模型在训练过程中学会了将有限的注意力资源集中在最关键的逻辑跳跃上。
局限性与展望: 尽管效果显著,但该方法目前仍属于 SFT 范畴,依赖于高质量的标注数据。未来的方向可能是将其与类似 DeepSeek-R1 的强化学习相结合,让模型在自主搜索中发现并完善这些核心技术的识别模式。
总结:DeepInsightTheorem 告诉我们,数学推理不仅仅是字符的下一个词预测,更是对模式和工具的精准识别。通过解构“洞察力”,我们距离真正具备逻辑思维的 AI 又近了一步。