
[CVPR 2025] LiVER:解耦光照与布局,开启物理级可控视频生成新纪元
Lighting-grounded Video Generation with Renderer-based Agent Reasoning
本文提出了 LiVER,一个基于扩散模型的场景可控视频生成框架。该方法通过 Renderer-based Agent 将文本转化为包含布局、光照和相机的 3D 代理信息,并利用物理渲染生成的 2D 代理图指导 Wan2.2-5B 模型,实现了具有物理准确性的 SOTA 视频合成效果。
TL;DR
传统的视频生成模型(如 Sora、Wan2.1)虽然视效惊艳,但在精细的物理控制——尤其是光照(Lighting)与材质交互上表现乏力。来自北大等机构的研究团队推出了 LiVER 框架。它通过一个聪明的“渲染器代理(Renderer-based Agent)”,将抽象的文本指令转化为精确的 3D 渲染辅助信号,首次在扩散模型中实现了光影随心、布局可控的电影级视频合成。
1. 痛点:为什么 AI 视频的光影总感觉“假”?
目前的视频生成技术正处于从“黑盒生成”向“精确操纵”转换的阶段。虽然我们可以通过 CameraCtrl 控制运镜,通过 Boximator 控制位移,但光照始终是一个难啃的骨头。
- 现象:AI 生成的金属球往往反射不自然,或者在光源移动时,物体的阴影没有同步变化。
- 根源:现有方法大多使用深度图或骨架图作为 Condition。这些信息只包含几何,不包含双向反射分布函数(BRDF)。模型不知道光在粗糙表面和镜面反射表面会有什么不同反应。
2. 核心方案:LiVER 的渲染代理机制
LiVER 的核心直觉是:既然神经网络学不会物理,那就直接喂给它物理渲染的结果。
2.1 场景代理(Scene Proxy)的构建
LiVER 不直接处理复杂的 3D 表示,而是利用 Blender 引擎渲染出三组关键的 2D 代理通道:
- Diffuse(漫反射):捕捉低频环境光。
- Glossy GGX(高光):捕捉高频镜面反射和亮点。
- Rough GGX(粗糙反射):处理中频反射。
这些通道像是一组“导航图”,告诉扩散模型:哪里该发光,哪里该有阴影。
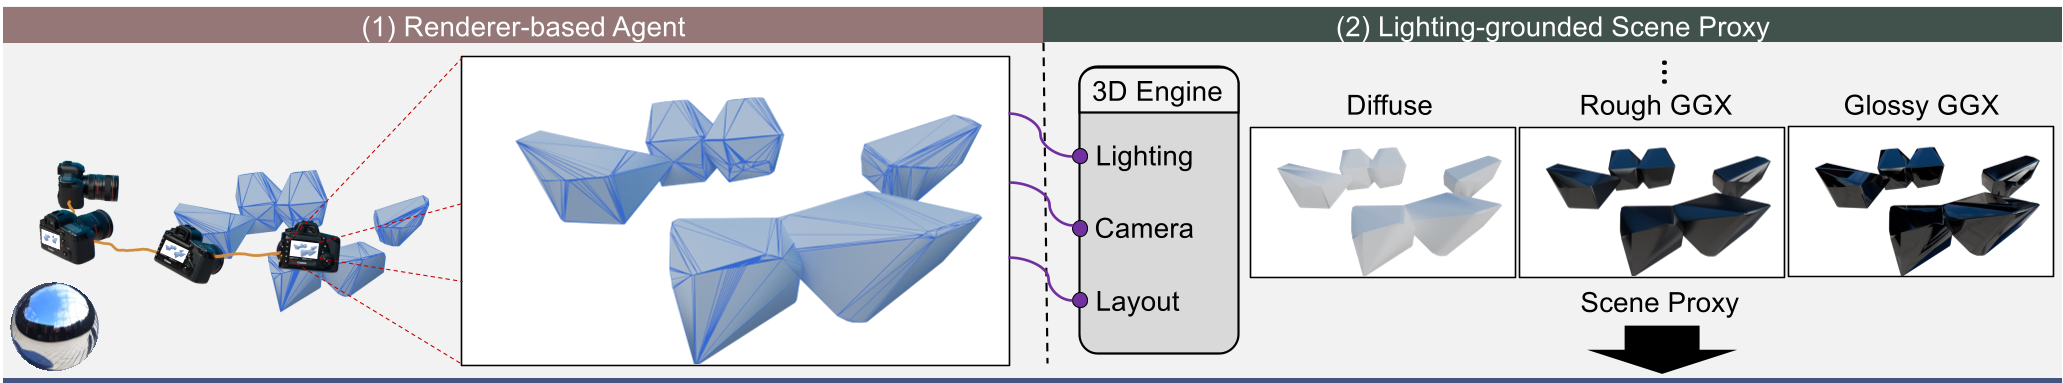 图 1:LiVER 整体框架图。从 Agent 推理、物理渲染到扩散模型注入的全流程。
2.2 智能 Agent 推理
为了降低用户门槛,LiVER 开发了一个场景 Agent。用户输入“温暖阳光下的书房”,Agent 会自动完成:
- Scene Building:检索匹配的 3D 模型并布置场景。
- Lighting Setup:匹配合适的 HDR 环境贴图。
- Camera Planning:规划丝滑的镜头轨迹(如 Dolly Zoom)。
3. 实验表现:SOTA 级别的物理一致性
研究团队构建了 LiVERSet 数据集(包含 1.1 万个高质量视频及其物理标注)。在对比实验中,LiVER 展现了碾压般的优势。
3.1 定量与定性分析
与 CameraCtrl 和 MotionCtrl 相比,LiVER 在 **mIoU(布局准确度)**上提升显著,这得益于其显式的 3D 代理注入。更重要的是,通过操纵渲染器的 HDR 环境贴图,模型可以生成连续、平滑的光照旋转效果,而几何结构保持绝对稳定。
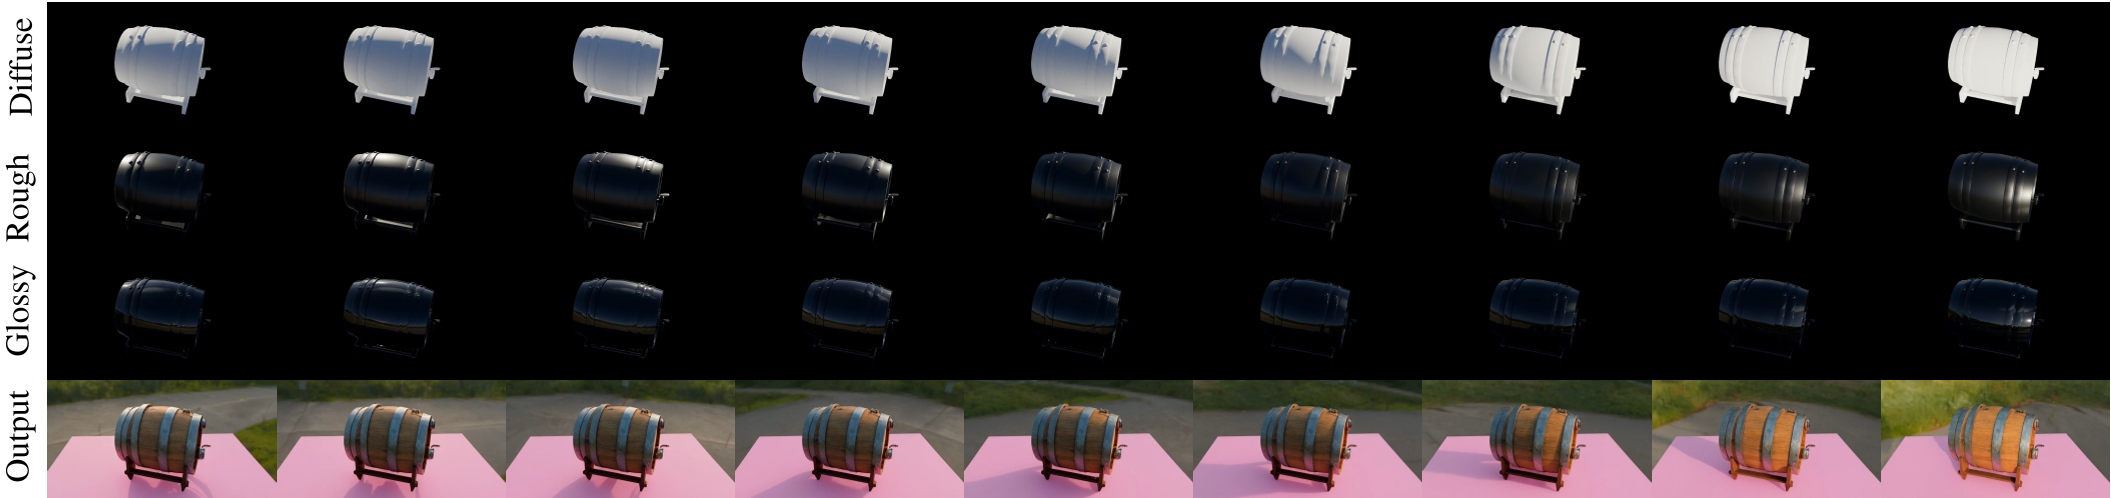 图 2:光照控制效果。随着光源旋转,物体的明暗分布和反射亮点实时且准确地迁移。
3.2 三阶段训练的神来之笔
为了不损害预训练模型(Wan2.2)的生成能力,作者采用了循序渐进的策略:
- Stage 1:只练 Condition Encoder,让模型认识代理图。
- Stage 2:联合 LoRA 微调,优化语义对齐。
- Stage 3:混合真实场景与合成场景数据,提升泛化能力。
4. 深度洞察:LiVER 的行业价值
LiVER 的出现不仅仅是刷高了几个指标,它标志着 AI 视频生成正式拥抱 CGI 工作流。
- 可编辑性:用户可以在合成视频后,通过修改 Blender 里的 3D 资产,精准替换某个物体或改变天气,而不用担心整个画面崩坏。
- 虚拟拍摄:这种对光照的极致控制,使其在虚拟制片(Virtual Production)领域具备极高的落地潜力。
5. 局限性与未来
不可否认,LiVER 目前的几何细节生成仍依赖于粗糙的 3D 重建,且受限于 Prompt 的精准度。未来的研究方向可能会转向更高精度的实时物理推断,甚至直接在潜空间(Latent Space)中嵌入物理引擎的物理量。
总结:LiVER 通过 Renderer-based Agent 成功将“物理常识”引入扩散模型,为我们展示了由 Renderer 引导的、可控且真实的未来。