
LongCoT:大模型推理的“万里长征”,顶级模型准确率不足 10%
LongCoT: Benchmarking Long-Horizon Chain-of-Thought Reasoning
本文推出了 LongCoT,这是一个包含 2,500 个专家设计问题的深度基准测试,涵盖化学、数学、计算机科学、国际象棋和逻辑五大领域。该基准旨在衡量 Frontier Models 在处理超长输出(通常需 10 万+ Reasoning Tokens)时的长程思维链(Long-horizon Chain-of-Thought)推理能力,目前最强模型 GPT 5.2 的准确率不足 10%。
TL;DR
尽管大模型在各类考试中表现神勇,但当推理任务需要维持数万乃至数十万 Token 的逻辑链条时,它们会迅速崩溃。本文介绍的 LongCoT 基准测试通过 2500 个横跨化学、数学、程序模拟等领域的硬核任务,精准打击了 Frontier Models 的软肋:长程推理(Long-horizon Reasoning)。目前强如 GPT 5.2,在该测试下的准确率也仅为 9.83%。
1. 痛点:被掩盖的推理崩塌
在当前的 AI 评估体系中,存在一个隐形的“天花板”:
- 短输出陷阱:像 MATH 或 HLE 这样的基准测试,虽然题目难,但模型通常只需几千 Token 就能得出结论。
- 工具依赖的干扰:Agent 类测试(如 SWE-bench)允许模型使用编译器或搜索工具。这掩盖了一个核心问题:如果剥离外部工具,模型能否仅靠自身的“大脑”维持长时间的逻辑自洽?
- 输入与输出的不对称:现有的长文本研究多关注模型能“读”多长,而 LongCoT 关注的是模型能“想”多深、输出多长。
作者发现,当推理路径变长时,模型会陷入:早期规划错误、状态丢失、回溯无力、以及随着 Token 增加而指数级累计的误差。
2. Methodology:如何制造高难度的推理迷宫?
LongCoT 的精妙之处在于它通过“专家模板”构建了两种复杂的计算图:
A. 显式组合模板 (Explicit Compositional)
将多个本身易解的子问题连接成一个复杂的 DAG(有向无环图)。
- 级联依赖:只有算出节点 A,才能作为输入去解节点 B。
- 逻辑陷阱:引入条件分支(If-else)和强制回溯(Backtracking),一旦中间某步算错,整个任务全盘皆输。
B. 隐式过程模板 (Implicit Procedural)
模型需要理解底层规则(如化学反应、象棋规则、编译器 Pass),并在潜在的巨大图结构中自主寻路。
- 状态维护:在模拟图搜索或复杂的 Python 循环时,模型必须在思维链中精准保存每一步的中间变量。
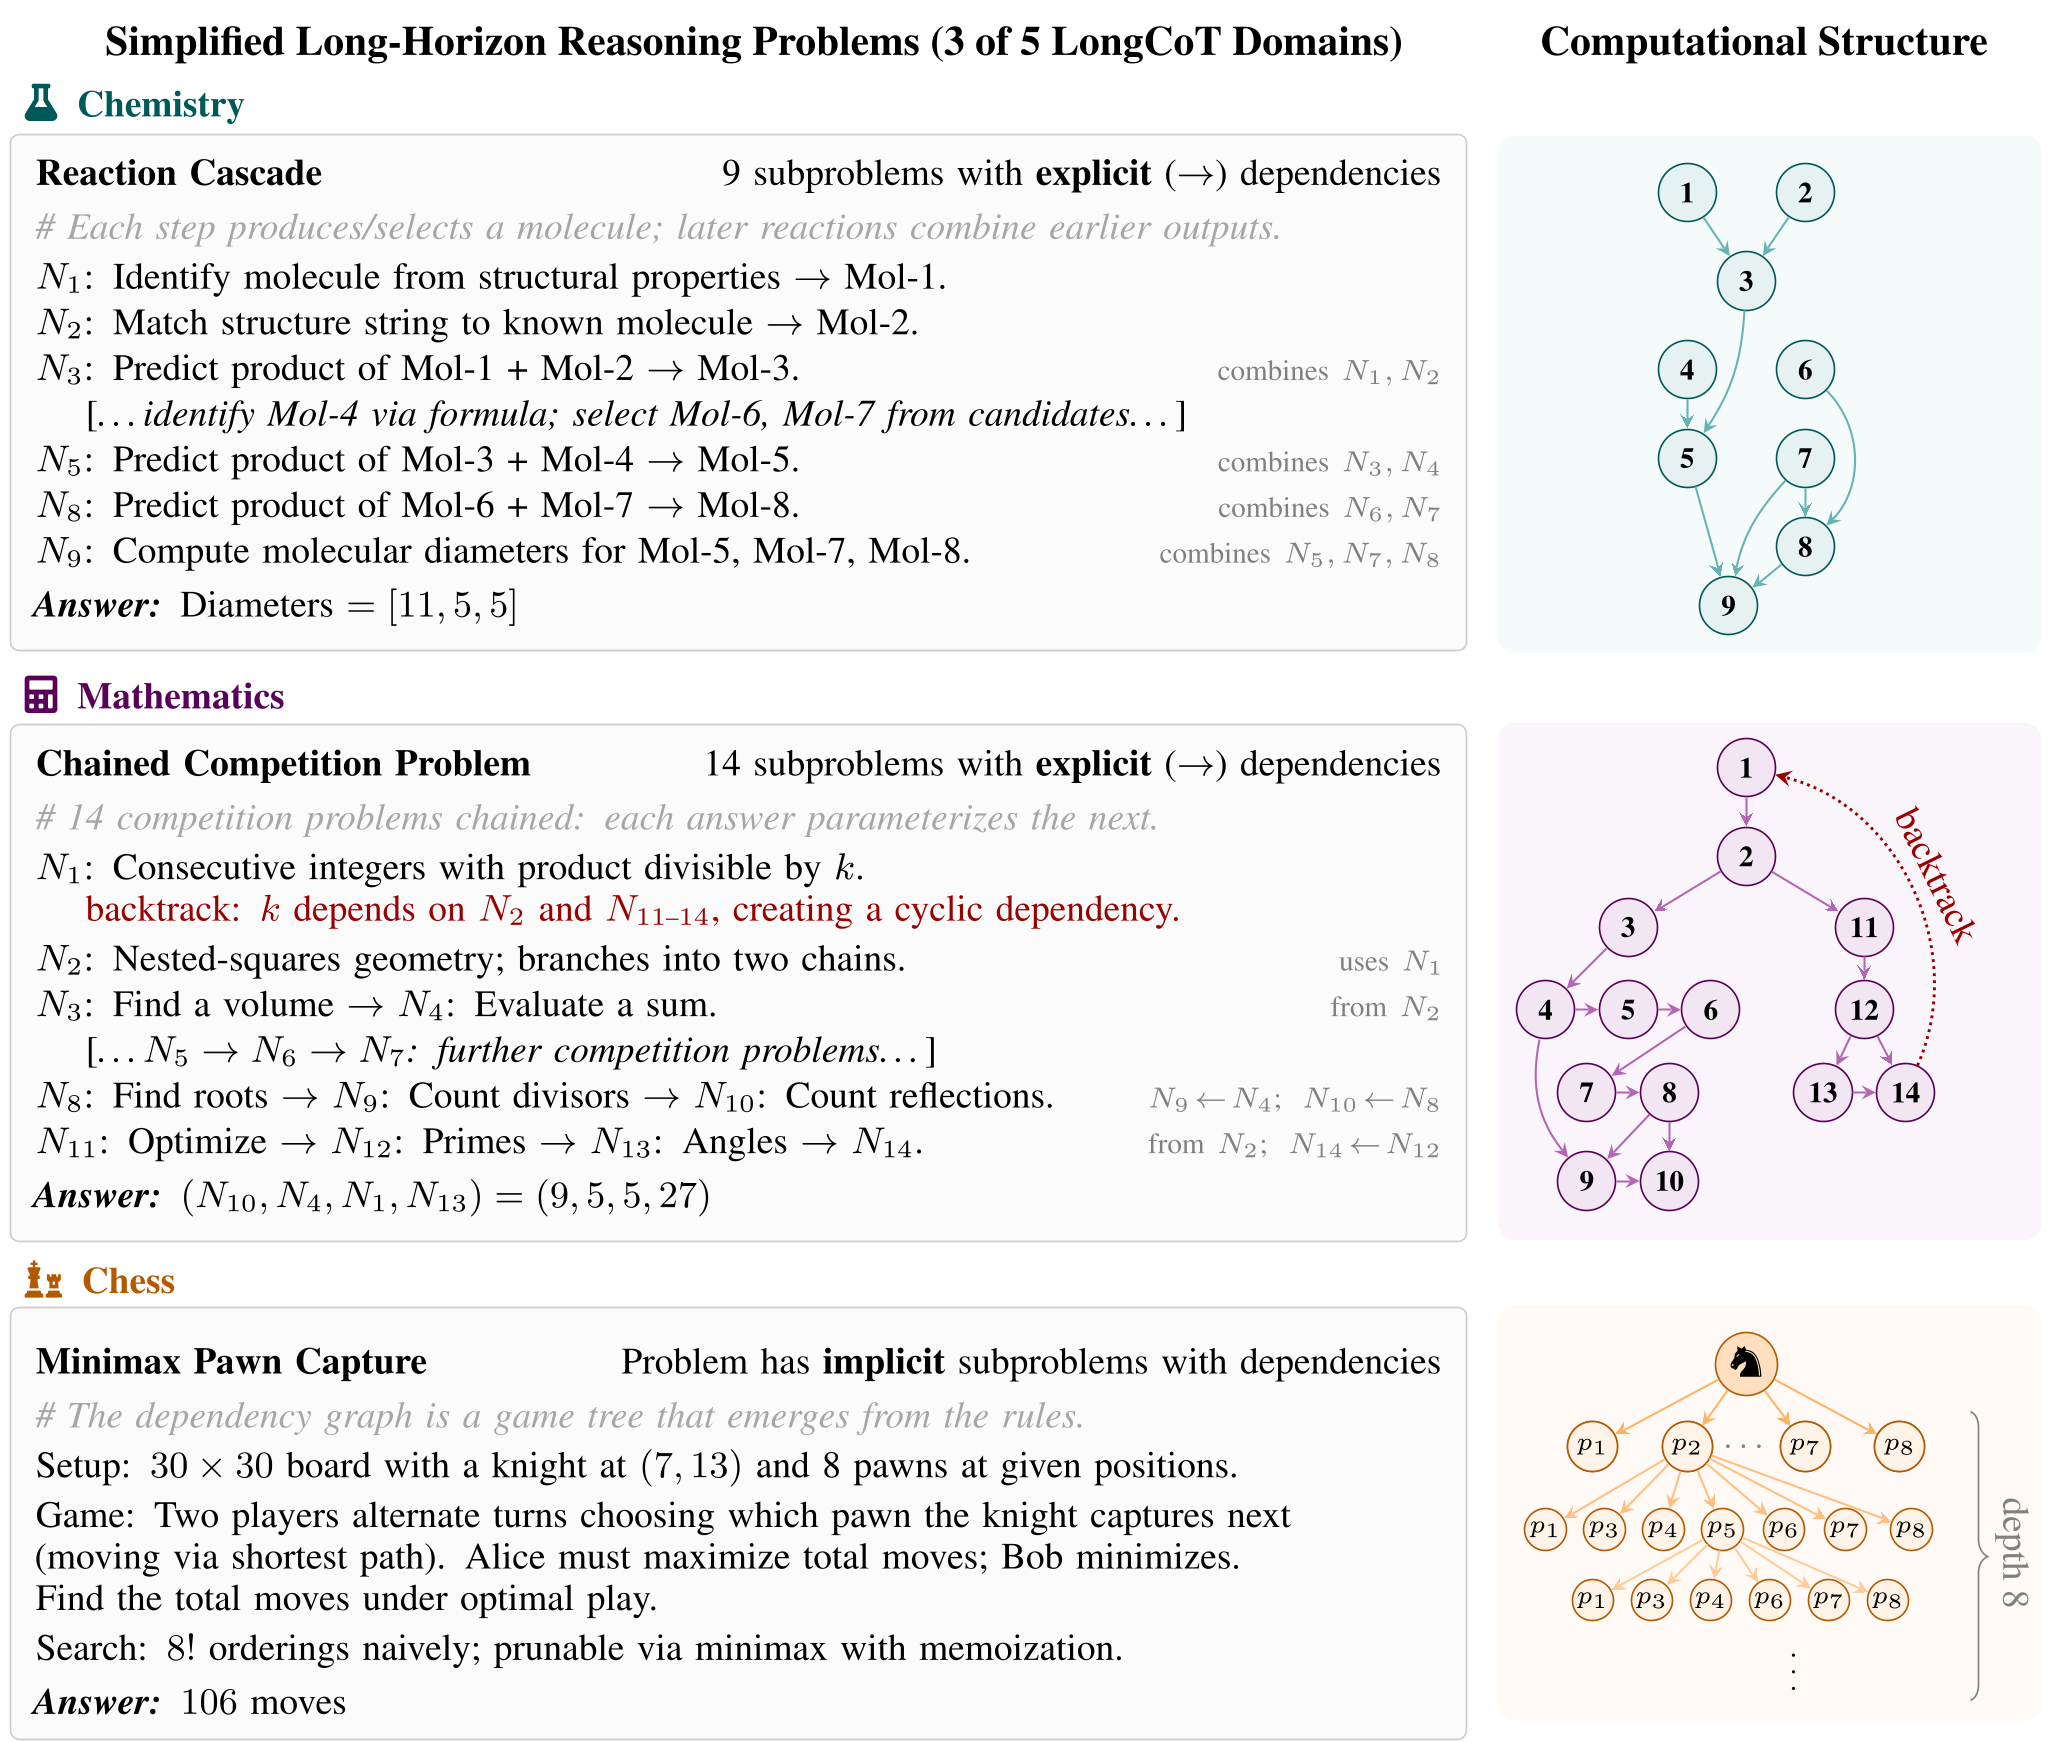 图 1:LongCoT 覆盖的五大领域及其背后的图论推理逻辑
3. 结果分析:断崖式下跌
实验结果令人震惊。即便是被认为具备“思考能力”的推理模型(Reasoning Models),在面对数万 Token 的任务时依然捉襟见肘。
- 性能极速退化:实验显示,当逻辑节点超过 15 个后,模型的性能开始雪崩。GPT 5.2 在 medium/hard 题目上的表现从 easy 题目的 38.7% 骤降至 9.83%。
- Token 使用量 vs 准确率:数据证明,那些“愿意想更久”(消耗更多 Token)的模型(如 GPT 5.2 平均 62K tokens)确实表现更好,但依然无法突破 10% 的瓶颈。
- 开源模型的差距:DeepSeek V3.2 和 Kimi K2 在 LongCoT-mini(简易版)上尚有一战之力,但在标准版上几乎全军覆没。
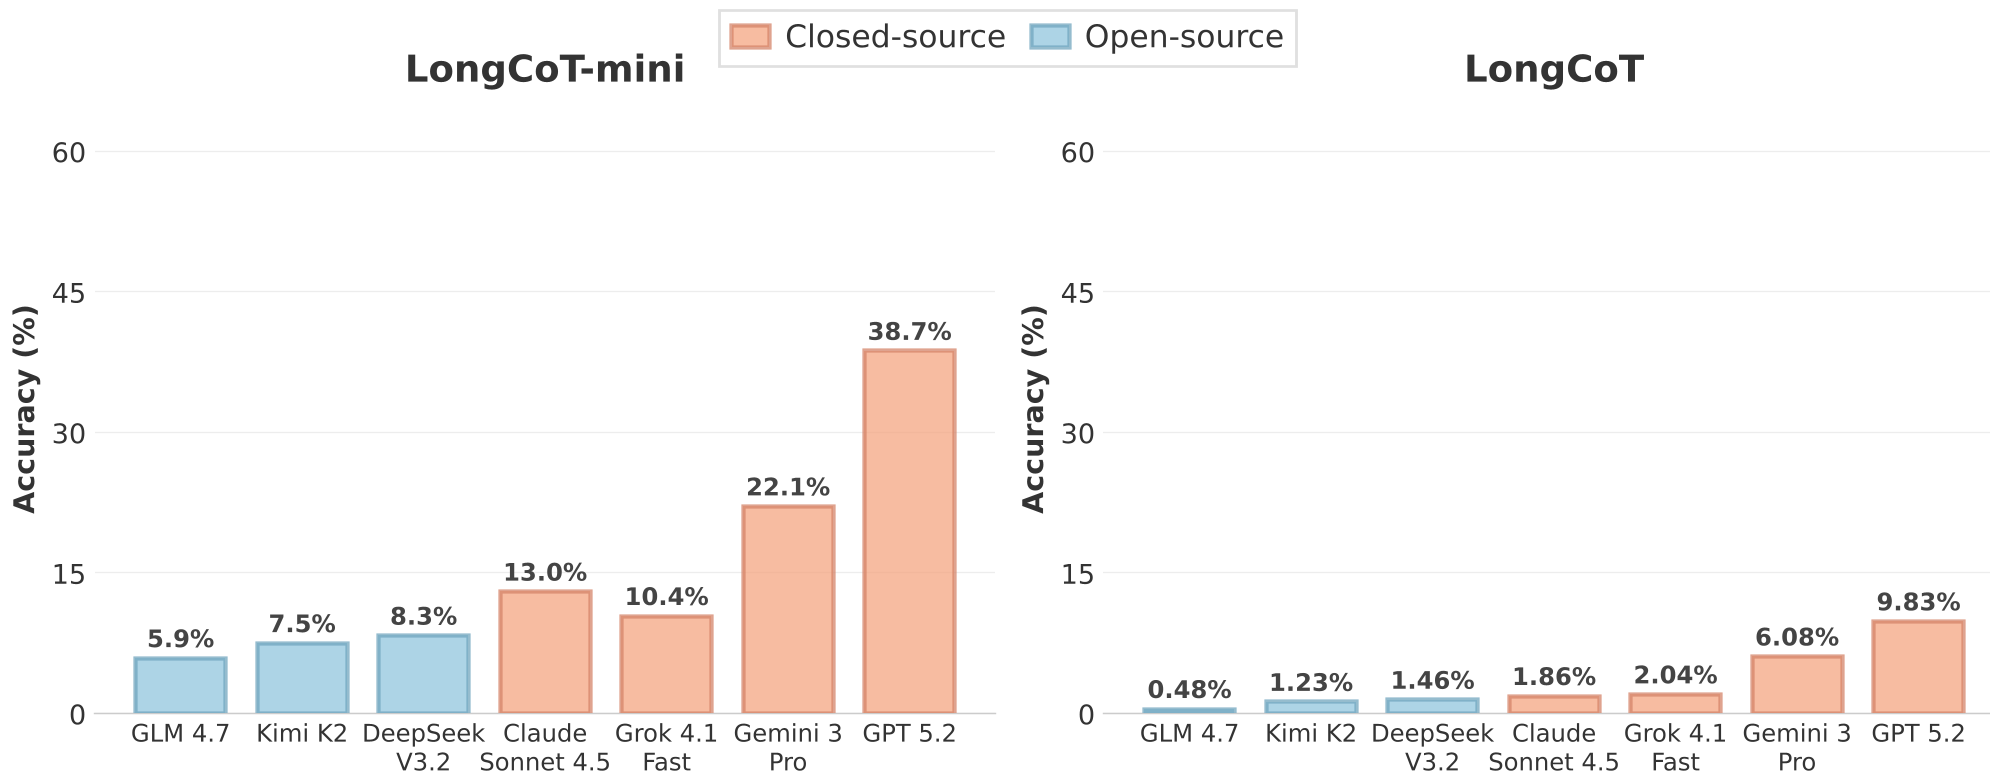 图 2:不同大模型在 LongCoT 上的惨淡战绩,右侧为标准版难度
4. 深度洞察:模型到底错在了哪里?
通过对推理轨迹(Reasoning Traces)的定性分析,作者总结了长程推理的几个核心败因:
- 早期规划(Early Planning)匮乏:模型在开始时没有制定好策略,导致后面陷入死循环。
- 回溯机制失效:正确推理的 Token 往往包含更多的“Setup(环境设置)”,而失败的推理则包含大量的“Backtracking”——这说明模型意识到错了,但改不过来。
- 捷径诱惑(Shortcutting):当 Context 过长时,模型倾向于通过模式匹配直接猜中间值,而非严谨计算,这导致了连锁崩溃。
5. 结论与展望:通往 AGI 的必经之路
LongCoT 表明,大模型在“系统 2(慢思考)”的稳定性上仍有巨大缺陷。仅仅增加 Context Window 的长度是不够的,我们需要:
- 训练更稳定的思维链:开发更具长程鲁棒性的 RL 训练目标。
- 更强力的递归模型(RLM):尽管目前的递归调用框架在 LongCoT 上提升有限,但这可能是解决长程状态管理的一个方向。
Summary:LongCoT 不仅仅是一个 Benchmark,它是对大模型“持久推理力”的一次极限压力测试。如果你认为 LLM 已经解决了逻辑问题,LongCoT 会用那 90% 的失败率告诉你:革命尚未成功。