
MARCH:模拟临床专家等级制度,突破 3D CT 报告生成的“幻觉”瓶颈
MARCH: Multi-Agent Radiology Clinical Hierarchy for CT Report Generation
本文提出了 MARCH,一种模拟放射科临床等级制度的多智能体框架,用于自动生成 3D CT 影像报告。该方法通过 Resident(住院医)、Fellow(专科培训医)和 Attending(主治医)三种角色的协同,在 RadGenome-ChestCT 数据集上实现了临床准确度和语言质量的 SOTA 性能。
TL;DR
在放射科,一份准确的报告通常需要经过住院医、专科医和主治医的多重审核。今日介绍的论文提出了一种名为 MARCH (Multi-Agent Radiology Clinical Hierarchy) 的新框架。它不再让 AI 孤军奋战,而是让多个 Agent 模拟真实的“临床会诊”流程,通过多轮博弈与共识达成,显著降低了 AI 在解读 3D CT 影像时的“一本正经胡说八道”现象,临床指标提升近 60%。
痛点深挖:为什么单体 AI 做不好 3D 影像报告?
目前的 Vision-Language Models (VLMs) 尽管在 2D 图像上表现出色,但在面对 3D 容积数据(如胸部 CT)时,面临着极大的挑战:
- 特征稀疏性:在成百上千张切片中,微小的病灶可能只在几层中出现,传统的“黑盒”模型容易漏诊。
- 缺乏校验机制:单体模型生成报告是“一锤子买卖”,没有医生之间那种“你觉得这是结节还是伪影”的反复推敲过程。
- 临床幻觉:模型常会产生看似专业但缺乏实际影像证据支撑的描述。
架构解析:Resident-Fellow-Attending 的“会诊中心”
MARCH 的核心创新在于它不只是一个算法,而是一套数字化的放射科科室架构。
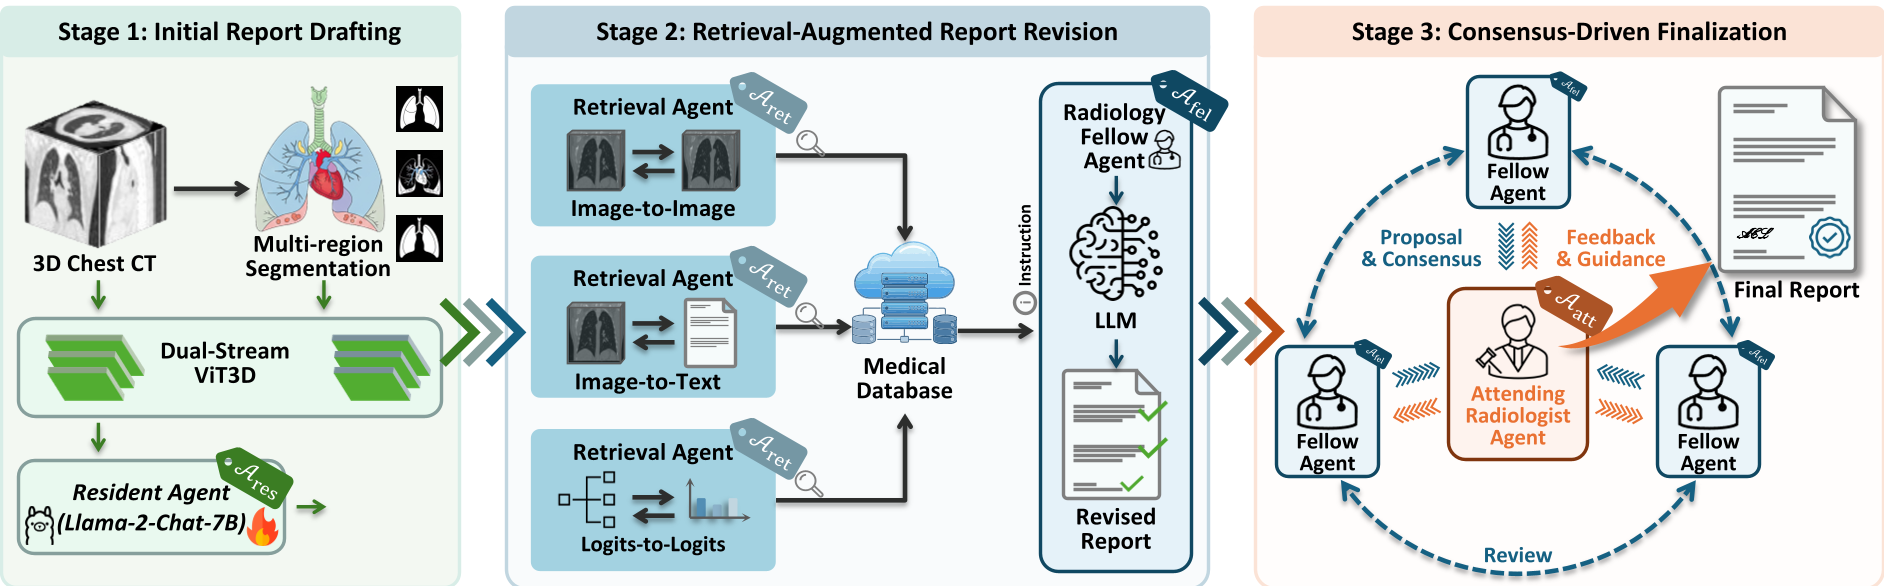
第一阶段:初稿生成(Resident Agent)
类似于刚入行的住院医,Resident Agent 利用预训练的 ViT3D 编码器和多区域分割模块,对 10 个解剖区域(如肺、心、骨骼)进行初步扫描,生成一份详尽但可能存在瑕疵的初稿。
第二阶段:检索增强修订(Fellow Agent)
Fellow Agent 扮演更有阅历的医生。它通过三种检索手段(图像相似度、文本相似度、病理逻辑概率)从临床数据库中调取出类似的成功案例,并以此为根据对 Resident 的初稿进行纠偏差错。
第三阶段:共识最终化(Attending Agent)
这是 MARCH 最具特色的部分。Attending Agent(主治医) 并不直接写报告,而是主持“会诊”。它收集所有 Fellow 的修改意见,发现矛盾点。各 Agent 会针对争议点表达“同意”或“反对”,并给出置信度。只有当所有智能体达成稳定共识,报告才会最终定稿。
实验战绩:全方位的跨越
MARCH 在大规模数据集 RadGenome-ChestCT 上进行了验证。

- 临床有效性(CE-F1):相比于之前的最优模型 Reg2RG (0.253),MARCH 直接跳升至 0.399,在识别微小病变(如心包积液、肺结节)时表现出极高的敏感性。
- 语言质量:BLEU 和 METEOR 指标均领先,意味着生成的报告不仅诊断准,表达也更专业。
- 消融实验证明:移除“共识决策(Finalization)”环节后,模型性能出现最显著的下滑,验证了“集体智慧”的重要性。
深度洞察:医学 AI 的本质是“降低不确定性”
MARCH 的成功不仅是工程上的胜利,更是对医疗 AI 的深层反思:
- Inductive Bias 的引入:通过将人类社会的层级结构引入 Agent 交互,给大模型注入了强烈的临床逻辑偏置。
- 可解释性的提升:在会诊流程中,我们可以清晰地看到哪个 Agent 对哪个结论提出了异议,这让原本“黑盒”的生成过程变得有迹可循。
总结与未来展望
MARCH 为高风险领域的 AI 应用指明了方向:与其追求更大的参数量,不如追求更合理的角色分工。
局限性:目前 MARCH 主要依赖闭源大模型(GPT-4 系列),推理成本较高。未来,如何使用高性能的开源医疗领域大模型(如 Med-Llama)替代关键岗位,并引入“人机耦合(Human-in-the-loop)”机制,将是该技术从实验室走向临床的关键。
Takeaway: 医疗 AI 的下一个阶段,或许不再是开发一个完美的“神医”模型,而是组建一支能够互相校验、达成共识的“数字医疗团队”。