
MATHNET:当 AI 能解奥数题,它真的理解数学的本质吗?
MATHNET: A GLOBAL MULTIMODAL BENCHMARK FOR MATHEMATICAL REASONING AND RETRIEVAL
本文推出了 MATHNET,这是一个大规模、多模态且多语言的奥数级数学竞赛基准测试。它包含来自 47 个国家、跨越 40 年的 30,676 道专家解答题目,支持解题(Problem Solving)、数学意识检索(Math-Aware Retrieval)及检索增强生成(RAG)三大任务。
TL;DR
MIT 等机构的研究者发布了 MATHNET,这是目前全球最大的多语言、多模态奥数竞赛基准测试。它包含 3 万多道由专家编写的高难度题目。研究发现了一个令人深思的现象:即便如 GPT-5、Gemini 1.5 Pro 等顶尖模型在解法生成上已渐入佳境,但在**识别两道数学题是否等效(数学检索)**这一基本能力上,几乎全军覆没。
1. 现状:被“刷榜”掩盖的数学黑盒
近年来,LLM 在 GSM8K 或 MATH 等数据集上的分数突飞猛进,甚至有报道称 AI 在 IMO(国际数学奥林匹克)中达到了金牌水平。然而,现有的 Benchmark 存在三个隐忧:
- 数据污染与局限:大多题目来自 AoPS 论坛,且集中于英语环境,模型可能只是背住了答案。
- 缺乏多模态:真实的数学竞赛充满了几何图形和图表,纯文本模型无法应对。
- “检索”能力的缺失:数学的核心在于“联想”,即发现当前问题与已知问题的结构共鸣。
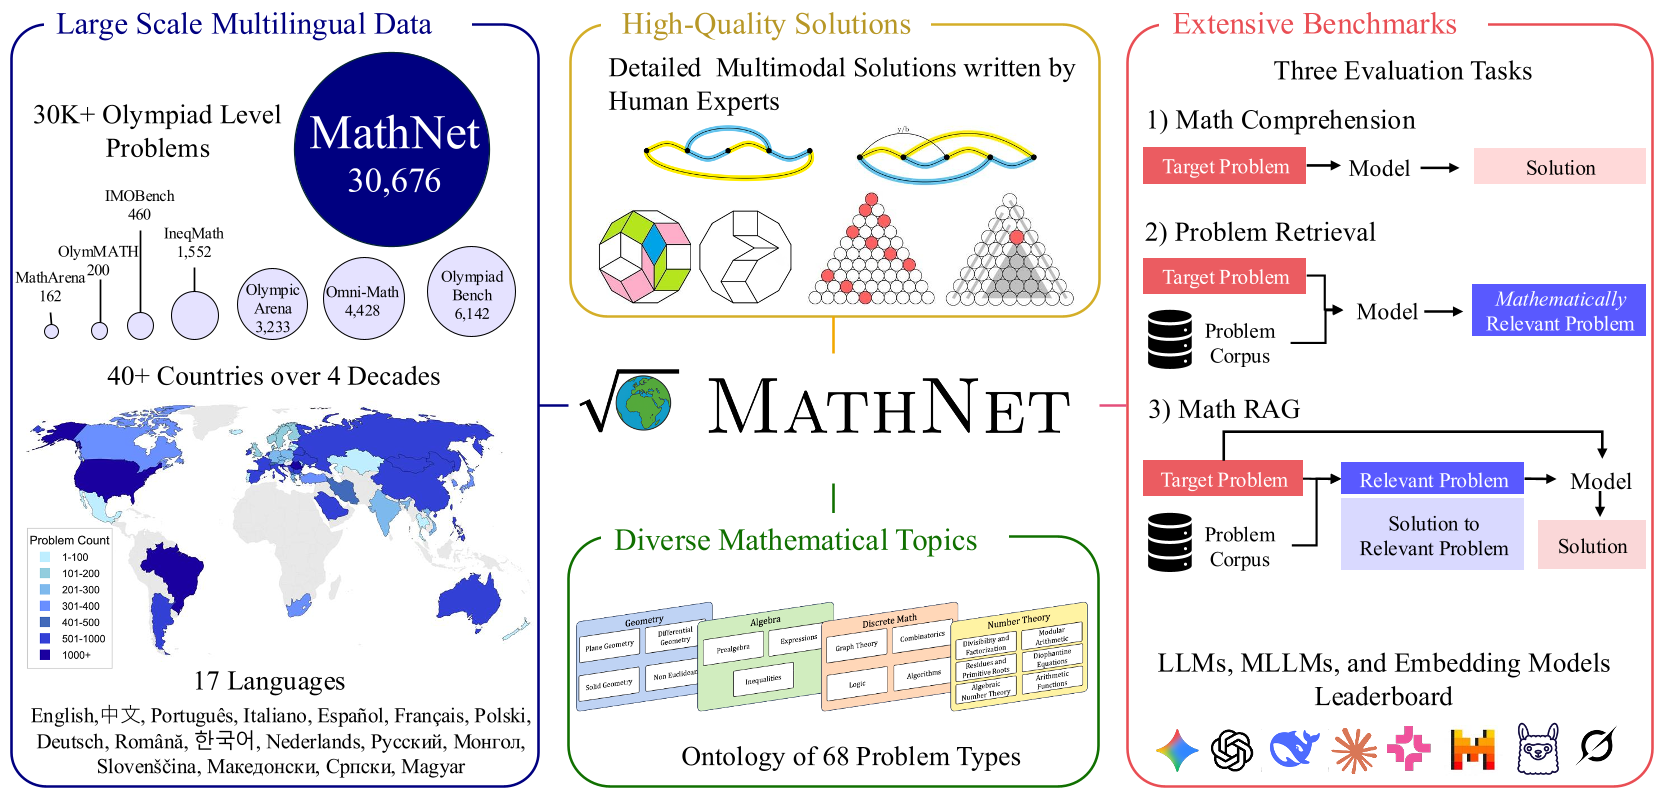 图 1:MATHNET 覆盖了全球 47 个国家、17 种语言,是一个真正的全球化评测基准。
2. 核心挑战:数学意识检索 (Math-Aware Retrieval)
MATHNET 最独特的贡献是提出了 Math-Aware Retrieval 任务。作者认为数学相似性分为三个层次:
- Invariance(不变性):题目 A 和 B 只是换了变量名或代数变形。例如 与 。
- Resonance(共鸣):题目不同,但可以使用相同的证明策略或引理。
- Affinity(亲和性):同属于一个细分领域(如数论中的素数判定)。
痛点在于: 现有的 Embedding 模型(如 OpenAI 的 text-embedding-3)极其容易被“表面字符”欺骗。如果你搜索一个关于三角形的题目,搜索结果会给你一堆单词里带“Triangle”的题目,而忽略那些结构相同但表述为向量形式的等价题。
3. 技术路线:从官方文档到结构化知识库
为了保证数据质量,作者没有爬取网页,而是通过 dots-ocr 框架解析了 1595 本官方竞赛小册子和 2.5 万页 PDF。
 图 2:三阶段数据提取管线。通过 LLM 进行分段、LATEX 格式化,并经过严格的 Rule-based 和人机协同验证。
4. 实验结果:检索性能的坍塌
在解题任务(Problem Solving)中,Gemini-3.1-Pro 展示了强大的统治力(78.4%),紧随其后的是 GPT-5(69.3%)。
但在检索任务中,情况急转直下:
- Recall@1 惨不忍睹:所有模型的 Top-1 检索准确率都在 5% 左右。
- 硬负样本的杀伤力:作者设计了“结构极其相似但数学本质完全不同”的干扰项(Hard Negatives),模型往往会把这些干扰项排在真正正确的等价题前面。
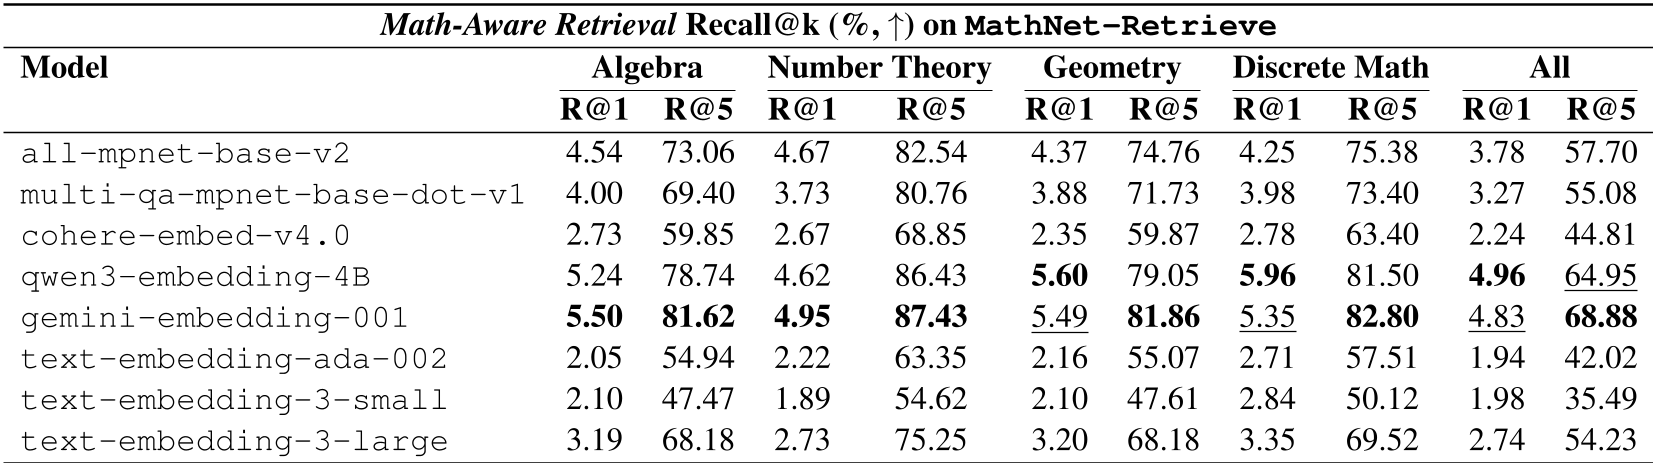 表 1:嵌入模型在不同学科(代数、数论、几何等)上的检索表现,即便最强的 Gemini Embedding 也无法突破认知瓶颈。
5. RAG 的价值:结构对齐是关键
研究进一步探讨了“检索增强生成(RAG)”的应用。实验发现:
- 普通 RAG 效果有限:如果检索回来的题目只是表面相似,非但不能帮模型解题,反而会引入噪声。
- Oracle RAG 潜力巨大:当人工强制模型参考“结构对齐”的专家配对题目时,DeepSeek-V3.2-Speciale 的解题准确率跃升至 97.3%。这说明模型目前缺的不是“计算力”,而是“类比联想力”。
6. 深度分析:未来路向何方?
MATHNET 给学术界敲响了警钟:
- 符号表征的匮乏:目前的 Embedding 模型是为自然语言设计的,对算式和符号结构的敏感度极低。
- 几何仍然是重灾区:无论解题还是检索,几何题的表现(50%-60%)远低于代数题。
- 从 Next-token 到符号推理:要解决奥数问题,模型必须能识别题目背后的物理直觉或逻辑不变量。
总结:MATHNET 不仅仅是一个评测集,它揭示了通往 AGI 的必经之路——AI 必须学会像数学家一样思考,而不仅仅像打字机一样堆砌符号。
更多详情请访问官方项目页:mathnet.mit.edu