
MUA:让超细节数字人跑进 VR 头显,计算量直降 2000 倍
MUA: Mobile Ultra-detailed Animatable Avatars
本文提出了 MUA,一种专为移动端(如 Meta Quest 3)设计的超细节可动画人体数字人方案。核心通过“小波引导的多级空间因子化混合形状”(Wavelet-guided Multi-level Spatial Factorized Blendshapes)技术,实现了对 3D Gaussian Splatting 纹理的高效压缩与动态建模,达到了 SOTA 级别的渲染质量。
TL;DR
在数字人领域,高性能与轻量化似乎一直是一对矛盾。顶级模型如 UMA 能渲染出丝滑的衣物褶皱,但需要服务器级 GPU 才能跑动;而轻量化模型能在手机上跑,画面却像“纸片人”。来自马普所等机构的学者提出了 MUA,通过小波引导的多级因子化混合形状,将计算量削减了三个数量级,首次让超保真、可动画的数字人在 Meta Quest 3 上实现了 24 FPS 的原生实时运行。
背景:2D 卷积的“昂贵”代价
目前最强的人体数字人通常基于 3D Gaussian Splatting (3DGS),并使用复杂的卷积神经网络(如 UNet)在 UV 空间预测高斯球的属性(位置、颜色、缩放等)。
- 痛点:2D 卷积在处理 768x768 甚至更高分辨率的特征图时,内存带宽和计算压力极大。
- 挑战:如何在不丢失那些随动作变化的动态褶皱(Clothing Dynamics)的前提下,甩掉沉浸式体验中沉重的计算包袱?
核心方法:小波分解 + 空间因子化 (Wavelet Factorized Blendshapes)
MUA 的核心直觉在于:不同频率的信息,应该用不同的方式去压缩。
1. 小波域的魔法对比
作者没有直接在图像空间死磕,而是利用离散小波变换 (DWT) 将高斯纹理分解。
- 低频子带 (Low-frequency):承载了大部分运动轮廓,分辨率极低(48x48),直接用 Blendshapes 处理,性能开销微乎其微。
- 中高频子带 (High-frequency):表现为衣物细纹。这些信号在空间上非常稀疏。MUA 采用 1D 因子化分解——将 2D 纹理看作两个 1D 向量的外积(Outer Product)。这种方式能以极小的参数量捕捉复杂的边缘信息。
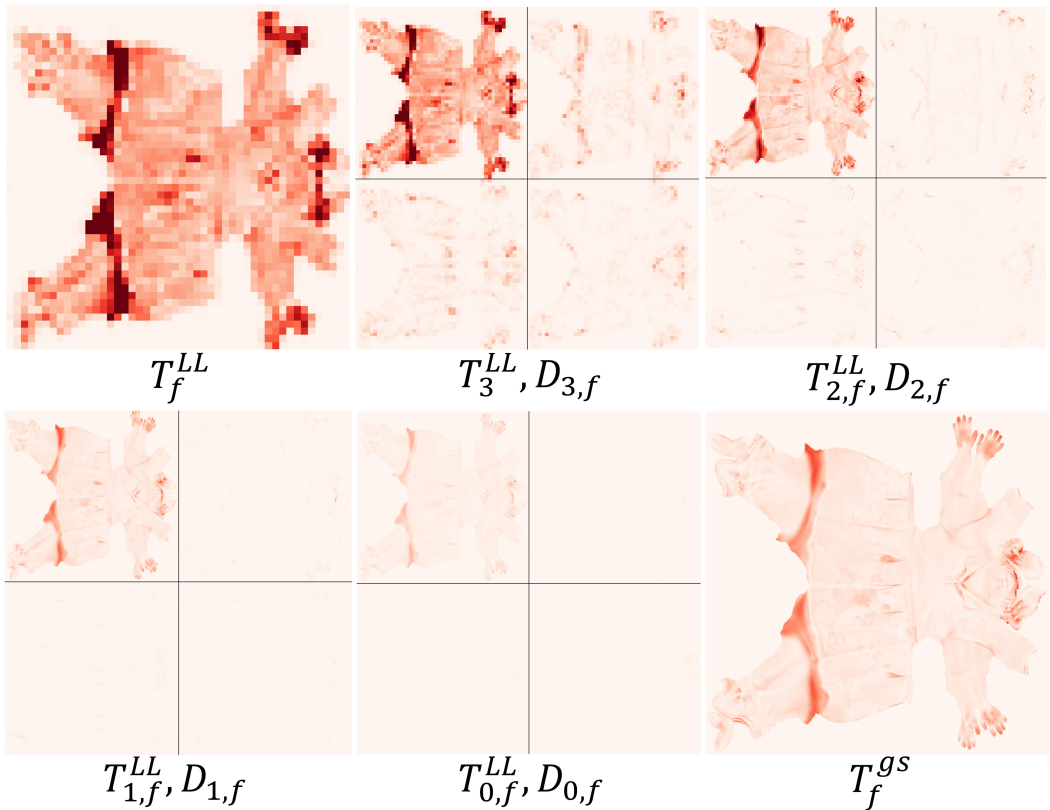 图 1:MUA 的多级分解架构。通过将纹理分频,低频用 2D 基,中频用因子化 1D 基,高频预计算,极大降低了推理成本。
2. 知识蒸馏管线
为了继承顶级模型的效果,MUA 采用了教师-学生蒸馏方案。从高精度的 UMA 模型中提取动态几何和外观,将其“浓缩”进 MUA 的紧凑表示中。
实验战绩:降维打击
MUA 在与目前最强的服务器级和移动级模型对比中,展现了惊人的效率:
- 计算量:仅需 0.52 GFLOPs,相比教师模型 UMA (1804 GFLOPs) 降低了约 3400 倍。
- 渲染速度:在 RTX 3090 上跑出了 182 FPS,在移动端 Meta Quest 3 上原生达到 24 FPS,甚至比一些服务器方案还要快。
- 画质保留:即使参数量剧减,模型依然保留了细致的纹理图案和随动作变化的动态褶皱。
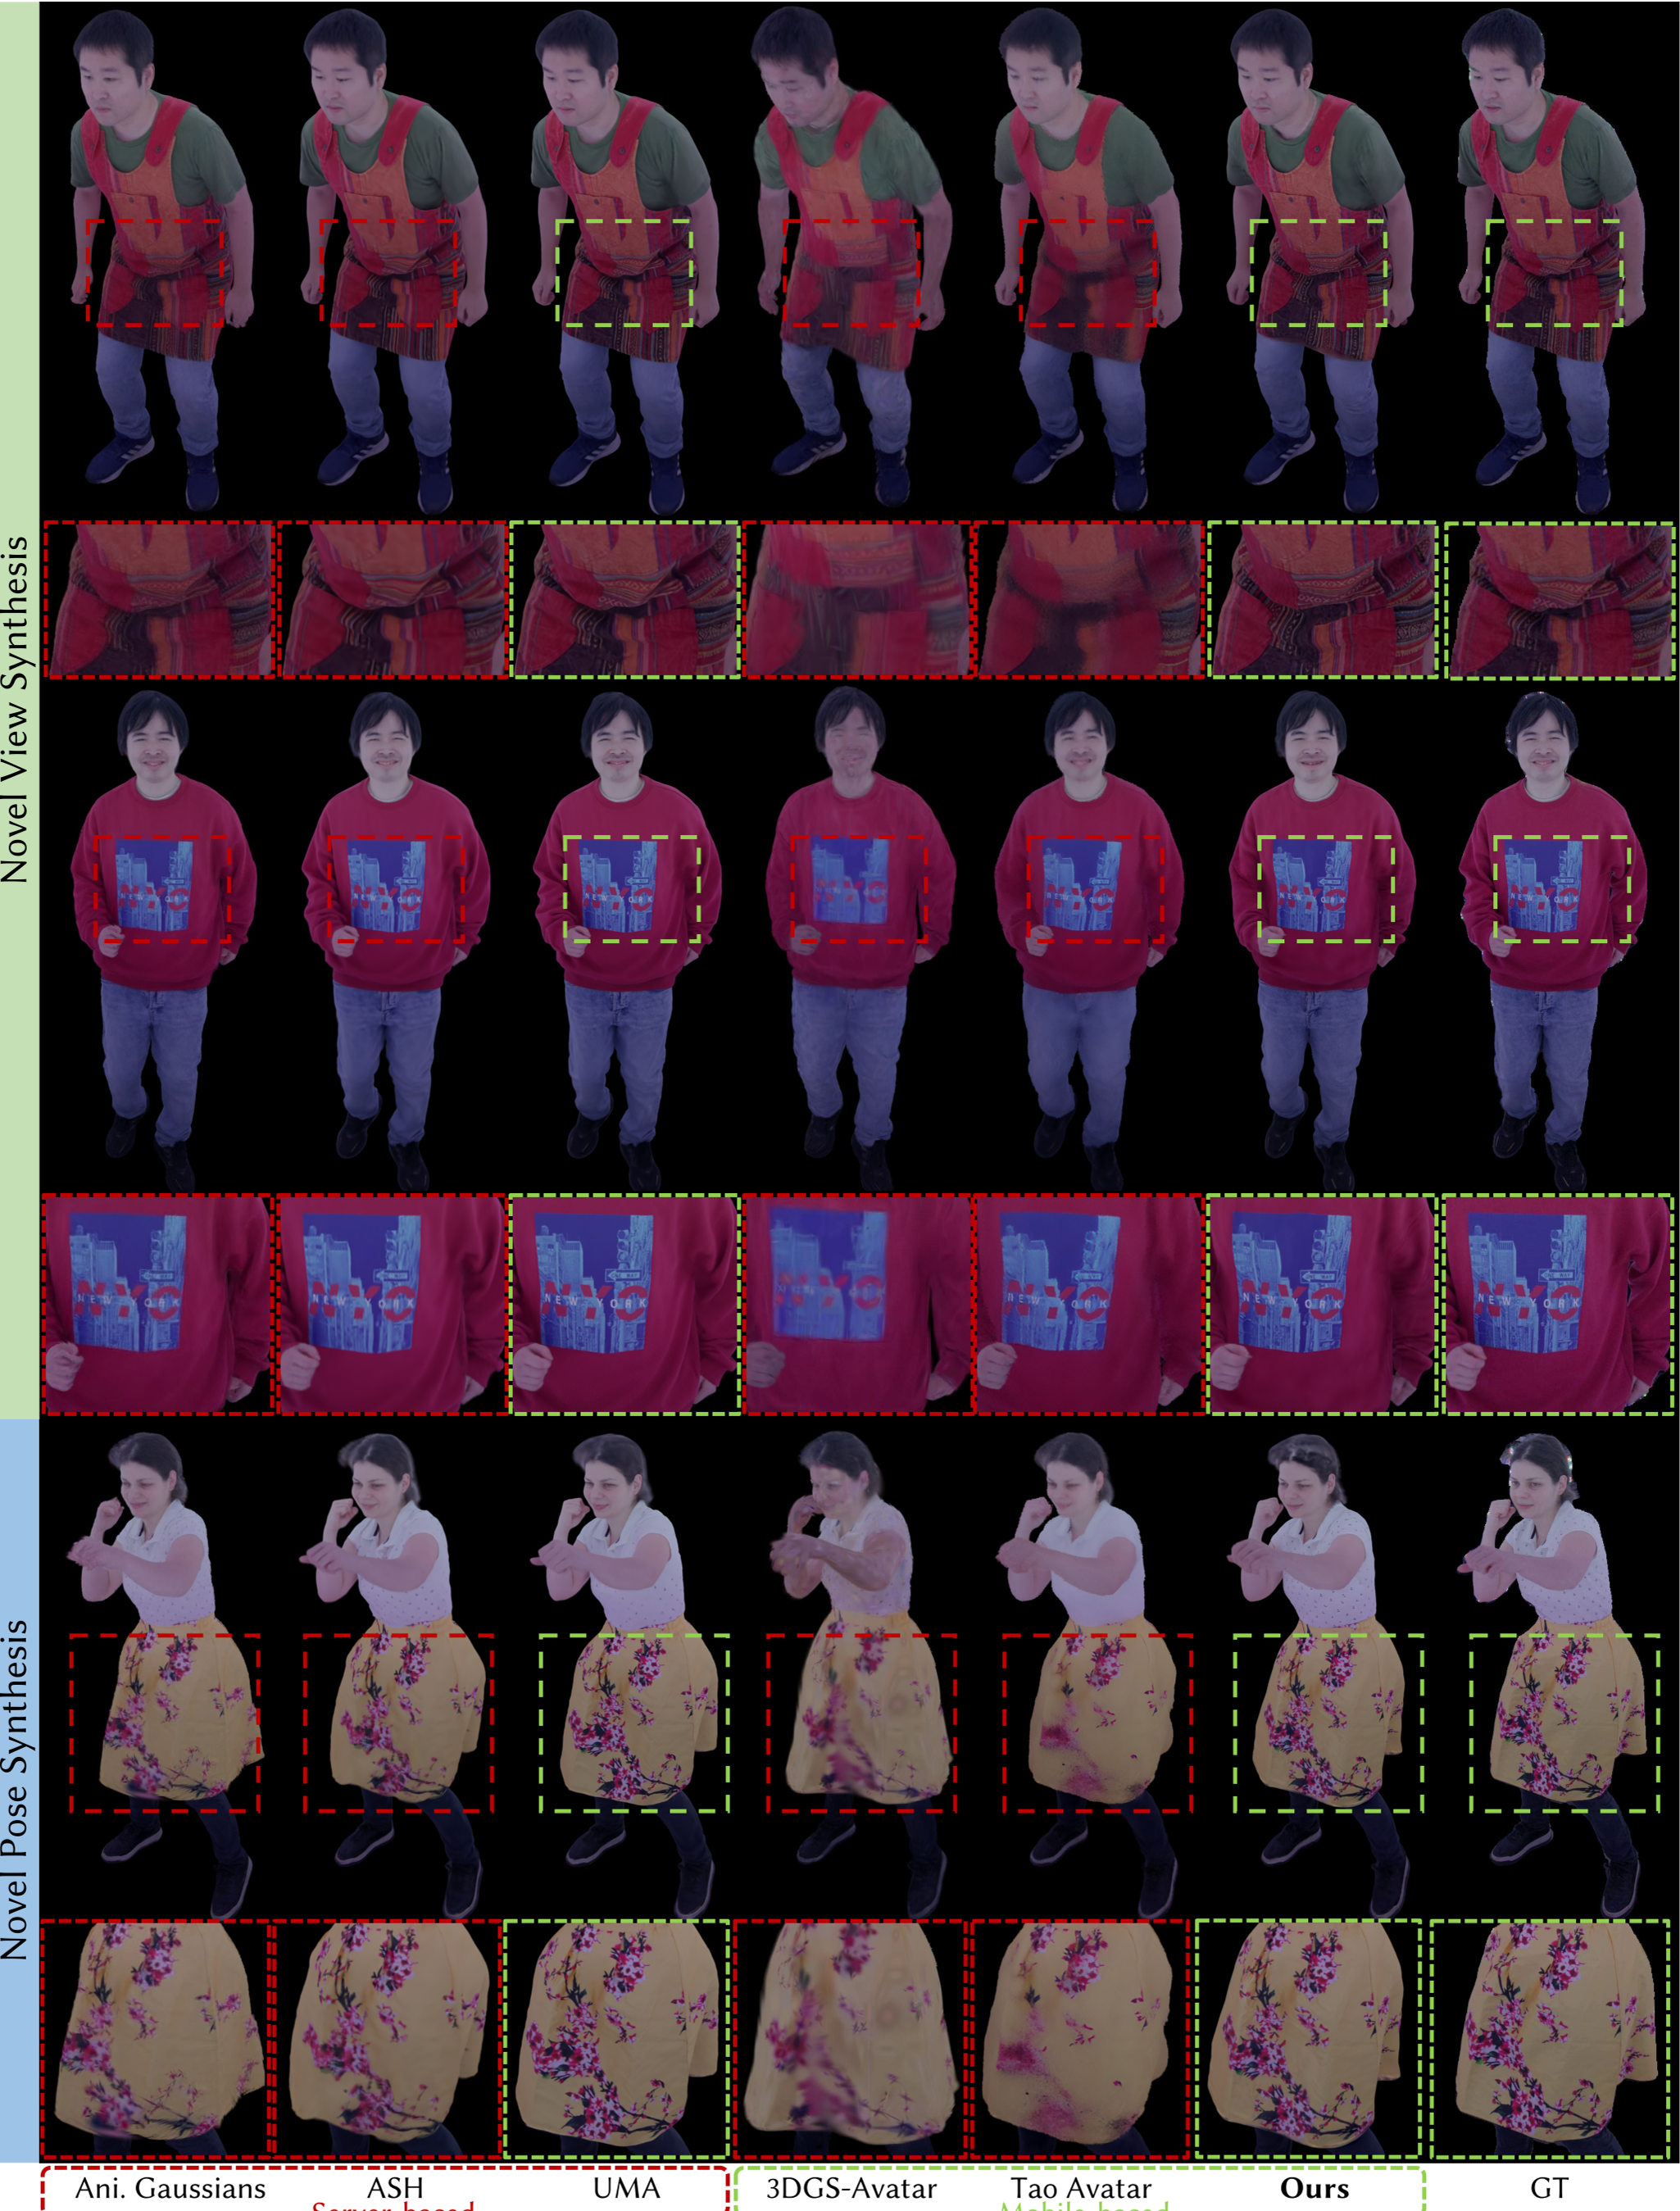 图 2:定性对比显示,MUA 在纹理清晰度和动态褶皱的表现上显著优于此前的移动端方案 TaoAvatar 和 3DGS-Avatar。
深度洞察
MUA 的成功在于它精准捕捉了神经表征中的归纳偏置 (Inductive Bias)。
- 分频处理的物理意义:它不仅是数学压缩,更符合物理直觉——大范围动作影响全局低频,而局部褶皱属于高频稀疏信号。
- 逃离卷积层:通过将 2D 卷积任务转化为基于混合形状系数的线性组合,消除了显存带宽的瓶颈。
总结与未来
MUA 标志着高保真数字人从实验室走向消费级移动设备迈出了坚实的一步。虽然目前它还不支持换装(衣物未解耦)和外部物理力交互(如强风吹动衣物),但其在效率上的突破为 VR 社交、远程办公和移动游戏场景提供了极具竞争力的底层支柱。
未来的研究方向可能包括:多模态驱动(语音、文本直接驱动数字人)以及更彻底的衣物与身体解耦,从而实现个性化的虚拟试衣。