
NaijaS2ST:打破低资源偏见,重塑尼日利亚多口音语音翻译基准
NaijaS2ST: A Multi-Accent Benchmark for Speech-to-Speech Translation in Low-Resource Nigerian Languages
本文推出了 NaijaS2ST,这是一个针对尼日利亚低资源语言(伊博语、豪萨语、约鲁巴语及尼日利亚皮钦语)与英语对齐的多口音语音翻译(S2ST)基准数据集。该研究通过对比级联式(Cascaded)、端到端(E2E)及语音大模型(AudioLLM)方法,证明了 AudioLLM 在 Few-shot 场景下于语音转文本(S2TT)任务中表现卓越,并为非洲语言语音研究奠定了基础。
TL;DR
在 AI 领域,非洲语言常被视为“被遗忘的角落”。本文推出的 NaijaS2ST 不仅填补了尼日利亚四大语言(豪萨语、伊博语、约鲁巴语、尼日利亚皮钦语)大规模平行语音翻译数据的空白,还通过深度对比 级联系统、端到端 (E2E) 模型和语音大模型 (AudioLLM),揭示了一个重要趋势:在低资源环境下,具备强大 Few-shot 能力的语音大模型正在全面超越传统微调架构。
1. 痛点:被忽视的 3 亿人口与口音鸿沟
尽管 Transformer 架构在语音领域大放异彩,但对于拥有 2000 多种语言的非洲大陆,现有的数据集(如 Flores-101)仅覆盖了不足 1%。
- Prior Work 的局限:之前的非洲语言语音集(如 BibleTTS)多用于简单的 ASR(语音识别)或 TTS(语音合成),缺乏用于 S2ST(语音到语音翻译)的平行语料。
- 研究直觉:作者认为,真实的语音翻译不应仅停留在标准发音,必须涵盖具有挑战性的 多口音 (Multi-accent) 环境,特别是尼日利亚口音英语与本地语言的复杂转换。
2. NaijaS2ST 数据集:真实与高质量的平衡
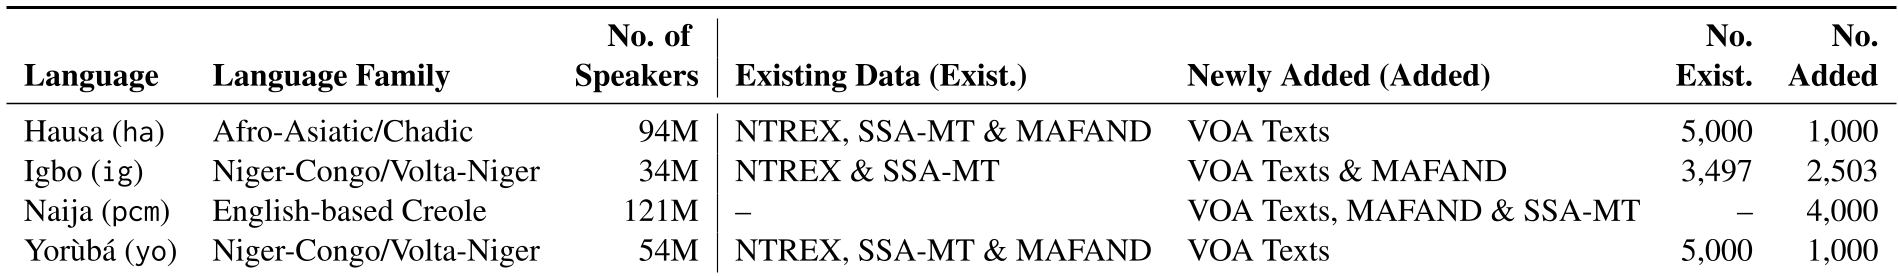
NaijaS2ST 包含了约 50 小时/每语言的高质量录音,由 32-72 名志愿者在真实环境下录制。
- 语言特性:涵盖了具有挑战性的调性语言(如约鲁巴语的三个声调)和黏着语(如豪萨语)。
- 质量控制 (QC):通过 Telegram 和 WhatsApp 远程协作,采用严格的人工抽检,剔除背景噪声过大或音量过低的样本。
3. 核心发现:建模范式的降维打击?
文章对三种主流架构进行了地毯式评估:
3.1 语音大模型 (AudioLLM) 的崛起
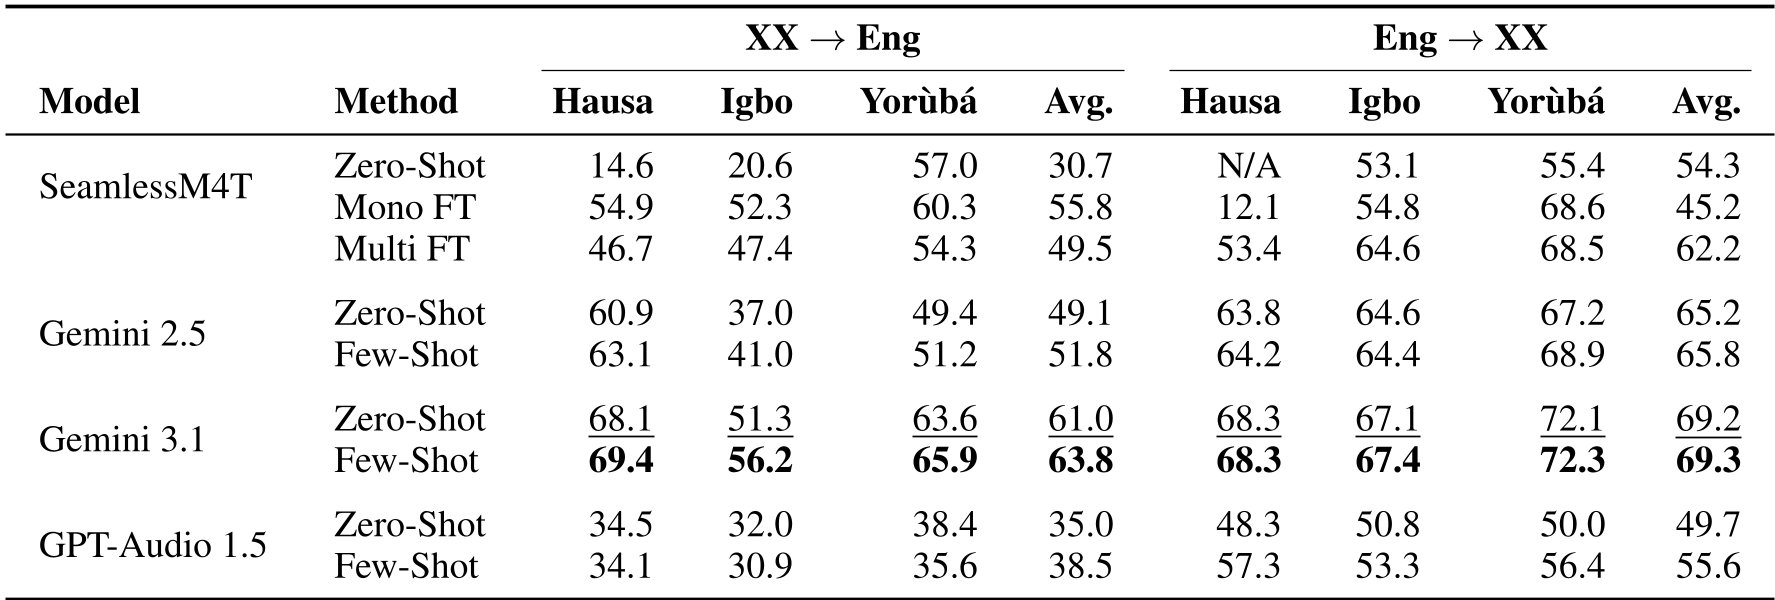
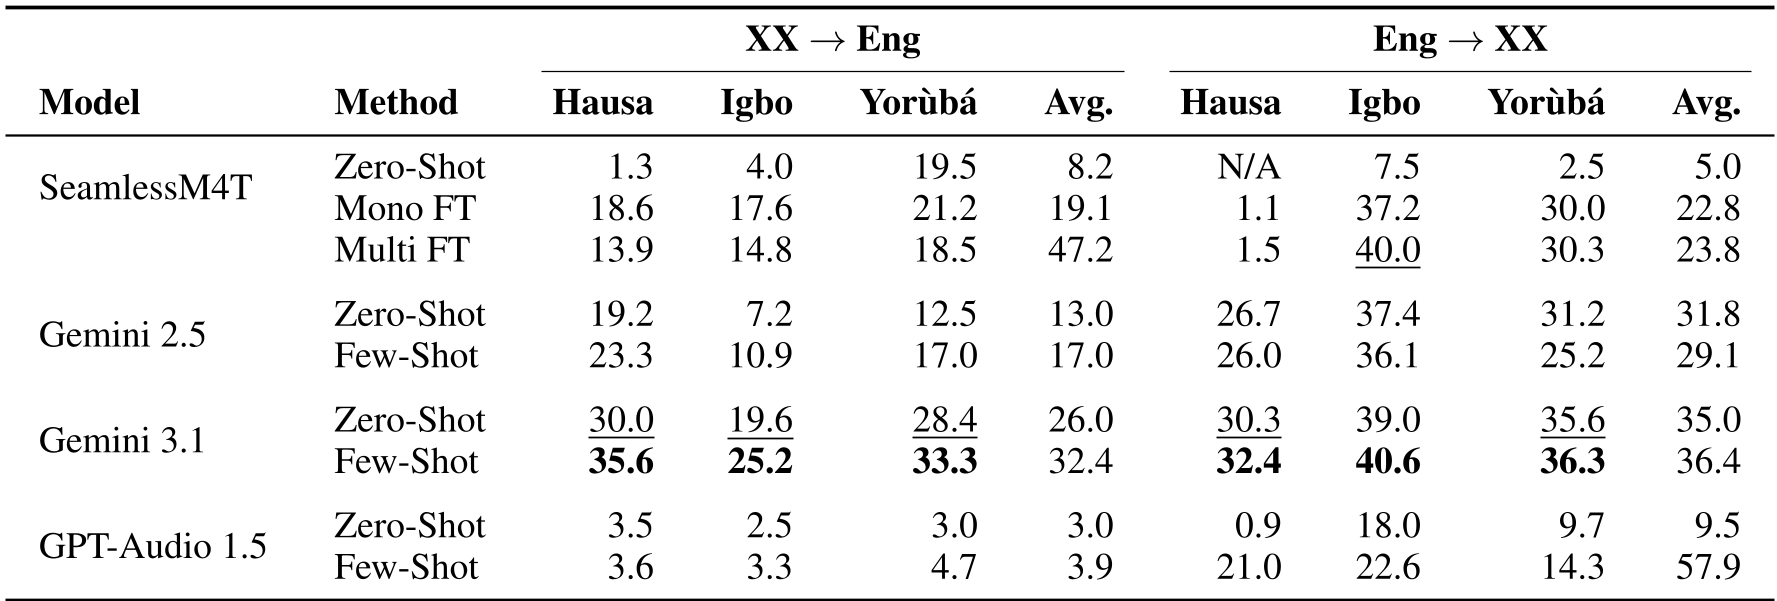
实验显示,Gemini 3.1 在无需复杂微调的情况下,仅通过 5-shot 提示(Few-shot prompting),在语音转文本 (S2TT) 上轻松击败了经过深度微调的 SeamlessM4T 模型。
- Why? 大模型在海量的跨模态预训练中掌握了更强的跨语言对齐语义,这种内生能力在极低资源场景下远比小规模数据微调更稳健。
3.2 级联系统 (Cascaded) 的顽强生命力
在最难的语音到语音 (S2ST) 任务中,级联系统(ASR + MT + TTS)的表现竟然与 AudioLLM 旗鼓相当。
- Insight:这说明目前 S2ST 的瓶颈不在于语音生成的流畅度,而在于中间的翻译质量。只要 ASR 足够准,配合强大的级联 MT 系统(如 NLLB),依然能维持极高的竞争力。
4. 实验详解:微调的“方向性”效应
作者发现了一个有趣的现象(Ablation Study):
- 本地语言 → 英语:单语微调 (Mono-FT) 效果最佳。这可能是因为英语本身是超高资源,模型主要需要适应特定的源语言特征。
- 英语 → 本地语言:多语微调 (Multi-FT) 收益更高。通过共享的多语言表示学习,低资源语言可以从彼此的语族共性中“借力”。
5. 深度洞察与总结
- 评估指标的隐忧:传统的 ChrF 或 BLEU 在处理约鲁巴语等重度依赖变音符号(Diacritics)的语言时会失效。本文采用了 SSA-COMET,这是一种基于嵌入的评估模型,更能捕捉低资源语言的语义相似度,而非仅仅是字符匹配。
- 局限性:虽然精度提升了,但 AudioLLM 的推理成本和延迟(Latency)仍是落地非洲移动端设备的主要障碍。
Takeaway:NaijaS2ST 不仅仅是一个数据集,它证明了即使在数据稀缺的条件下,通过合理的模型选择(优先探索 AudioLLM)和针对性的训练策略(方向相关的微调),我们依然可以跨越数字鸿沟,让 AI 真正实现“语言民主化”。未来,研究重点应平衡模型性能与边缘侧推理效率的矛盾。