
NPO:让“未来的自己”教“现在的自己”,突破 RL 性能瓶颈
Near-Future Policy Optimization
本文提出了 Near-Future Policy Optimization (NPO),一种针对大模型强化学习(RLVR)的新型混合策略方案。该方法通过让当前模型学习其训练过程中的“近未来”检查点(Checkpoint)生成的正确轨迹,在 Qwen3-VL-8B 等多模态任务上实现 SOTA 性能,平均准确率提升 4.96% 至 5.27%。
TL;DR
在强化学习(RLVR)领域,寻找高质量的引导信号一直是核心难题。来自 CAS、JD.COM 的研究团队提出了 Near-Future Policy Optimization (NPO)。其核心逻辑非常浪漫且高效:不向外部专家求助,而是利用同一个训练流中几步之后的“未来检查点”来指导当前的训练。 这种方法完美平衡了学习信号的质量(Quality)与方差成本(Variance),在多模态推理任务上实现了显著的性能跨越。
痛点深挖:外部专家太远,历史经验太菜
在进行带有验证奖励的强化学习(RLVR)时,纯粹的 On-policy 探索面临两个极端限制:
- 早期冷启动:模型太弱,探索不出正确答案,没有学习信号。
- 后期收敛瓶颈:模型多样性(Entropy)下降,陷入局部最优,无法突破。
传统做法要么引入外部教师(如 GPT-4 的轨迹),但这就像让小学生直接学微积分,分布差距(Distributional Gap)太大,导致梯度方差爆炸;要么回放历史,但这就像在旧纸堆里找灵感,质量上限被锁死。
作者提出了一个优雅的数学定义:有效学习信号 。
- (Quality):未来版本能解决当前版本失败问题的比例。
- (Variance):重要性采样引入的方差。
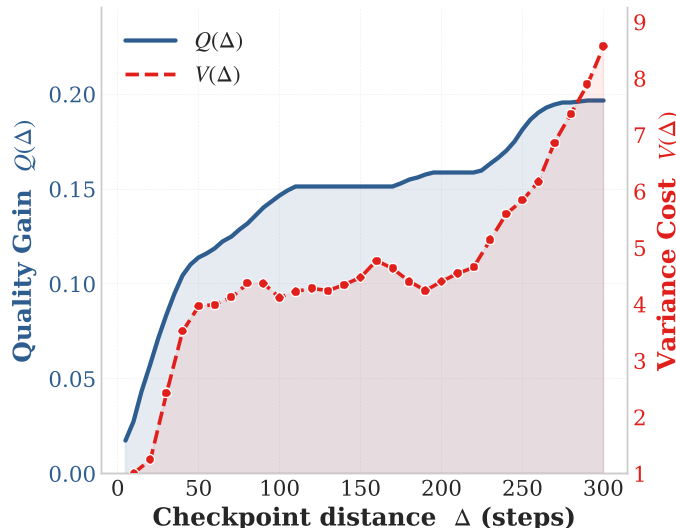 图 1:现有方法(左下和左上)均处于亚优区,而 NPO(右上)实现了高 Q 与低 V 的平衡。
Methodology:近未来策略优化
NPO 的操作极其直观:在训练到第 步时,先试探性地往前多跑 步得到检查点 。然后,用这个“近未来”的自己生成正确轨迹,替换掉当前训练组(Group)中一个表现不佳的槽位。
为什么“未来自我”是完美的老师?
- 血缘近:相同的架构、初始化和优化路径,意味着参数偏差极小,方差 受控。
- 能力强:经过更多的梯度下降,它已经掌握了当前模型正在挣扎的“临门一脚”,提供高 。
AutoNPO:全自动的“时间穿越”
为了避免人工设置 的繁琐,作者设计了 AutoNPO。它像一个监控仪:
- 触发器:监控奖励(Reward)是否平顿,且熵(Entropy)是否持续下降。如果两者同时发生,说明模型陷入了“探索崩塌”。
- 自动回滚:计算不同 下的 ,找到那个让增益最大的“近未来”时间点,执行回滚训练。
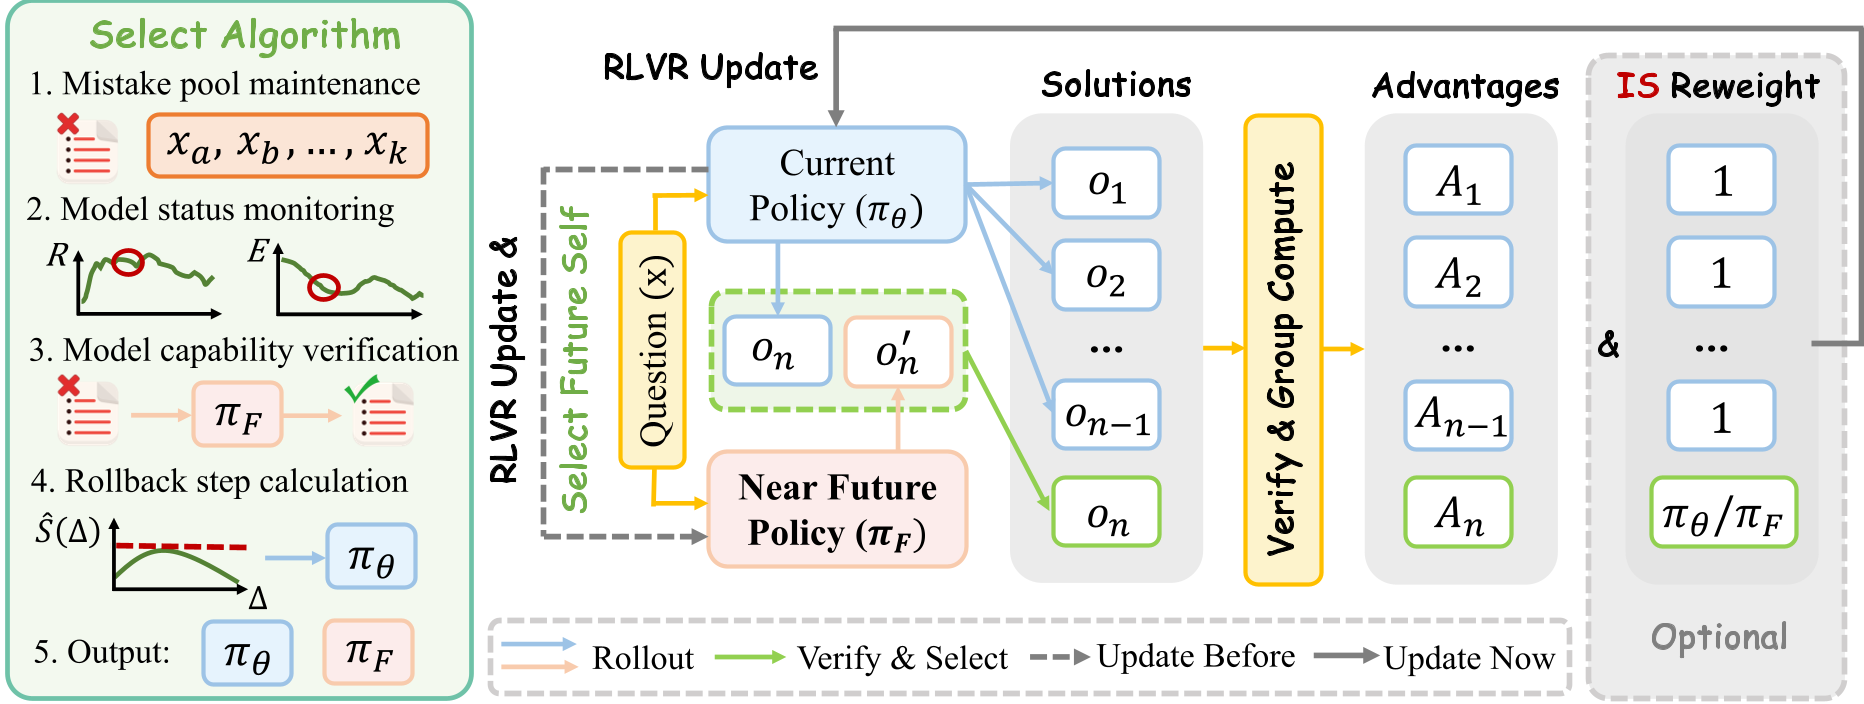 图 2:AutoNPO 的在线监控与自适应介入机制。
实验与结果:全线突破 SOTA
在 Qwen3-VL-8B 上的测试涵盖了 MathVista、MMMU-Pro 等 8 个高难度基准:
- 平均得分:从 57.88(Base)大幅提升至 63.15。
- 对比实验:相比于直接回放最强模型轨迹的 RLEP(61.48)和外部教师引导的 LUFFY(58.68),NPO 表现出极强的稳定性。
- 消融实验:有趣的是,在这种模式下,甚至不需要做复杂的重要性采样(IS)修正,训练依然稳健。
 表 1:NPO 在各类多模态推理任务中全面领先。
深度洞察:强化学习的“自愈”能力
NPO 的成功给了我们一个很强的启示:大模型的推理潜力被低估了。很多时候,模型无法通过 RL 进一步提升,并不是因为它上限在此,而是因为当前的探索机制太低效。
通过引入“近未来”的轨迹,模型实际上是在进行一种分布平滑。它通过未来的正确答案,强行拉回了即将崩塌的搜索空间。这种“ temporal bootstrapping ”(时间引导)不仅加速了初期的冷启动,更在后期打破了由于熵减带来的性能瓶颈。
总结与局限
NPO 的价值在于其极低的接入成本和显著的鲁棒性。它不需要额外的教师模型,也不需要复杂的奖励函数工程。
然而,其局限性在于计算开销:为了获得“未来检查点”,不可避免地需要进行部分路径的预计算或重复训练。未来的研究方向可能会集中在如何在不实际执行完整回滚的情况下,预测并生成这些“近未来”的学习信号。
这项工作是“Self-Taught RLVR”范式的重要成员,标志着大模型正在从单纯的“模仿人类”向“自我演化”的方向迈进。