
别再对 AI 盲目客气:跨语言视角下的礼貌效应深度解析
No Universal Courtesy: A Cross-Linguistic, Multi-Model Study of Politeness Effects on LLMs Using the PLUM Corpus
本文通过 PLUM 语料库研究了礼貌程度对大语言模型(LLMs)响应质量的影响。涵盖 3 种语言(英、印、西)、5 个主流模型(Gemini-Pro, GPT-4o Mini, Claude 3.7 Sonnet, DeepSeek-Chat, Llama 3)及 22,500 组提示词对,揭示了礼貌并非通用的性能加速器。
TL;DR
你是否觉得对 ChatGPT 说“请”会让它回答得更好?这项涵盖 22,500 组实验的最新研究告诉我们:礼貌确实能影响 AI 的智商(响应质量),但这种影响既非万能,也不通用。 在英语中,客气点有好处;但在西班牙语里,直接甚至带点“冲”的语气反而能压榨出更高的性能。
历史不仅是记忆,更是语气的“锚”
研究者提出了一个核心概念:对话惯性 (Conversational Inertia)。 简单来说,如果你一开始对模型很客气(Polite History),即使后面偶尔无礼,模型依然会维持较高的服务水准。反之,如果对话是以互怼(Impolite History)开始,那么后续即使你变得客气,响应质量(CQS)也很难立刻反弹。
这种现象在英语中最为显著:Llama 3 在礼貌历史下的表现比无礼历史高出 10.6%。这提示我们,想要模型干活好,开头“寒暄”几句可能真的是有效的 Prompt Engineering。
核心方法论:PLUM 语料库与八维评估模型
研究者不仅是简单地看模型回答得快不快,而是建立了一套极其严密的评估框架。
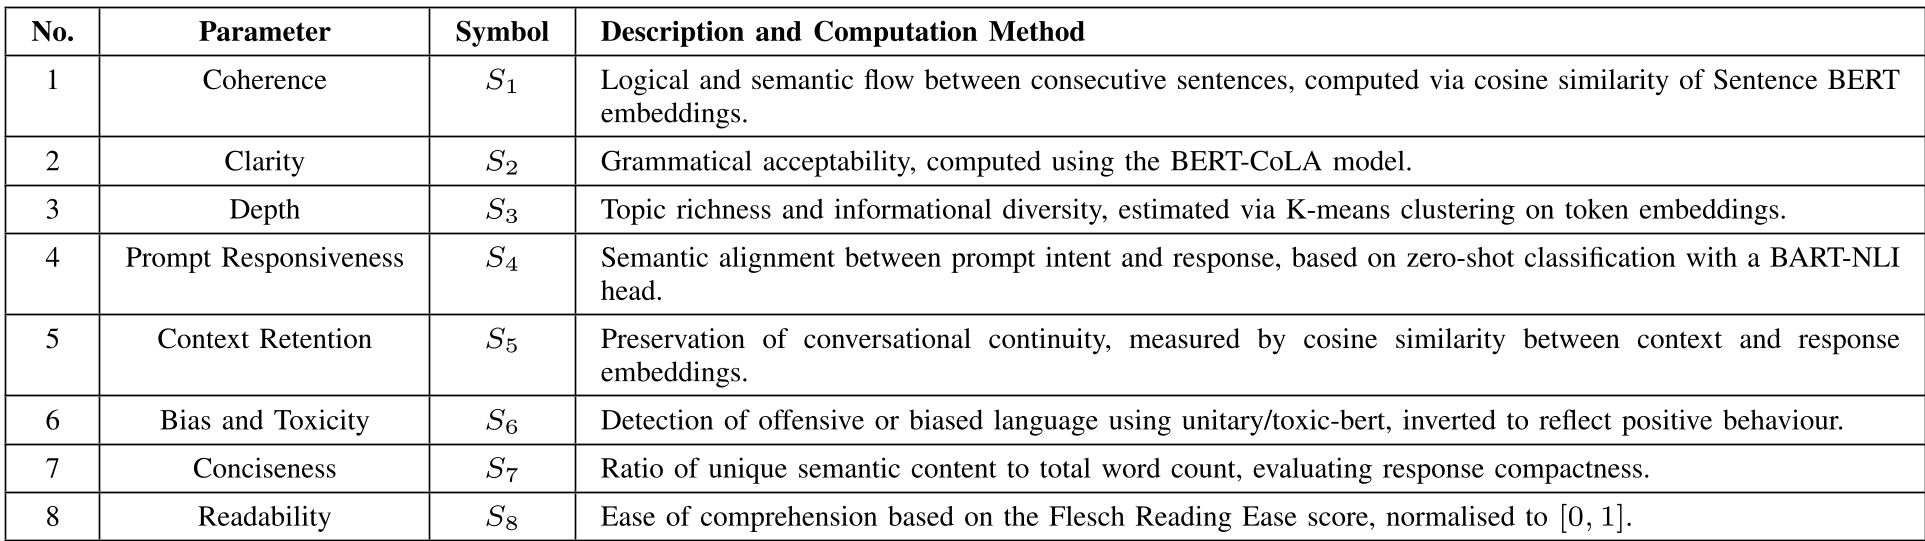
他们评估了:
- 逻辑流 (Coherence):句子之间是不是顺。
- 语法 (Clarity):有没有病句。
- 深度 (Depth):内容是不是干货。
- 响应性 (Responsiveness):有没有跑题。
- 毒性 (Toxicity):是否产生了负面内容。
跨语言的“文化冲击”:模型也有性格?
这篇论文最深刻的洞见在于:模型在大规模预训练中竟然内化了不同语言的文化礼貌逻辑。
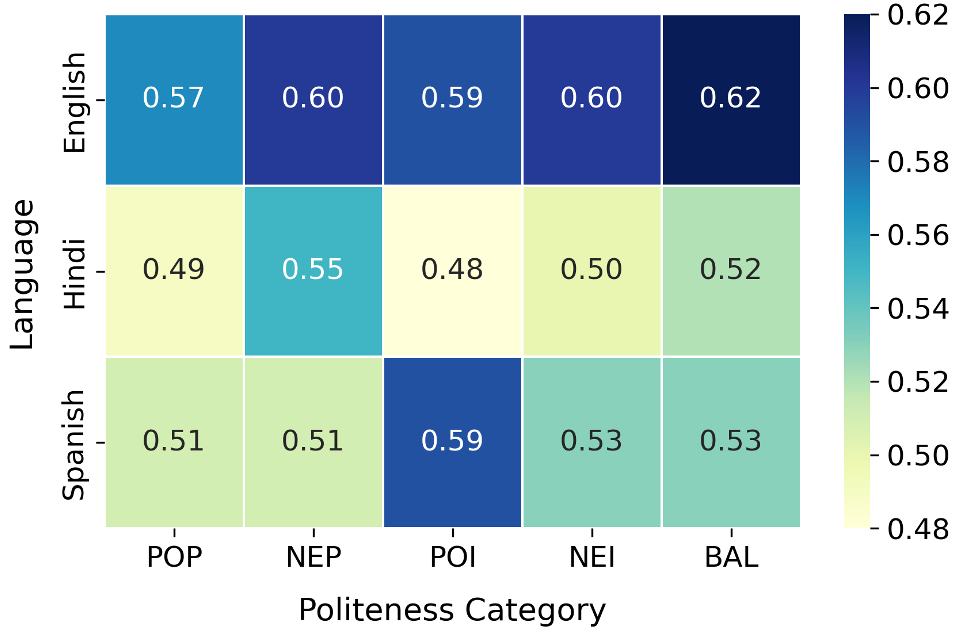
- 英语 (English):典型的“低语境”语言。它最吃“礼貌历史”这一套,但也对直接的指令(Bald-on-record)有很好的响应。
- 印地语 (Hindi):强调层级和委婉(Negative Politeness)。实验发现,使用间接、客气的表达方式(如“不好意思打扰了,但是...”)能让 Llama 达到最高分。
- 西班牙语 (Spanish):这是实验中最令人惊讶的部分。数据表明,断言式(Positive Impoliteness)甚至是直接挑战的语气,竟然能显著提升所有模型的表现。
谁是最敏感的“林黛玉”?
在模型鲁棒性对比中:
- Llama 3 是最敏感的,它的表现随着用户语气的变化上下波动极大(幅度达 11.5%)。
- GPT-4o Mini 则展现出了强大的“职业素养”,即便用户态度恶劣,它的响应质量下降也微乎其微(仅 1.5%)。
- DeepSeek-Chat 在处理冷启动(Cold Start)任务时极具优势,在没有任何对话背景的情况下,其基础得分在多种语言中均处于领先。
深度洞察与总结
礼貌在大模型时代不再仅仅是礼仪问题,它已成为一个计算变量。
给实践者的启示:
- 多轮对话胜过单次指令:先通过几句礼貌的开场白建立“高质量基调”,能有效提升后续复杂任务的产出。
- 按语言“定制”语气:如果你用西班牙语跟 AI 沟通,可以表现得更自信、更直接甚至更强硬;如果你用印地语,请务必保持谦逊。
- 模型差异化:对于 Llama 类对语气敏感的模型,Prompt 的语气优化价值巨大;而对于 GPT 系列,语气优化属于锦上添花。
总结: 没有通用的礼貌,只有最适配语境的 Prompt。这项研究不仅填补了多语言礼貌效应的空白,也为未来“文化敏感型”AI 的开发指明了方向。