
NVBench 分解:赋予 AI 呼吸与情感的非语言发声评测基准
NVBench: A Benchmark for Speech Synthesis with Non-Verbal Vocalizations
本文推出了 NVBench,一个专门用于评估语音合成中非语言发声(NVVs,如笑声、叹气、哭腔)的二语(中英)基准测试。该框架涵盖了包含 45 种 NVV 类型的统一分类法,并针对 15 种主流 TTS 系统在控制力、位置准确度和感知显著性等多个维度进行了系统性评测。
TL;DR
尽管当前的 TTS 系统已经能说出极其流利的文字,但它们往往缺乏人类对话中的“灵魂”——那些不经意的叹息、带有情绪的笑声或哽咽。本文介绍的 NVBench 是首个针对非语言发声(NVVs)设计的深度评测基准,通过 45 类精细化分类和中英双语数据集,揭示了目前即使是最顶尖的老牌系统(如 ElevenLabs)在微小口腔动作和长程情感协同上的短板。
1. 为什么“会说话”的 AI 听起来还是不像人?
在语音交互领域,我们正在经历从“可理解”到“表现力”的跨越。现有的 SOTA 系统(如 GPT-4o, ChatTTS)在音质上已经难辨真假,但真正的挑战在于 副语言(Paralinguistics) 信息。
人类在交流时,大约有很大一部分情感是通过非词汇手段传达的。目前的痛点在于:
- 标准缺失:什么是“好”的笑声?目前行业缺乏统一的分类与衡量准则。
- 评价偏见:传统的 ASR(语音识别)会将笑声、呼吸判定为噪音或识别错误,导致系统在追求高表现力时反而被算法“扣分”。
- 建模难度:像“啧舌(Tsk)”这种低能量信号极易被背景音淹没,而“哭腔(Sobbing)”则需要长达数秒的韵律连贯性。
2. NVBench 的核心方法论:多轴解耦评测
NVBench 并不只是简单给语音打分,它提出了一个多轴评估协议(Multi-axis Evaluation Protocol),试图解决评价体系的混乱。
2.1 45 类精细分类法
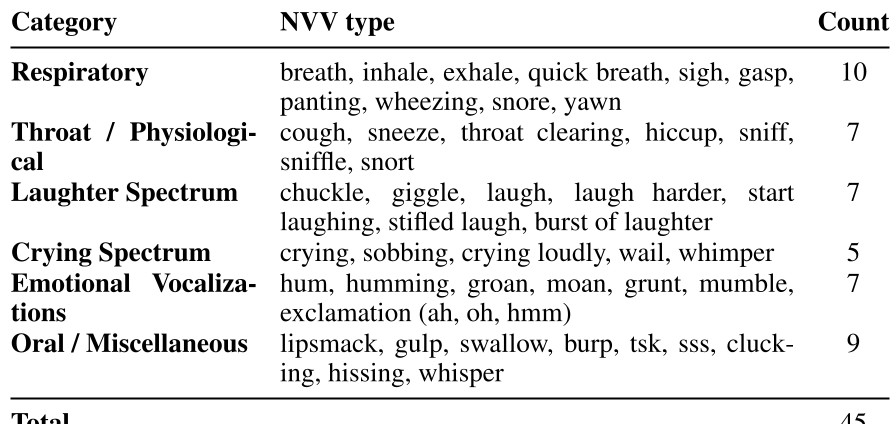
作者将 NVV 划分为六大核心类别:
- 呼吸类 (Respiratory):吸气、叹息、气喘等。
- 生理类 (Throat/Physiological):咳嗽、打喷嚏、清嗓子。
- 笑声谱 (Laughter Spectrum):从轻笑到狂笑。
- 哭泣谱 (Crying Spectrum):抽泣、哀嚎。
- 情感发声 (Emotional Vocalizations):沉吟(Hmm)、呻吟。
- 口腔/杂项 (Oral/Misc):咂嘴(Lipsmack)、低语。
2.2 控制接口的对决:Prompt vs. Tag
实验中对比了两种主流控制方式:
- Prompt-based:如“用悲伤的语气,中间带一点抽泣”,这考验 LLM 的指令遵循能力。
- Tag-based:如
今天天气不错 [laugh],这考验模型对离散控制符的精准渲染。
3. 实验发现:性能的“皇帝新衣”
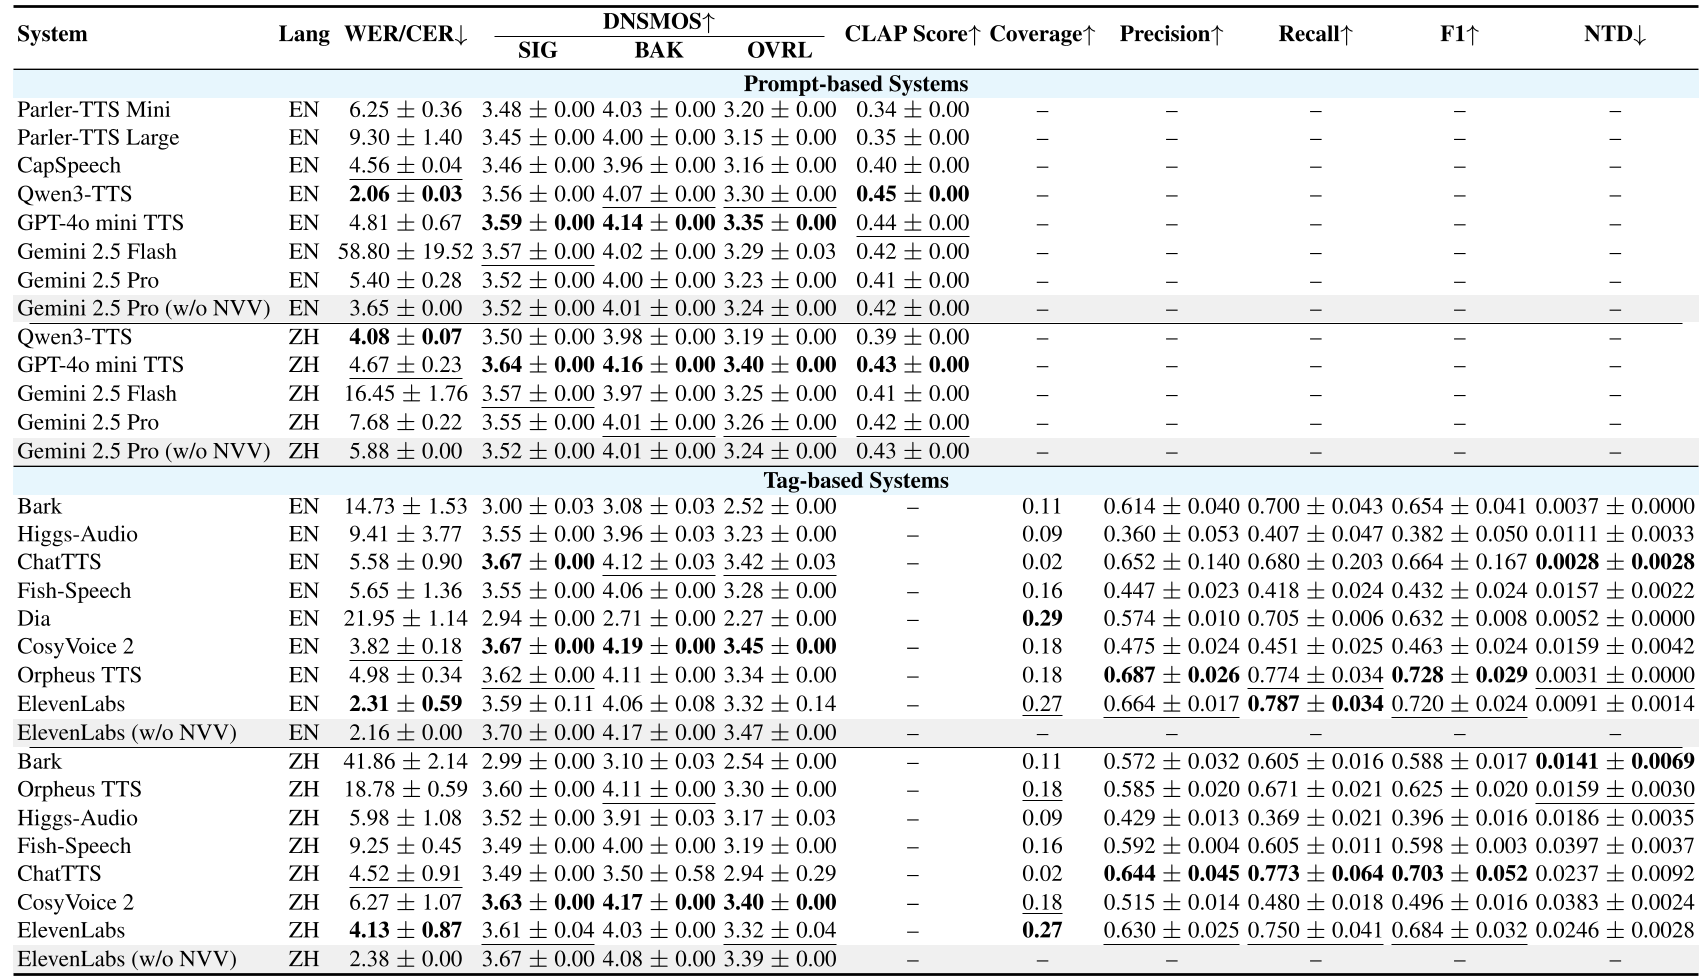
NVBench 评测了包括 GPT-4o mini, ElevenLabs, ChatTTS, CosyVoice 2 等 15 个模型,得出了一些非常有意思的结论:
3.1 质量与表现力的脱节
有些系统(如 Qwen3-TTS)在传统的语音清晰度和 DNSMOS(音质评分)上表现极佳,但在 NVV 的控制力上却显著落后。这意味着,合成出好听的声音并不代表能合成出有情感的声音。
3.2 恐怖谷效应与 ASR 的局限
在消融实验中发现,当开启 NVV 控制时,Google Gemini 等系统的 WER(词错误率)会飙升。这不是因为模型说不清楚了,而是因为 ASR 将长笑(ha ha ha...)识别为冗余文本。这提示我们,未来的表现力语音评价必须使用 NVV-aware 的 ASR 系统。
3.3 难点所在:长程连贯性
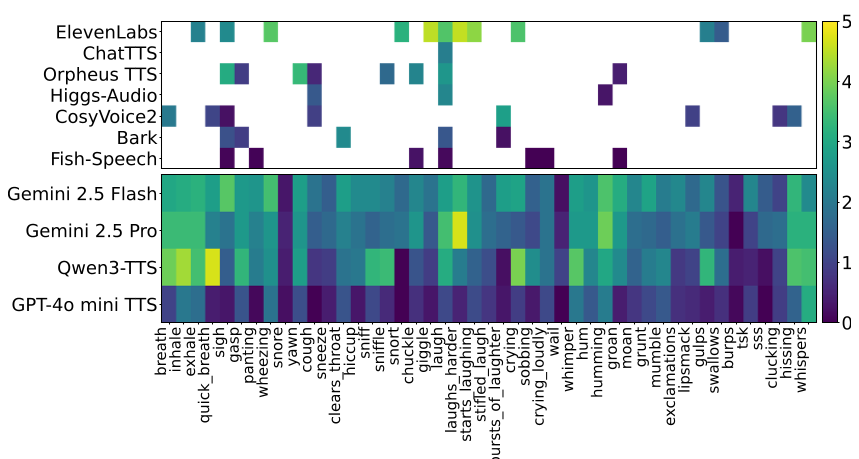
从下方的热图中可以看出,笑声和呼吸是目前各家系统做得最好的部分(颜色最深);而口腔细微动作(Oral)和长时程的哭泣情感(Crying)在大多数系统中都是空白或得分极低(白色区域多)。
4. 深度洞察:未来的路向何方?
- 数据饥渴:低信噪比的 NVV(如咂嘴)在数据清洗中常被作为噪音切除。未来的数据集构建需要保留这些具有交互意义的“噪音”。
- 时间轴精度:目前很多系统虽然能发出这种声音,但位置放不对(Tag Distance 大)。这说明 Transformer 架构在音频 tokens 与文本 tags 的交叉对齐上仍有提升空间。
- LLM 作为裁判的兴起:NVBench 成功验证了使用 Gemini 2.5 Pro 作为多专家评测的可行性,这为合成语音的自动化快速迭代提供了新路径。
5. 总结
NVBench 填补了语音合成领域的一个重要空白。它告诉我们,赋予机器“人性”不只是提升采样率,更是要细致入微地模拟那些非词汇的、本能的生理反馈。对于开发者来说,关注 Temporal Coherence 和 Low-SNR Accuracy 将是下一代 TTS 竞争的入场券。