
[LLVM/GCC] 32位无符号除法的64位架构重生:打破30年GM算法枷锁
Optimization of 32-bit Unsigned Division by Constants on 64-bit Targets
本文提出了一种针对 64 位 CPU 优化的 32 位无符号常量除法算法。该方法改进了经典 GM 算法(Granlund-Montgomery),通过利用 64 位寄存器的宽位特性,将原本复杂的 33 位魔数除法序列简化为单条乘法指令,目前已合并至 LLVM 主线。
TL;DR
在 64 位 CPU 遍地走的今天,我们的编译器编译器竟然还在用 32 位时代的思考方式做除法优化。本文介绍了一种已被 LLVM:main 接收的新算法,它通过利用 64 位寄存器处理 32 位除法中的“33 位魔数”难题,将执行效率提升了近 2 倍。
背景定位:这是对编译器后端核心逻辑(SelectionDAG/Instruction Selection)的一次重要理论修补与现代架构适配。
痛点深挖:为何 x/7 比你想象的慢?
在底层开发中,除以常量的操作通常会被编译器转换为“乘以一个巨大的魔数并右移”。这被称为 GM 算法 (Granlund-Montgomery Method)。
对于 32 位无符号除数 ,如果对应的魔数 能填进 32 位,性能极高。但在约 23% 的情况下(例如除以 7, 19, 107),魔数需要 33 位 才能满足精度要求。为了在 32 位寄存器里处理这多出来的一位,传统的 GM 算法(Listing 2)不得不设计了一套复杂的“减法 -> 逻辑右移 -> 加法 -> 再次右移”的补偿链。
在现代 64 位机器上,这套原本为了“防止溢出”而设计的技巧反而变成了阻碍流水线发射的冗余指令。
方法论详解:物理直觉驱动的简化
作者的核心 Insight 非常直截了当:既然我们有 64 位寄存器,为什么还要假装在 32 位里跳舞?
架构解析
原有的 GM 序列如下:
- 执行 32 位乘法
- 右移 32 位获取高位
- 执行
(x - y) >> 1 + y等一系列补偿操作(防止运算过程超过 32 位)
本文提出的新方案: 利用公式 。 通过将 33 位魔数 预先左移到 64 位边界,我们将整个问题转化为一个 64x64 128 bit 的乘法问题。由于 是通过零扩展到 64 位的,我们只需要拿到乘法结果的最高 64 位即可。
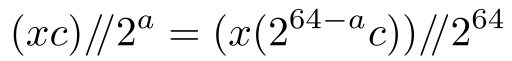
在指令集层面,这变得异常简单:
- x86-64: 使用
mulx指令。 - AArch64 (Apple M4): 直接使用
umulh(Unsigned Multiply High)。
实验与结果:指令减少带来的爆发式增长
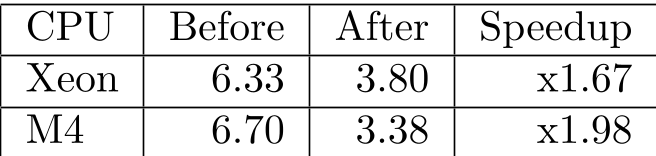
作者通过 LLVM 补丁在 Sapphire Rapids 和 Apple M4 上进行了实测。
汇编级的瘦身
观察下方的对比,左侧是传统的 GM 序列,右侧是优化后的代码。可以看到,原本长达 7-8 行的复杂指令链被缩减到了仅需 1 条 mulxq 或 umulh 相关逻辑。
(提示:参考论文 Listing 7 与 Listing 8 的对比,指令数量从 6 条下降到 1 条核心乘法)
性能战绩
| 平台 | 原始耗时 (sec) | 优化后耗时 (sec) | 加速比 |
|---|---|---|---|
| Intel Xeon w9-3495X | 6.33 | 3.80 | 1.67x |
| Apple M4 | 6.70 | 3.38 | 1.98x |
深度洞察与总结
Takeaway
这项工作的价值不在于使用了多么高深的数学,而在于其工程落地性。作者精准识别了 32 位遗留算法与现代 64 位硬件能力之间的不对称性。
局限性与挑战
- 平台依赖:该优化完全依赖于目标机是 64 位架构。如果目标是内嵌式 32 位 MCU,代码仍需回退到传统 GM 模式。
- 寄存器压力:在极少数极其复杂的循环中,mov 一个 64 位长常数可能会略微增加寄存器压力,但相比除法的收益,这几乎可以忽略不计。
未来展望
目前该补丁已进入 LLVM 19/20 的开发路线,GCC 补丁也正在评审中。这预示着在不久的将来,所有在 64 位服务器上运行的 32 位整数密集型计算(如哈希表索引、位图处理)都将获得“免费”的性能跃迁。