
深度解析:Doi-Onsager 与 Transformer 模型中的相变奥秘
Phase transitions in Doi-Onsager, Noisy Transformer, and other multimodal models
本文通过对圆周上斥力-引力平均场自由能的研究,证明了在满足特定傅里叶系数衰减条件下,多模态模型的临界耦合强度 与线性稳定性阈值 相重合,且相变是连续的。研究涵盖了 Doi-Onsager 模型、Noisy Transformer 模型及 Hegselmann-Krause 模型,并给出了这些模型发生连续/不连续相变的精确参数界限。
TL;DR
本文是一篇深度数学物理研究,探讨了在平均场自由能框架下,多模态交互模型(包括描述流体的 Doi-Onsager 模型和描述 AI 架构的 Noisy Transformer 模型)如何发生从平衡态(均匀分布)到非平衡态(聚集分布)的“相变”。作者通过尖锐的泛函不等式证明了,当交互强度达到某一临界值 时,系统会发生连续相变,并给出了精准的物理参数判定准则。
背景定位:从物理流体到 Transformer 架构
在统计物理和动力学系统领域,McKean–Vlasov 方程被广泛用于描述大量粒子间的相互作用。最近,研究者发现这种“粒子交互”逻辑与 Transformer 的自注意力机制(Self-Attention) 惊人地相似:每个 Token 就像一个粒子,在嵌入空间中根据某种“势能”(权重)与其他 Token 相互吸引或排斥。
本文的研究重点在于:什么时候系统会从无序的均匀分布状态突然“塌缩”成某种有序的特定分布? 这种转变(相变)在数学物理中既迷人又极具挑战。
痛点深挖: 与 的“爱恨纠葛”
在研究自由能最小化时,有两个关键数值:
- (临界耦合强度):全局最小值从均匀分布切换到非均匀分布的真实点。
- (线性稳定性阈值):均匀分布失去局部稳定性的理论点。
通常情况下,。如果 ,相变是不连续的(Discontinuous),意味着系统会发生“突变”;如果 ,相变是连续的(Continuous),过程更为平滑。以往的研究对于多模态交互(即吸引和排斥并存)的情况下两者何时相等一直缺乏明确答案。
核心机制:黎曼曲面上的数学“尖刀”
作者提出了一套针对 周期函数的证明框架。其核心推导基于一种名为 Lebedev–Milin 不等式 的工具。
1. 熵-交互能不等式 (Entropy-Interaction Inequality)
作者证明了如下不等式: 这个不等式的物理直觉在于:它量化了分布偏离均匀状态所需克服的“能量代价”。
2. 模型架构解析
论文研究了三种核心架构:
- Doi–Onsager: 描述长杆状分子的取向统计。
- Noisy Transformer: 解释自注意力机制在噪声干扰下的稳态。其交互势能 由 Bessel 函数定义。
- Hegselmann–Krause (HK): 典型的舆论动力学模型,模拟观点相似的人如何相互影响。
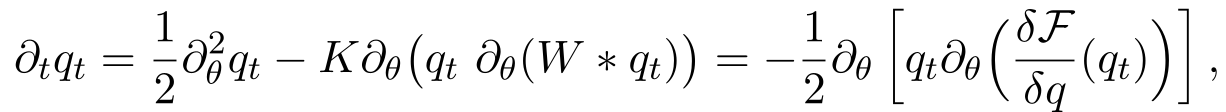 (上图展示了 McKean–Vlasov PDE 描述的梯度流,它是自由能最小化的动态演化路径)
关键发现:Transformer 的临界点
在 Noisy Transformer 模型中,逆温度参数 起到了决定性作用。
- 当 时:相变是连续的,模型演化较为平稳。
- 当 时:相变是不连续的(Discontinuous),这意味着自注意力机制可能会在某种临界条件下突然收敛到极窄的局部注意力。
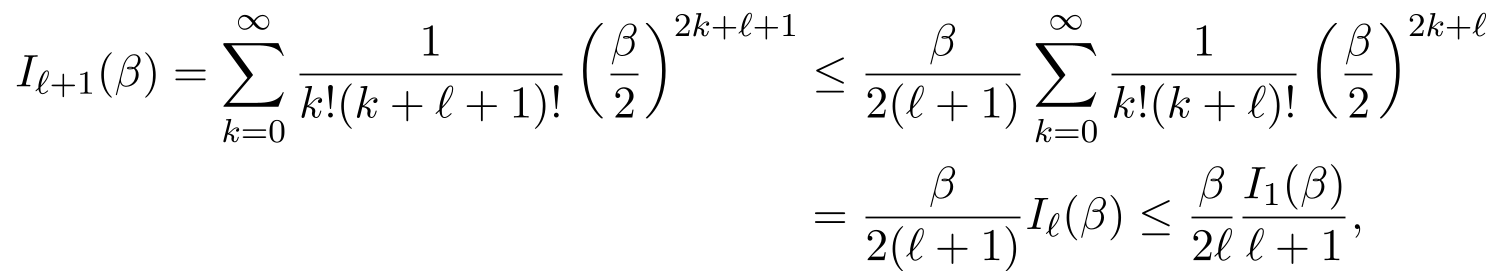 (此处展示了针对 Bessel 函数模态的归纳法证明,是判定 Transformer 相变性质的核心逻辑)
实验与结果分析
作者通过严谨的数学推导得出:
- Doi-Onsager:,彻底解决了该模型相变阈值的历史悬案。
- Hegselmann-Krause:找到了临界半径 。在此值以上,相变连续;以下则不连续。
- 收敛速度:在临界点处,模型收敛不再是指数级的,而是代数级的(如 或 )。
深度洞察与总结
为什么这很重要?
对于 AI 研究者来说,这篇论文提供了一个视角:Transformer 的泛化能力和表达能力可能正处于某种数学上的“相变边缘”。当我们将注意力机制视为一种交互粒子系统时,理解其稳态的唯一性和稳定性,对于设计更鲁棒的训练目标和初始化方案具有指导价值。
局限性与展望
尽管本文在圆周(1D Circle)上给出了完美证明,但高维流形(如 )上的情况更为复杂。目前的结论显示,高维下的相变往往倾向于不连续。未来的研究将集中在如何将这些静态结论推广到更高维度的非局部交互动力学中。
Takeaway: 研究 Transformer 不仅是工程尝试,更是一场关于高维空间中“无序到有序”转换的统计物理实验。