
PLaMo 2.1-VL:轻量级多模态模型如何重塑端侧工业视觉?
PLaMo 2.1-VL Technical Report
本文介绍了 PLaMo 2.1-VL,一套专为端侧/边缘设备设计的轻量级多模态视觉语言模型(VLM),包含 8B 和 2B 两个版本。该模型针对日语环境进行了深度优化,在 VQA 和 Visual Grounding 任务上展现出卓越性能,并在工厂任务分析及基础设施异常检测等实际场景中达到了 SOTA 水平。
TL;DR
Preferred Networks (PFN) 发布了 PLaMo 2.1-VL 系列模型(8B 与 2B),旨在解决端侧设备(如无人机、工业相机)在本地环境下进行高精度视觉理解的难题。通过深度优化的日语合成数据流水线和独创的两阶段推理架构,该模型在工厂分析、异常检测等任务中刷新了轻量级 VLM 的性能高度。
背景定位
在端侧 AI 领域,不仅需要模型“跑得动”,更需要它“看得准”。PLaMo 2.1-VL 定位于实战型轻量化模型。相比于追求通识能力的云端大模型,它专注于 Visual Question Answering (VQA) 和 Visual Grounding (VG) 这两项工业核心能力,是首个在日语工业场景下进行深度定制的技术报告。
痛点深挖:为何通用 VLM 在工厂里不好使?
- 日语支持匮乏:开源界的高性能 VLM 大多以英语为主,日语理解往往存在偏差。
- 空间定位能力弱:很多模型能识别图中有一个“扳手”,但无法精准画出其 Bounding Box,这在自动巡检中是致命的。
- 小目标与异常检测难题:工业环境中的异常(如漏水、异物)通常只占像素的极小部分,标准 VLM 容易漏检。
核心架构:精悍且高效
PLaMo 2.1-VL 选择了 SigLIP2 作为图像编码器。研究团队通过消融实验发现,SigLIP2 相比 CLIP 具有更好的空间定位(Local correspondence)能力。
PLaMo 2.1-VL 架构示意:PLaMo 2.1 基座 + MLP Adapter + SigLIP2 编码器 + 动态分块技术。
为了在显存受限的边缘设备上运行,团队舍弃了复杂的 Q-Former,转而使用简单的 MLP Adapter,并将省下的显存用于扩大 Batch Size,从而加速了超参数的迭代收敛。
方法论亮点:高质量数据是怎么产生的?
作者提出了“双估计一致性门控 (Dual-estimation Agreement Gate)”。在生成计数(Counting)任务的数据时,只有当 Qwen3-VL 和 SAM3 这两个独立模型输出的计数一致时,该数据才会被采纳。这种类似于“模型对账”的机制极大地降低了合成数据的噪点。
实验与结果:两阶段推理的威力
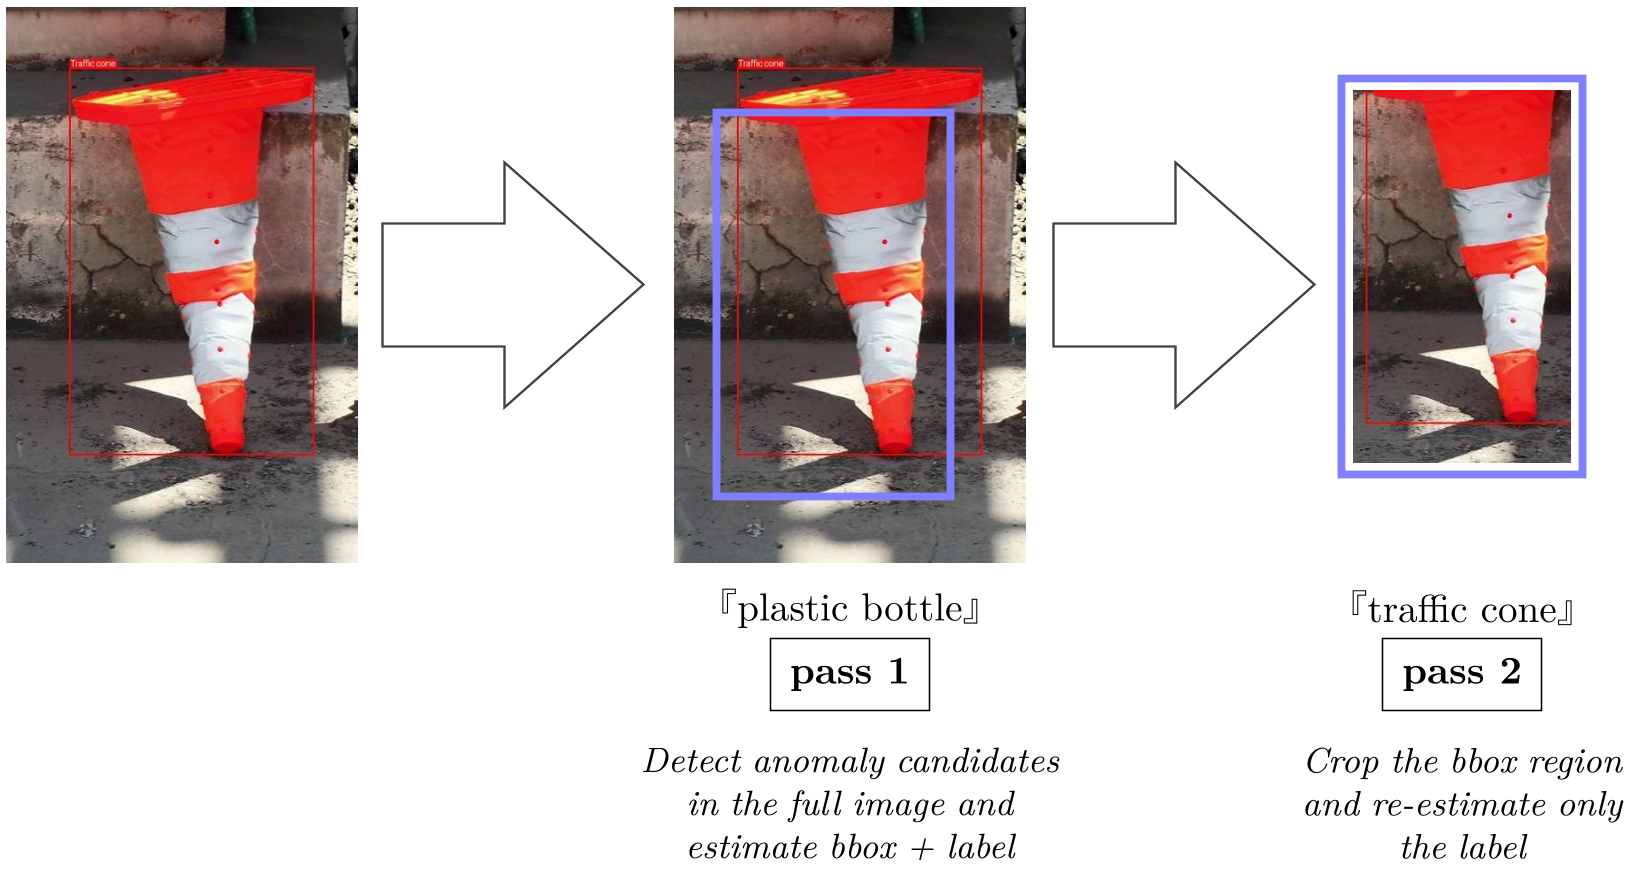
在基础设施异常检测(如电厂巡检)中,模型面临的一个核心挑战是:检测到了异常点,但不知道那具体是什么。
作者引入了 Two-pass Inference 流程:
- Pass 1: 扫描全图,识别候选异常区域(Bounding Box)。
- Pass 2: 对候选区域进行高分辨率裁剪,通过局部特征重新判定标签。
关键战绩:
- 工厂任务解析:在完全未见的工厂图像中,PLaMo 2.1-8B-VL 实现了 53.9% 的 Accuracy,显著超过了参数量更大的 Qwen3-VL-235B (45.8%)。
- 异常检测:通过领域微调,模型在“位置+类别”综合评分中从 39.7 提升至 64.9。
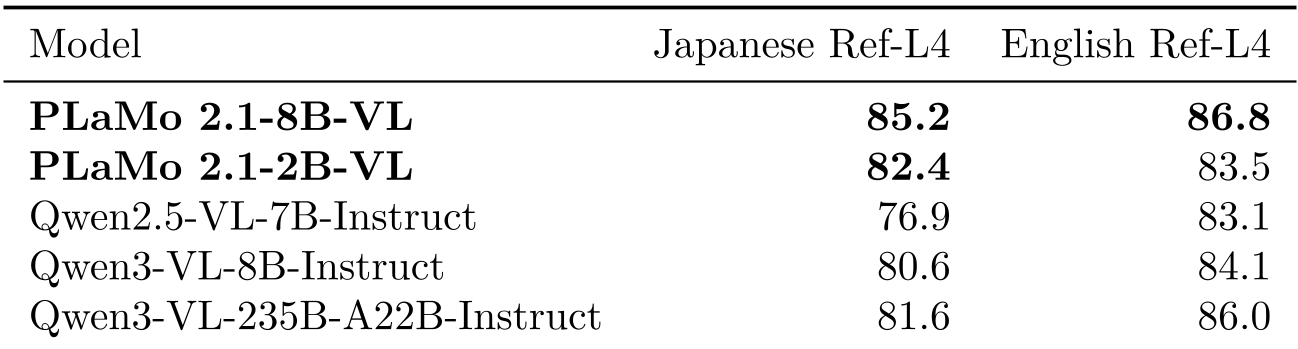 表:PLaMo 2.1-VL 在日语 Ref-L4 基准上表现亮眼,优于 Qwen 系列。
深度洞察与总结
Takeaway:
- 小而美胜过大而全:针对垂直领域(如日语、工业视觉)进行数据合成和微调,轻量级模型完全可以逆袭大模型。
- 两阶段推理的必要性:对于需要精准分类的小目标任务,全局感知后再局部增强是目前低算力下最有效的方案。
局限性: 该模型目前的 OCR 能力较弱,且无法处理视频流数据(仅限单张或成对图像),这在动态监控场景下仍有提升空间。
未来展望: PLaMo 2.1-VL 为我们展示了“场景驱动”的 AI 设计范式。未来随着这类模型的开源,更多的无人机和工业机器人将具备“日本语母语级别”的视觉理解能力。