
RAD-2:生成器-判别器框架下的自动驾驶 RL 大规模扩展
RAD-2: Scaling Reinforcement Learning in a Generator-Discriminator Framework
本文提出了 RAD-2,这是一个统一的生成器-判别器(Generator-Discriminator)框架,通过在大规模闭环仿真中扩展强化学习(RL)来提升自动驾驶运动规划的性能。该方法结合了 Diffusion 轨迹生成器与基于 RL 优化的 Transformer 判别器,在 BEV-Warp 高吞吐量仿真环境下实现了 SOTA 的安全性与效率。
TL;DR
RAD-2 是一套基于强化学习(RL)的自动驾驶运动规划系统。它巧妙地将 Diffusion 生成器的多模态表达能力与 Transformer 判别器的长程评估能力相结合,并通过创新的 BEV-Warp 高吞吐量仿真器,将 RL 训练的数据规模提升至 10k+ 小时量级。实验显示,其碰撞率降低了 56%,显著超越了传统的模仿学习与直接 RL 优化方法。
背景定位:为何直接对轨迹做 RL 这么难?
在自动驾驶领域,模仿学习(Imitation Learning)虽然能让 AI 开得“像人”,但它天然存在**因果混淆(Causal Confusion)和闭环偏移(Compounding Errors)**的问题。
为了引入 RL 的“负反馈”,前人尝试直接对高维轨迹进行优化。然而,RL 的奖励通常是个稀疏的标量(Scalar Reward),而轨迹是高维且具有时空结构的序列。这种“维度不匹配”导致了严重的**信度分配(Credit Assignment)**难题:系统不知道是轨迹的哪一段、哪一个动作导致了最终的碰撞,从而使得优化过程极度不稳定。
核心机制:生成与判别的解耦之道
RAD-2 的精髓在于将复杂的规划任务拆解为两步:
- 生成器 (Generator G):利用 Diffusion 模型,在给定 BEV 特征后,生成 个具有代表性的多模态候选轨迹。这保证了行为的丰富性。
- 判别器 (Discriminator D):这是一个 Transformer 编码器,它不对动作直接加压,而是通过 RL 学习如何对这 个候选方案进行打分重排(Reranking)。
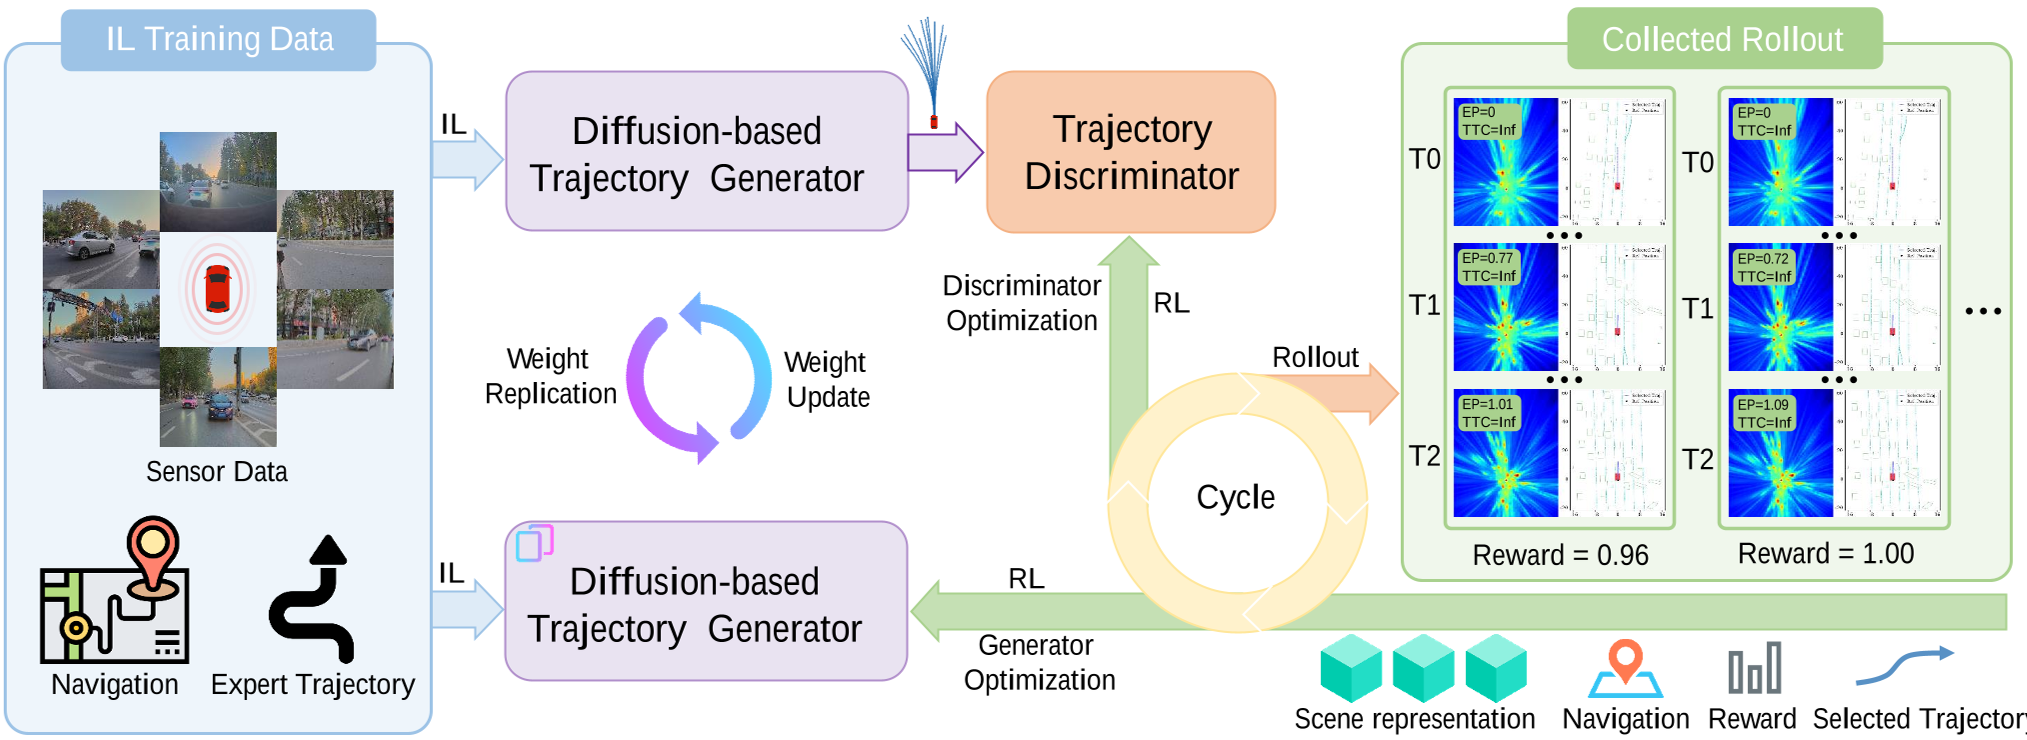
1. TC-GRPO:让策略更新更稳健
作者提出了 Temporally Consistent Group Relative Policy Optimization (TC-GRPO)。
- 时空一致性:引入轨迹复用(Latch Execution)机制。在固定步长内坚持执行选定的轨迹,而不是每帧疯狂切换模式,这建立了动作与长期后果之间的清晰因果。
- 组相对优化:在同一个状态下生成一组轨迹,通过组内奖励的相对值(Advantage)来更新判别器,有效降低了梯度方差。
2. OGO:在线生成器优化
光有好的判别器是不够的,如果生成器生成的全是“烂轨迹”,判别器也无能为力。On-policy Generator Optimization (OGO) 通过将闭环反馈(如 TTC 碰撞预警)转化为纵向的加速度调整信号,引导生成的轨迹分布向“高奖励流形”靠拢。
BEV-Warp:把仿真速度快进到极限
RL 的成功依赖于数据规模。传统的 CARLA 模拟器需要昂贵的渲染,而 RAD-2 推出了 BEV-Warp。 它的直觉非常物理:如果你知道当前帧的 BEV 空间布局和车辆位姿变化,你可以通过空间等变性(Spatial Equivariance),利用仿射变换(Bilinear Interpolation)直接在特征图上“扭”出下一帧的视角。
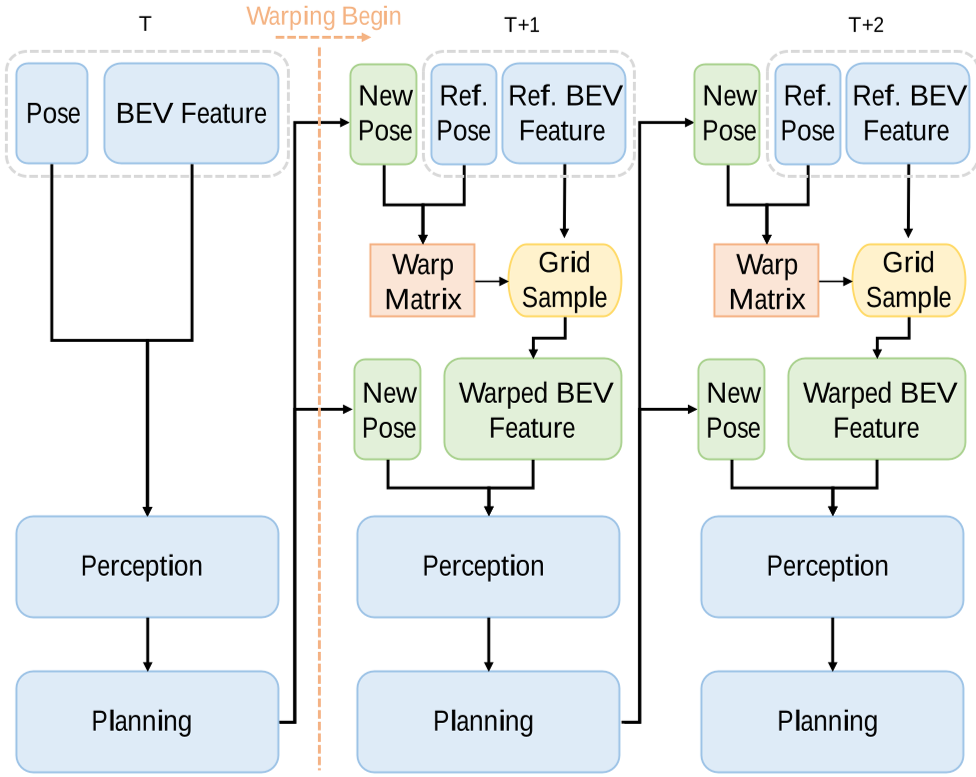
这种“特征级仿真”绕过了冗余的像素合成,极大地提升了训练吞吐量,使得 RL 能在数万个 20 秒左右的复杂剪辑片段(Clips)中进行迭代。
实验战绩与洞察
在极具挑战性的安全导向场景中,RAD-2 的表现令人印象深刻:
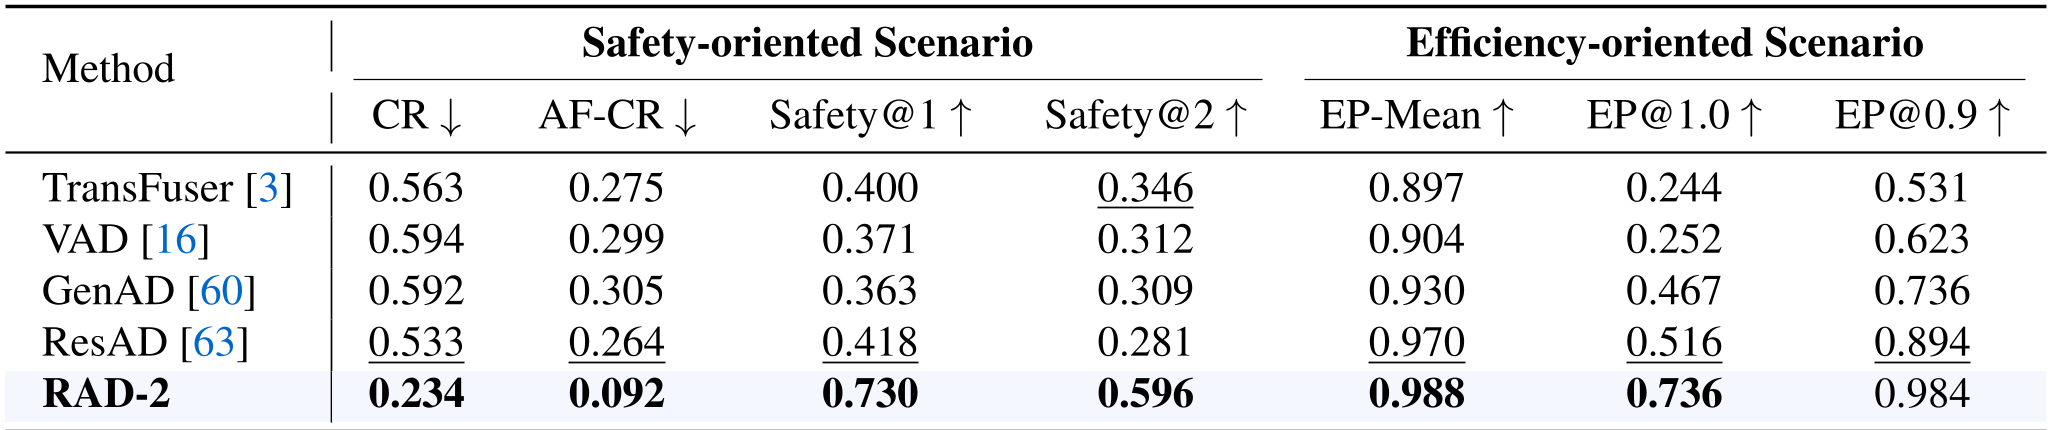
- 指标飞跃:在 3DGS 仿真测试中,RAD-2 达到了最低的碰撞率(0.250)和最高的安全冗余指标(Safety@2s 为 0.644)。
- 推理缩放(Inference-time Scaling):实验发现,随着推理时候选轨迹数量 的增加(如从 8 增加到 128),导航效率(EP@1.0)持续提升。这意味着判别器确实学会了从复杂的动作空间中搜寻最优解。
在定性分析中(见原文图 11 和 12),RAD-2 展现出了主动防御性驾驶的特质:在面对右侧强行汇入的车辆时,它会提前减速或灵活变道,而基线模型通常会因为鲁棒性不足导致追尾或过度保守等待。
总结与局限
RAD-2 成功的关键在于**“专业的事分给专业的模块做”**:Diffusion 负责多模态多样性,RL 判别器负责长程博弈与安全性权衡。
局限性:当前的 BEV-Warp 仿真高度依赖显式的 BEV 表征。如果未来自动驾驶转向完全端到端的隐空间(Unified Latent Space)架构,这种几何扭曲机制将需要进一步演化为潜空间世界模型。
RAD-2 为自动驾驶从“模仿人类”向“超越人类(更稳健、更安全)”的演进提供了一个极具参考价值的 RL 扩展范式。