
RISE:透过 Readout 之眼,重塑 LLM 的数据归因与估值
Sketching the Readout of Large Language Models for Scalable Data Attribution and Valuation
本文提出了 RISE (Readout Influence Sketching Estimator),一种针对大语言模型(LLM)的可扩展数据归因与估值方法。该方法通过 CountSketch 技术压缩输出层(LM Head)的梯度信号,成功在 32B 参数规模的模型上实现了高效的训练数据追溯与质量评估。
TL;DR
在处理数十亿参数的大语言模型(LLM)时,弄清楚“哪条训练数据影响了特定输出”一直是一项成本极高的任务。本文提出的 RISE (Readout Influence Sketching Estimator) 另辟蹊径:它不再盯着全量参数梯度,而是专注于模型输出的“最后一公里”——Readout 层(LM Head)。通过双通道语义分解与 CountSketch 压缩,RISE 不仅在 32B 模型上跑通了数据归因,存储成本还降低了两个数量级。
背景定位:数据归因的“扩展性陷阱”
在数据中心化的今天,模型性能极大程度上取决于数据质量。我们不仅需要追溯过去(回溯特定预测受哪些训练样本影响),更需要预知未来(在训练前评估候选数据的价值)。
然而,经典的梯度方法面临严重的不可扩展性:
- 物理极限:存储 7B 模型的全量梯度(FP16)处理 10,000 个样本就需要近 140TB 硬盘。
- 计算瓶颈:二阶 Hessian 矩阵在 LLM 面前几乎无法计算。
核心直觉:影响力热点(Influence Hotspots)
作者基于人类认知的启发:人类决策往往依赖于相关记忆的焦点提取,而非重放所有神经网络路径。通过实验,作者发现 LLM 存在一个显著物理特性:梯度能量在输出层高度集中。
关键观察
- ** Readout 主导性**:随着模型规模扩大,LM Head 的梯度能量占比显著增加。在 OLMo-32B 中,输出层的能量密度是中间层的 27.8 倍。
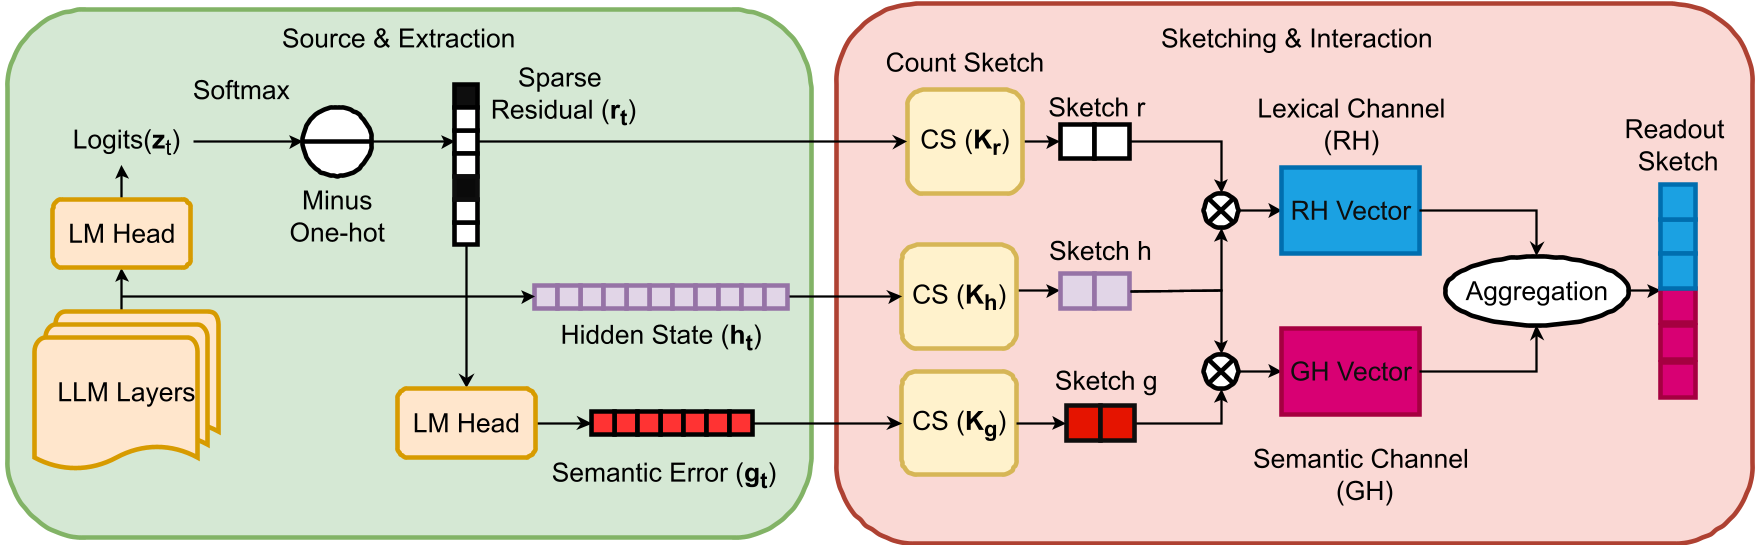
- 外积分解:输出层的梯度可以分解为 ,其中 是词表残差, 是隐藏状态。这意味着我们不需要复杂的 Backpropagation 即可在 Forward Pass 中直接获取影响力特征。
方法论:双通道与稀疏草图
1. RH + GH 双通道引擎
为了平衡词法精度和语义鲁棒性,RISE 采用了双通道设计:
- RH 通道 (Residual):直接在词表空间做比较,擅长捕获精确的 Token 匹配。
- GH 通道 (Projected-Error):将残差投影回 Embedding 空间。它能识别出虽然词不同、但语义相近的错误(例如:将“Cat”预测为“Kitten”产生的惩罚应小于预测为“Stock”)。
2. Active-Token 稀疏性
作者观察到,虽然词表很大,但真正贡献能量的词(Active Tokens)极少。通过仅保留预测概率最高的前 K 个词和 Ground-truth 词,RISE 成功将处理维度从几万甚至十几万词缩减到了百级别,且几乎没有准确性损失。
(建议此处查看原文 Figure 1 的 RISE 整体流程)
3. CountSketch 压缩
为了进一步极致压缩,RISE 对分解后的向量因子分别进行 CountSketch 投影。这种方法是 Data-independent 的,无需像 PCA 那样提前训练投影矩阵,非常适合在大规模动态数据流中使用。
实验与战绩
SOTA 对比与存储优势
在 OLMo-32B 规模下,RISE 成为了唯一“能跑通”的方法。相比于之前的最强基线 RapidIn,RISE 在存储上的降幅可达 112x。

闭环实验:告别“脑残”(Brain Rot)数据
作者在一个现实场景中验证了价值:从 90% 的低质量(Brain Rot)数据中提取 10% 的精华。 使用 RISE 挑选的数据进行训练,相比于 Random 选择,困惑度(Perplexity)从 126 骤降至 2.33。这证明了 RISE 挑选出的不仅是看起来像的数据,而是对模型真正“有营养”的数据。
深度洞察:为什么有效?
RISE 的成功在于它抓住了 LLM 的归因分化(Inductive Bias):
- 中间层在长期的预训练中逐渐趋向于表示的压缩与对齐,而最终的输出层则通过 LM Head 重新展现了判别力(U-shaped Discriminativeness)。
- 传统的全参数归因包含了太多“背景噪音”,这些能量较低的中间层梯度可能反而干扰了真正具有区分度的信号。RISE 的“只看读出端”,实际上起到了降噪的作用。
总结与限制
RISE 为超大规模模型提供了一个实用的归因原语。虽然它目前主要关注 Readout 层,忽略了深层参数中的细微交互,但其实验结果足以证明:在绝大多数工业任务(后门检测、领域分离、质量筛选)中,Readout 信号已经足够支撑强大的判别力。
未来,如何将这种 Readout 归因与分布式存储进一步结合,甚至在训练过程中实时进行在线数据价值评估,将是 LLM 基础设施层的一个核心研究方向。