
RepoZero:打破“背代码”幻觉,AI 代理能从零构建完整仓库吗?
RepoZero: Can LLMs Generate a Code Repository from Scratch?
本文推出了 RepoZero,这是首个支持全自动、基于执行验证的“从零开始”仓库级代码生成基准测试。通过将生成任务重构为“仓库复现”(跨语言实现),并配套提出 ACE 框架(Agentic Code-Test Evolution),实现了在仓库尺度下的测试时间扩展(Test-time Scaling)。
TL;DR
尽管大语言模型(LLM)在编写简单函数上已接近人类,但在从零开始构建一个完整、可运行的软件仓库时,依然步履维艰。来自北京大学和百度的研究者推出了 RepoZero,这是首个能够全自动执行验证的仓库级生成基准。通过强制性的“跨语言重构”任务(如 Python 转 JavaScript),RepoZero 撕下了模型依靠记忆刷榜的伪装。实验证明,即便是最顶尖的 Claude 模型,胜率也不过半。
背景定位:从“补丁修复”到“全站构建”
在学术坐标系中,代码生成的研究正从单文件、特定函数向仓库级逻辑空间迁移。
- Level 1: 函数填空(HumanEval)——已基本被攻克。
- Level 2: 补丁修复(SWE-bench)——关注现有仓库的增量修改。
- Level 3 (RepoZero): 从零生成(From-scratch Generation)——要求 Agent 具备模块化推理、依赖管理及长文本架构保持能力。
痛点深挖:为什么测试“构建仓库”这么难?
评估从零生成的仓库主要面临三大挑战:
- 验证成本极高:新生成的代码没有预设单元测试,人工检查不仅慢,且带有主观偏见。
- 数据泄漏(Data Leakage):目前的 LLM 在训练阶段几乎看过了所有开源 GitHub 仓库,它们在跑分时可能只是在“背诵”答案,而非真正理解逻辑。
- 运行环境复杂:仓库涉及多文件交互、依赖安装,传统的沙盒环境难以支持复杂的自动化验证。
方法论详解:RepoZero 的核心机制
1. 仓库复现即验证 (Repository Reproduction)
作者提出一个极具创意的思路:给 Agent 提供一个成熟仓库的 API 规范,让它在不看原代码(黑盒)的情况下,用另一种语言重现该仓库的功能。例如,将科学计算库 mpmath 从 Python 迁移到完全不使用 external packages 的 JavaScript。由于原仓库可以作为 Oracle(先知) 提供标准答案,这种设计实现了完全自动化的输出等效性验证。
2. ACE 框架:测试时间扩展的威力
为了解决生成过程中“跑得通但逻辑错”的问题,作者提出了 ACE (Agentic Code-Test Evolution) 框架。
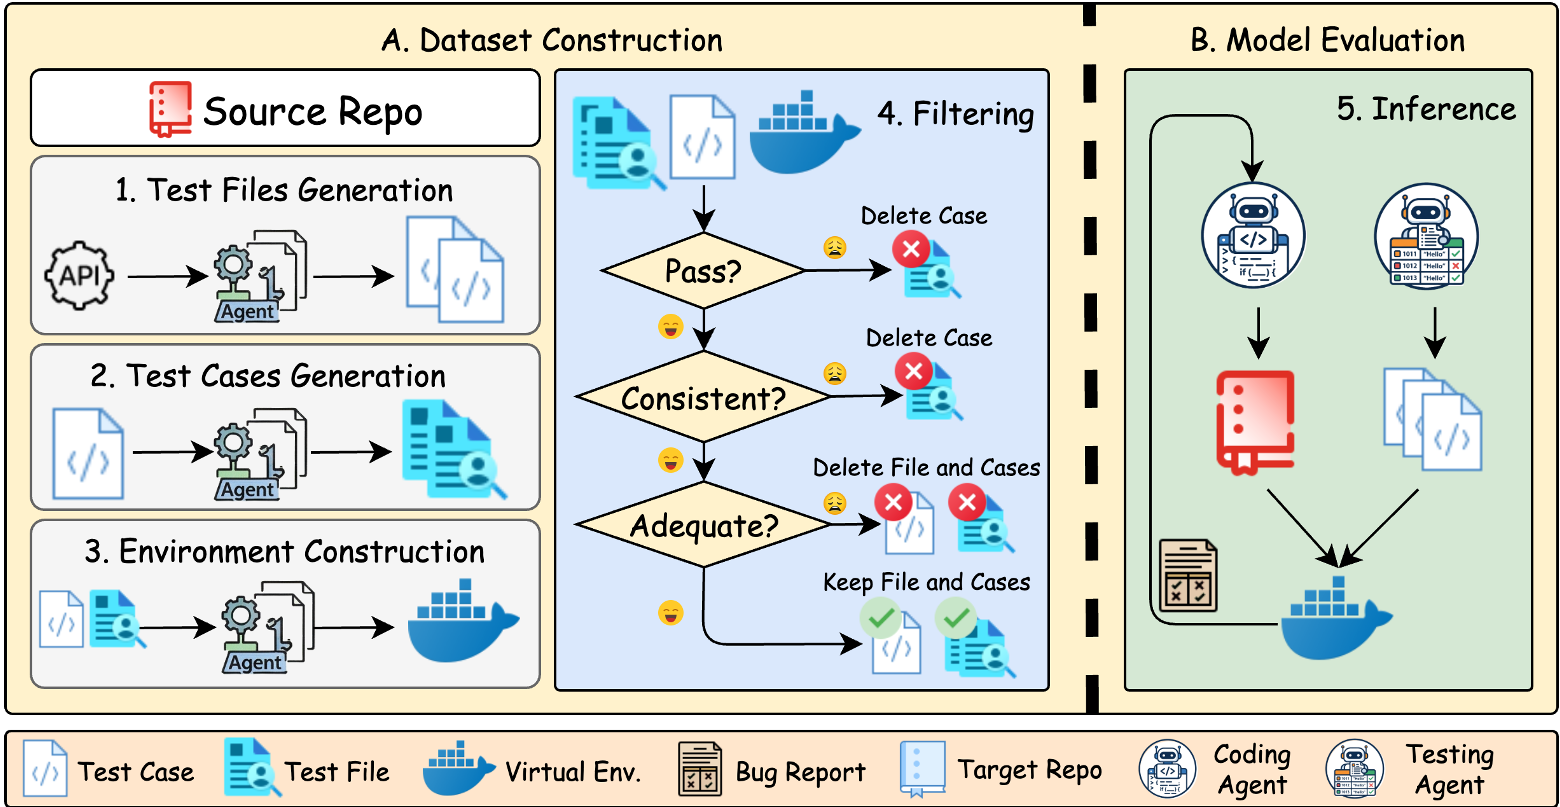
- 闭环反馈:Testing Agent 负责针对功能点编写测试用例,并在原仓库上跑出“真值”(Ground Truth)。
- 迭代修复:Coding Agent 根据测试失败后的错误回执(Error Feedback)反复修正其生成的仓库代码,直到通过所有动态生成的测试用例。这使得模型在推理阶段可以通过增加计算量(更多次的迭代)来换取更高的准确率。
实验与结果:残酷的真相
研究团队评估了包括 Claude-4.6, DeepSeek V4, Kimi-K2.6 在内的多款顶级模型。
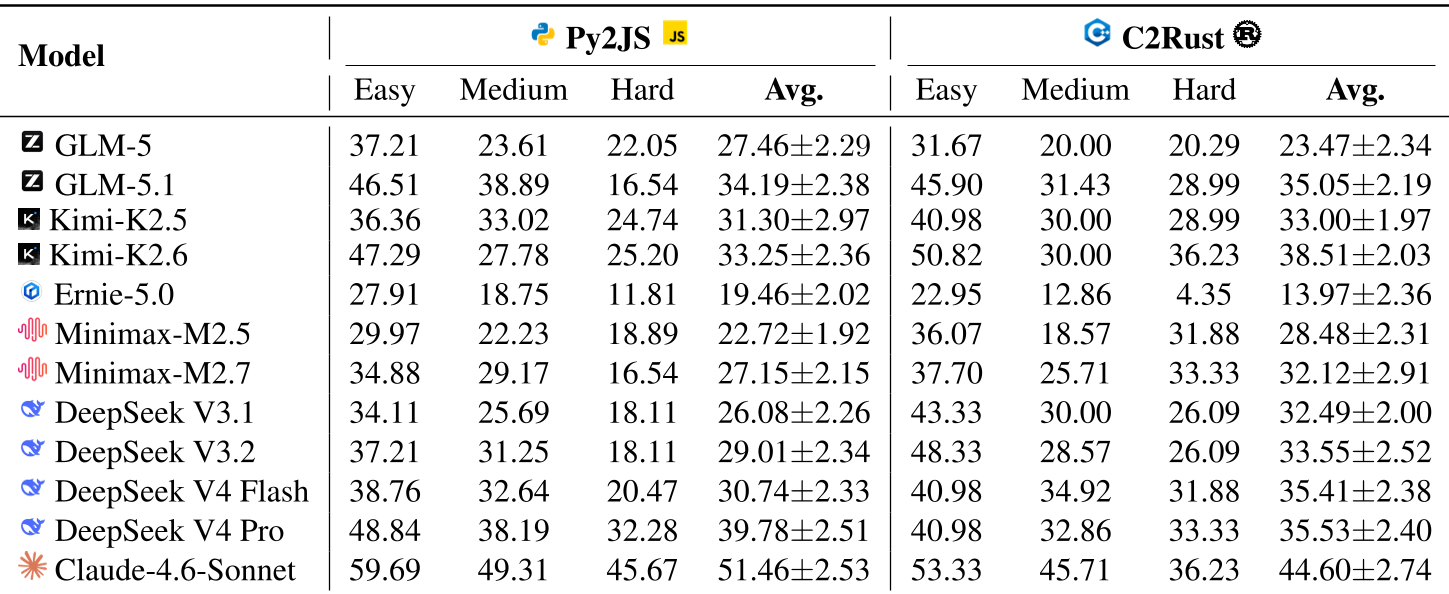
- SOTA 依然捉襟见肘:即使是表现最好的 Claude-4.6-Sonnet,在 Py2JS 任务中的平均通过率也仅为 51.46%。
- 国产模型快速追赶:Kimi K2.6 和 DeepSeek V4 在复杂任务上展现了极强的韧性,特别是在 Easy 等级的任务中,表现直逼国际顶尖水平。
- ACE 框架的显著增益:使用 ACE 框架后,DeepSeek V3.1 的 PR 从 26% 提升到了 42.8%。这说明,目前的 Agent 失败往往不是因为写不出代码,而是因为缺乏“自我观察”和“自我验证”的机制。
深度洞察:未来的编程 Agent 需要什么?
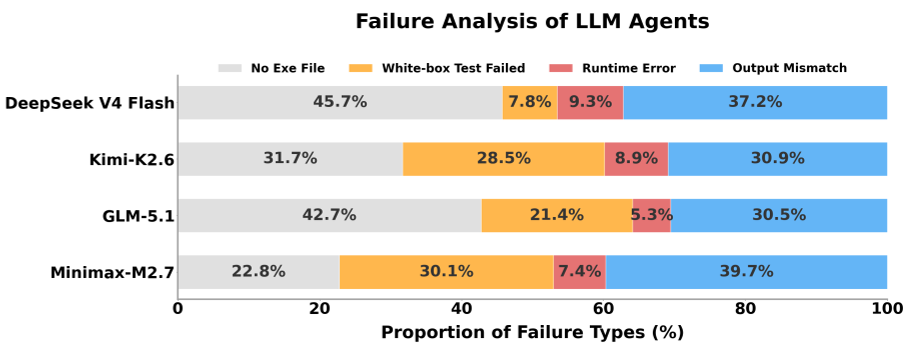
通过对失败案例的分类(见下表),作者发现了当前 LLM Agent 的通病:
- 上下文漂移 (Contextual Drift):哪怕提示词里写明了约束条件,Agent 在长达数千字的推理序列中也会慢慢“忘记”这些要求,导致即便过了白盒测试,黑盒语义也完全不对。
- 运行不等于正确:在无法运行的情况被 ACE 修复后,仍有约 40% 的代码能跑通但结果是错的(Runtime Error 少,但 Logic Error 多)。
总结
RepoZero 的出现为 AI 程序员的进化树树立了一个新的标杆。它告诉我们:真正的自主编程不仅是“写完”,更是“验证完”。未来的 SOTA Coding Agent 核心竞争力将不仅是模型本身的参数规模,更是其与可执行环境交互深度、以及生成高质量自我验证测试集的能力。
注:RepoZero 代码已开源于 GitHub: https://github.com/JesseZZZZZ/RepoZero