
医疗生成式模型的“地基”:Tokenization 对临床结局预测的深远影响
Representation Before Training: A Fixed-Budget Benchmark for Generative Medical Event Models
本文提出了针对生成式医疗事件模型(Generative Medical Event Models)的输入表示基准测试,探讨了在固定 pretraining 预算下,不同 Tokenization 策略对 30 种临床结局预测的影响。研究发现,将医疗代码与数值融合(Fused Code-Value)并结合简单的 Decile 分箱(Quantization),在 MIMIC-IV 数据集上能显著提升各项预测性能。
TL;DR
在构建生成式医疗事件模型(Generative Medical Event Models)时,我们往往关注 Transformer 模型的深度或参数量,却忽略了最基础的一步:如何将医疗记录转化为 Token? 这篇由芝加哥大学团队发表的论文证明,仅仅通过优化 Tokenization 策略(如代码与数值融合),就能在固定预算下将死亡率预测的 AUROC 从 0.89 提升至 0.91。
背景定位:被忽视的“输入表示”
当前的 EHR 基础模型(EHR Foundation Models)大多将输入表示视为一种不可更改的“基础设施”。然而,医疗数据是极其复杂的:血液中钾离子浓度 5.0 和 6.5 mEq/L 在临床上天差地别。如果分箱(Quantization)太粗,模型会丢失精度;如果太细,又会导致词表稀疏,难以在有限的数据下充分训练。
实验详解:三大维度的权衡
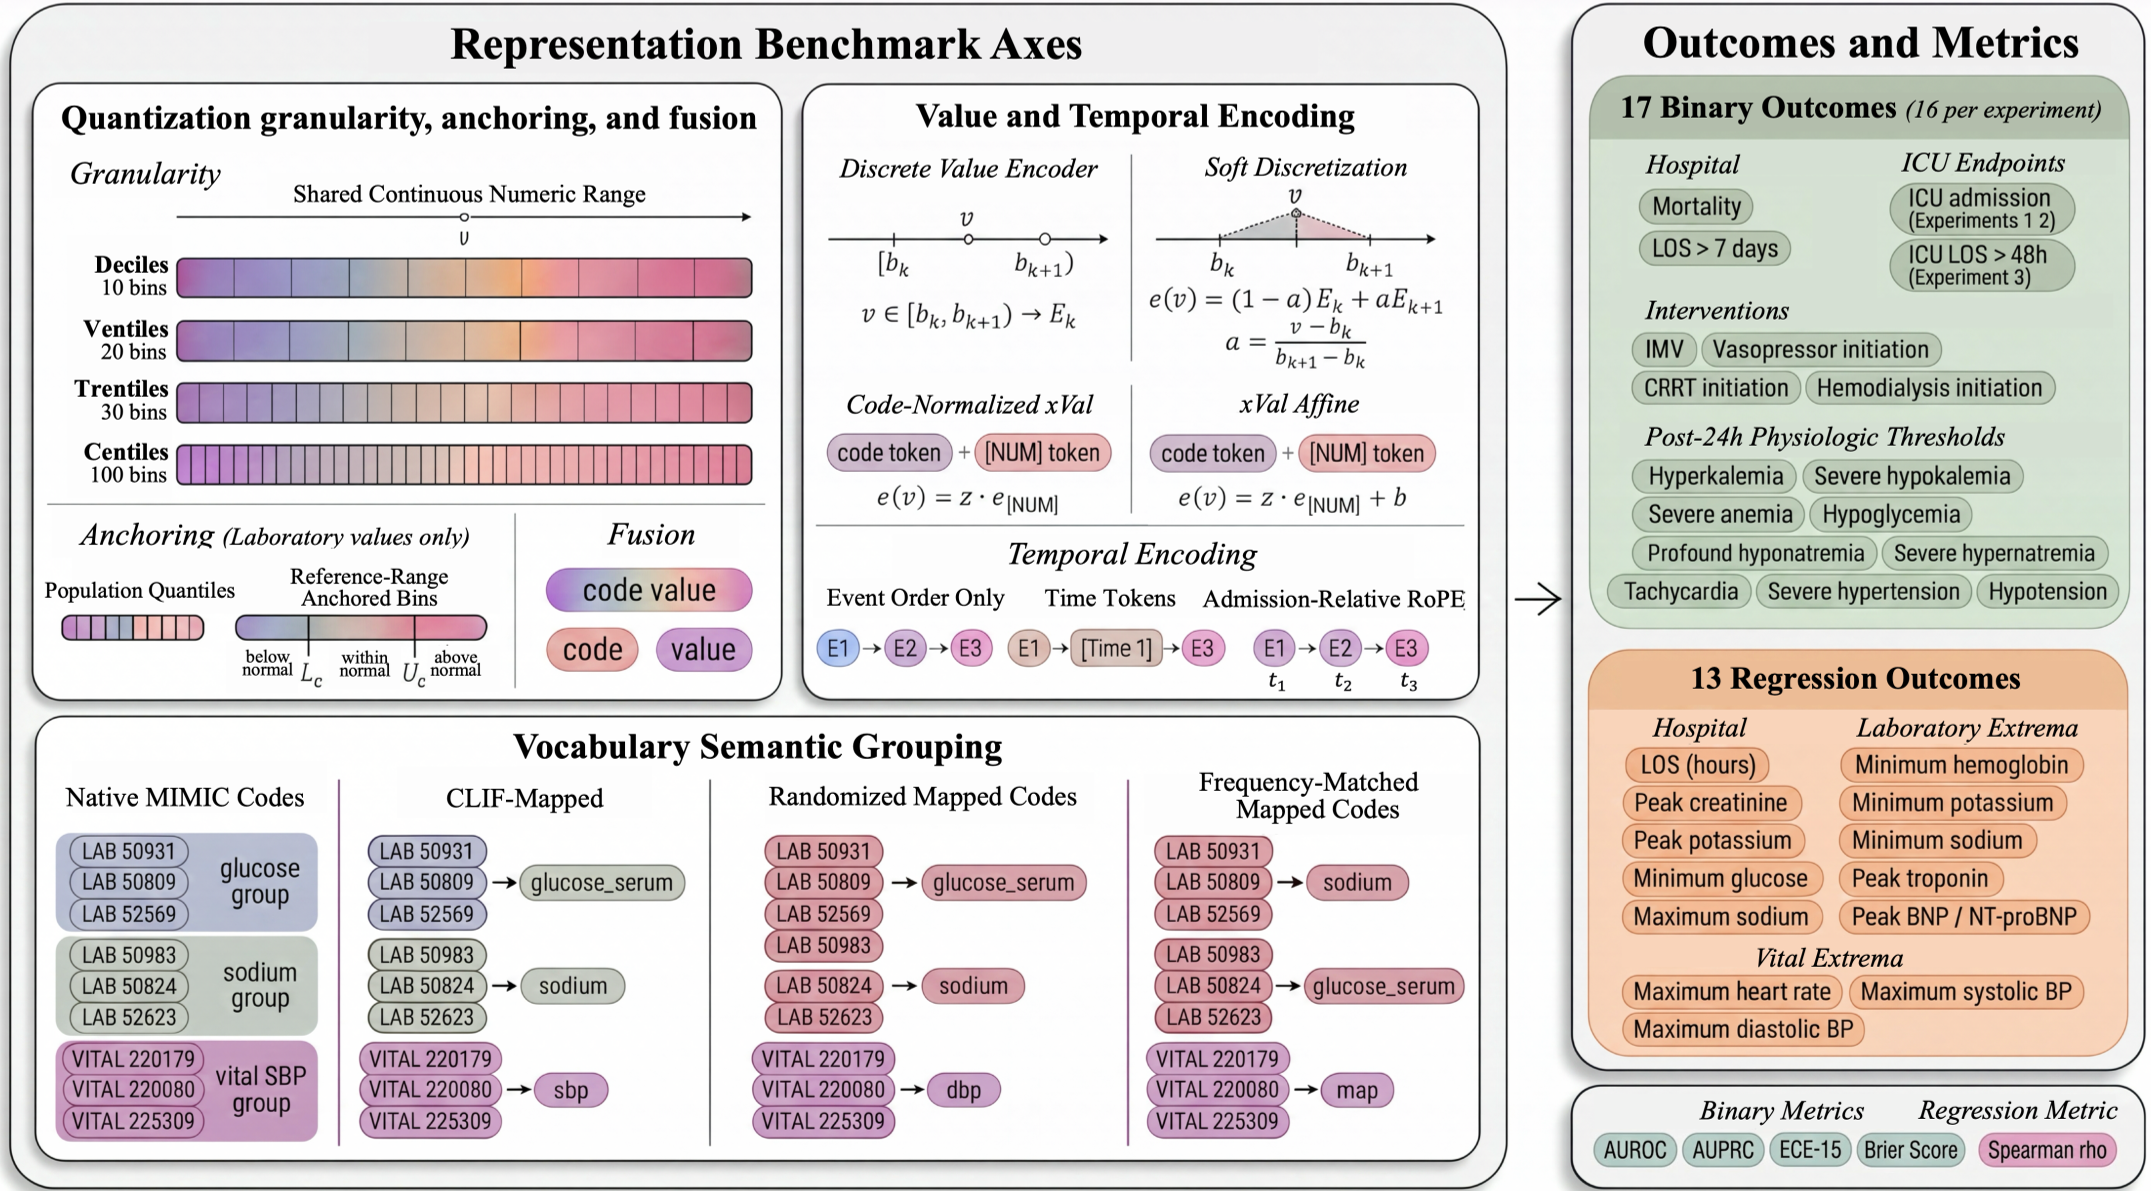
作者通过 28 个受控实验,拆解了输入表示的三个技术轴心:
1. 代码与数值的“局部绑定”(Experiment 1)
这是全篇最重要的发现:必须将测量代码(如“钾离子”)与它的数值分箱(如“第 7 分位”)融合成一个 Token(例如 LAB_Potassium_Q7)。
- 原因:如果不融合,模型必须在数千个测量中记住当前的
Q7属于哪项指标。 - 效果:死亡率 AUROC 提升 2.4%,住院时长预测 AUROC 提升 2.5%。
2. 时间编码:越简洁越好(Experiment 2)
传统做法是每两个事件之间插入一个 Time Token(如“间隔 1 小时”)。但实验结果令人惊讶:去掉 Time Tokens 更好。使用事件原始顺序或基于入院时间的 RoPE(旋转位置编码)不仅性能更强,还缩短了 11% 的序列。
3. 语义标准化(Experiment 3)
通过将 MIMIC 处理成 CLIF 标准格式,虽然词表缩小了,但下游性能几乎没有损失。这为未来的跨医院(Multi-site)大模型训练铺平了道路。
核心结果与 SOTA 对比
研究表明,在固定的单轮训练预算下,Deciles(十分位分箱) 是最佳的默认平衡点。更细的百分位分箱(Centiles)虽然理论精度高,但会导致词表出现大量“零频”Token,导致训练不足。
 上表展示了在各类任务中,Fused Deciles 方案几乎在所有核心指标(死亡率、ICU 住院时长等)上占据主导地位。
深度洞察:为什么连续编码(xVal)败给了离散分箱?
论文测试了前沿的 xVal(连续数值缩放)方法,发现其表现远逊于离散分箱。
- 直觉解释:医疗数据的异常值(Outliers)往往包含最高的信息量。
xVal在处理靠近中位数(z-score 接近 0)的数值时会产生表征压制(Suppression),导致模型对“平稳”状态的敏感度下降。相比之下,离散分箱为每个区间分配了独立的 Embedding 空间,学习效率更高。
总结与启示
这篇论文向我们展示了“磨刀不误砍柴工”的真理:
- 不要迷信超高精度:十分位分箱(Deciles)在小样本当下由于训练更充分,往往优于百分位分箱。
- 融合是王道:Code-Value Fusion 是目前提升医疗 AI 性能成本最低的手段。
- 精简序列:扔掉无用的 Time Tokens,利用 RoPE 或原生顺序。
对于医疗 AI 开发者而言,在盲目堆模型参数之前,重新审视你的 Tokenizer 词表可能是性价比最高的路。