
LaviGen:让 3D 生成模型“学会”排版,打造物理真实的自回归布局生成
Repurposing 3D Generative Model for Autoregressive Layout Generation
本文提出了 LaviGen,一个基于原生 3D 空间的自回归布局生成框架。该方法将 3D 生成模型的几何先验转化为布局能力,在 LayoutVLM 基准测试中实现了物理真实性提升 19% 且计算速度快 65% 的 SOTA 战绩。
TL;DR
在元宇宙和 AR/VR 的建设中,自动生成一个既符合语义逻辑(如椅子绕着桌子)又符合物理定律(没有物体穿模或悬浮)的 3D 场景一直是个难题。传统的 Layout-as-Language(如 LLM 输出文本坐标)往往“逻辑满分,物理零分”。
本文提出的 LaviGen 另辟蹊径:它不再把布局当成文本,而是直接利用 3D 原生扩散模型 的几何先验,以自回归(Autoregressive)的方式逐个放置物体。结果不仅让场景的物理合理性(Physical Plausibility)提升了 19%,还将推理速度提升了 65%。
痛点深挖:为什么 LLM 画不好 3D 布局?
当前的 3D 布局生成主要面临两大流派的困境:
- Layout-as-Language(如 LayoutGPT):将布局简化为 JSON 格式的坐标。LLM 虽有极佳的语义常识,但它并不理解 3D 空间中物体的包围盒碰撞和微小的物理间隙,容易产生“家具穿墙”或“沙发悬空”。
- Vision-based Optimization(如 LayoutVLM):利用 2D 渲染图来反推 3D 位置。虽然物理性有所改善,但这种“通过照片修模型”的方法计算量极大,且无法捕捉复杂的 3D 交互。
LaviGen 的直觉(Insight):既然场景布局本身就是一种几何分布,我们为什么不直接从 3D 几何分布中学习?
核心机制:LaviGen 的架构艺术
1. 从生成资产到生成布局
LaviGen 改造了 SOTA 3D 生成模型(如 TRELLIS)的架构。它保留了模型对稀疏体素(Voxel)占据率的敏感性。给它一个当前的场景 、一个待放置的物体 和一段文字指令,它就能在 3D 特征空间中“脑补”出更新后的场景 。
2. 身份感知嵌入 (Identity-aware Embedding)
在自回归过程中,模型必须搞清楚哪些是“旧家具”,哪些是“正要放的新家具”。LaviGen 扩展了传统的 RoPE(旋转位置嵌入),引入了一个 Identity Flag。
- 代表已存在的背景场景。
- 代表正在生成的当前物体。 这种设计让模型能够精准地进行语义解耦,避免新老物体“粘”在一起。
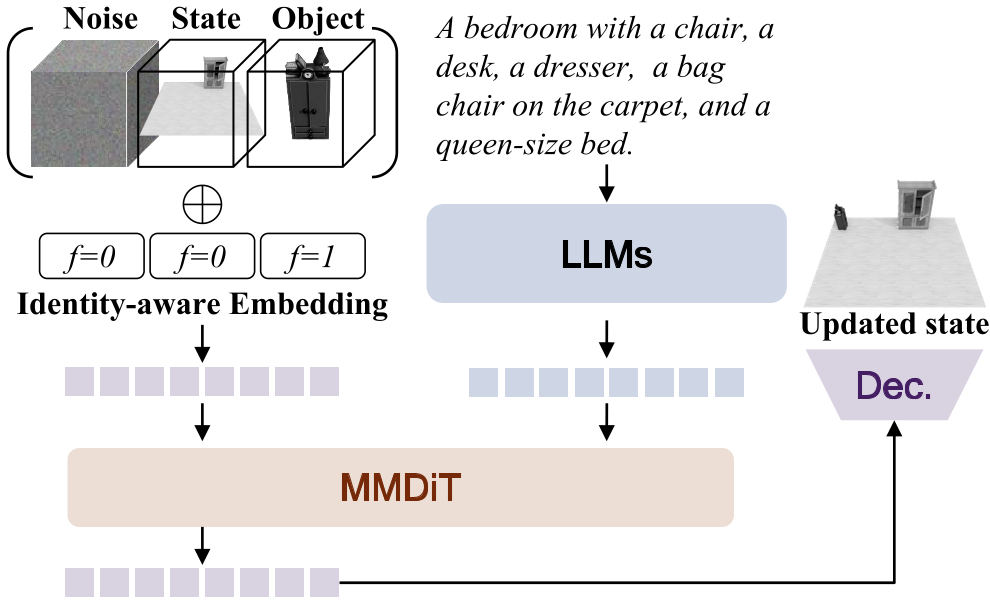 图 1:LaviGen 适配后的 3D 扩散架构,融合了场景、物体与身份嵌入。
3. 双重引导自回滚蒸馏 (Dual-Guidance Self-Rollout)
自回归生成最怕曝光偏差(Exposure Bias):一旦前一个物体放歪了,错误会不断累积。LaviGen 引入了“自我回滚”训练:模型在训练时不仅看标准答案,还要看自己生成的中间结果,并由两个“老师”共同纠偏:
- 全景老师 (Holistic Teacher):盯着最终效果好不好。
- 步进老师 (Step-Wise Teacher):盯着每一步放得正不正。
实验战绩:更快、更准、更真实
在 LayoutVLM 基准测试中,LaviGen 在物体碰撞消除(CF)和边界内评分(IB)上全线登顶。
| 方法 | 物理合理性 (CF/IB) | 语义对齐 | 推理速度 (T) |
|---|---|---|---|
| LayoutGPT | 83.8 / 24.2 | 80.8 | 21.3s |
| LayoutVLM | 81.8 / 94.9 | 77.5 | 75.5s |
| LaviGen (Ours) | 97.3 / 98.6 | 76.9 | 24.3s |
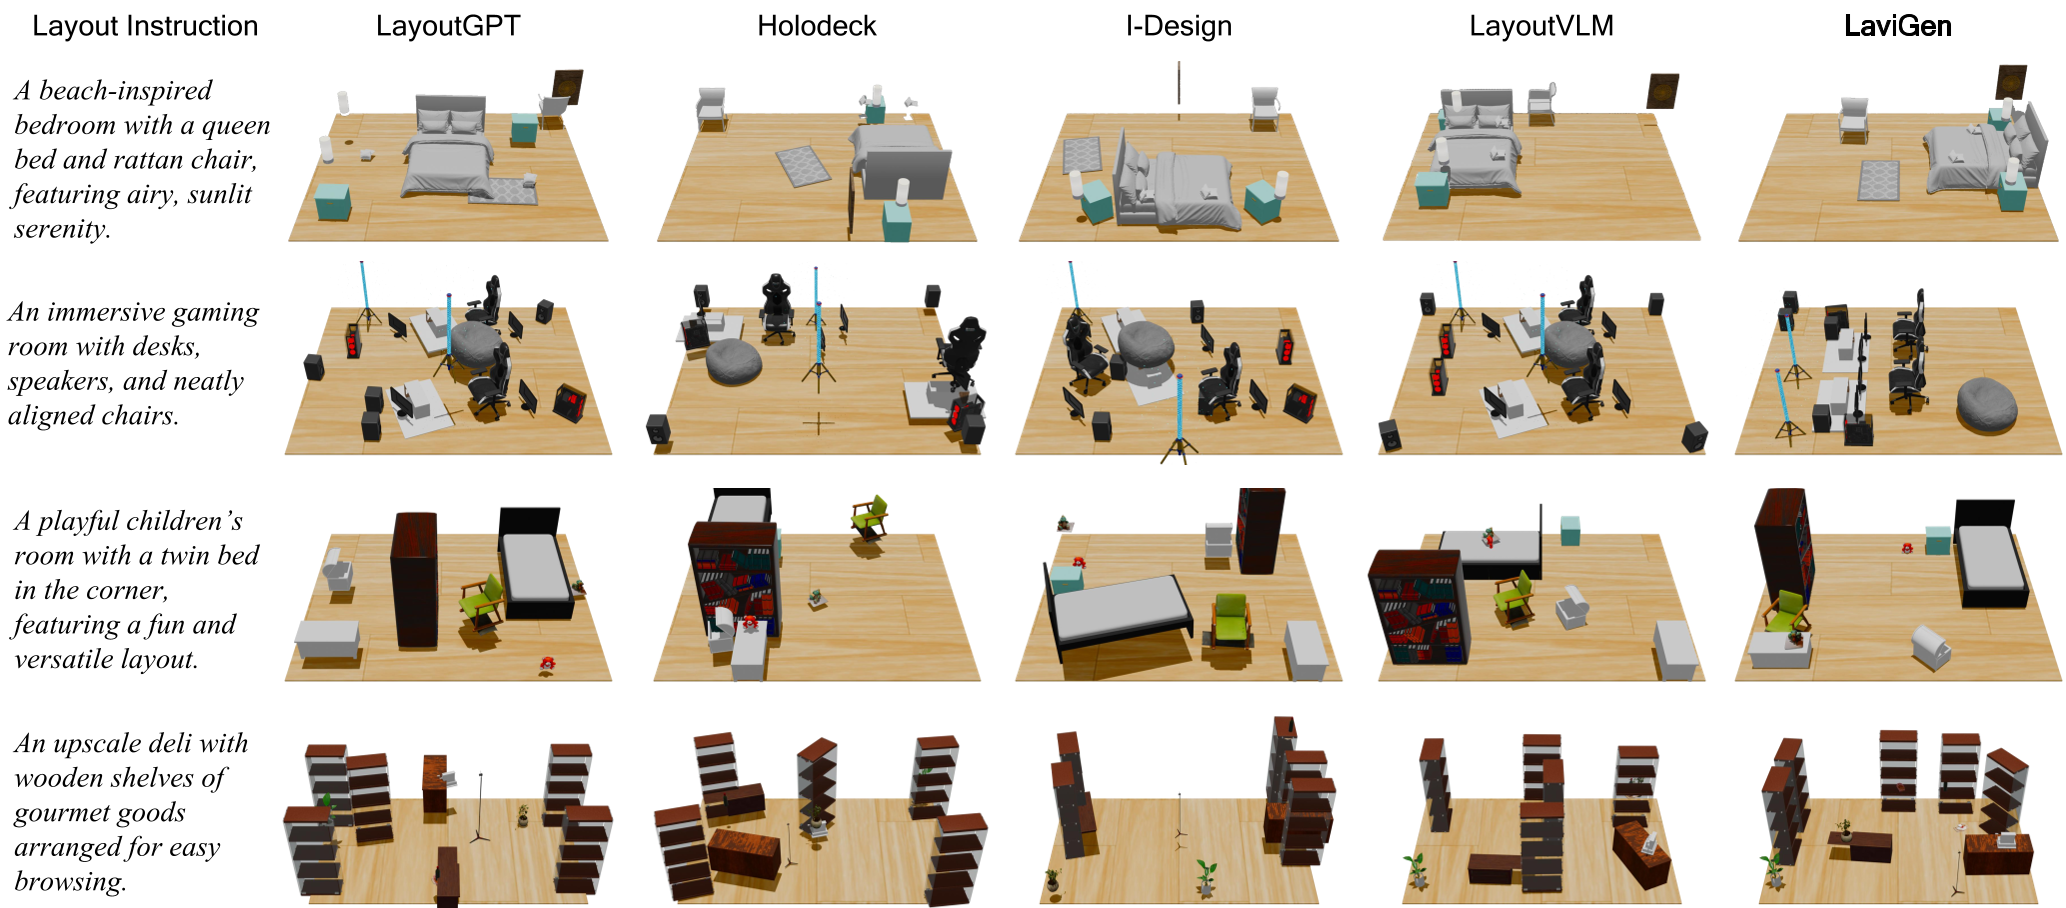 图 2:定性对比显示,LaviGen(最右)生成的游戏室、儿童房避开了基线模型常见的物体堆叠问题。
深度洞察:不止是生成
由于 LaviGen 工作在原生 3D 空间,它拥有前人难以企及的“编辑”能力。
- 布局补全:扔给它半个房间,它能根据指令把剩下的家电塞满。
- 灵活编辑:通过反向自回归,它可以实现物体的平滑移除和替换,这在 AR 应用中具有极高的产品价值。
总结与未来展望
LaviGen 的成功标志着 3D 布局生成从“跨模态翻译”范式转向了“原生空间演化”范式。目前的局限性在于 的分辨率对于极小的摆件可能不够精确。未来的研究方向将聚焦于更高精度的 3D 表征(如高阶 Voxel 或 Gaussian Splatting),以捕捉更细腻的室内细节。
这项工作为构建大规模、真实感强的虚拟世界提供了一块关键的拼图。