
[ICLR 2025] RewardFlow:无需反写的“奖赏驱动型”图像编辑与生成新范式
RewardFlow: Generate Images by Optimizing What You Reward
本文提出了 RewardFlow,一个无需训练 (Training-free) 且无需反写 (Inversion-free) 的图像生成与编辑框架。该方法通过多奖赏 Langevin 动力学 (Multi-reward Langevin Dynamics) 指导预训练的 Diffuion 和 Flow-matching 模型,在 PIE-Bench 和 T2I-CompBench 任务上取得了 SOTA 性能。
TL;DR
传统的 AI 图像编辑要么深陷于复杂的 Inversion(反写)泥潭,要么在零卸采样中面临内容漂移。UIUC 等机构的研究者提出了 RewardFlow,这是一个完全无需训练、无需反写的框架。它将图像编辑视为一个受多重“奖赏”驱动的优化过程,通过动态 Langevin 采样,实现了极高精度的局部化编辑与组合生成,采样效率提升高达 5 倍。
痛点深挖:为何精准编辑这么难?
当前的生成式编辑主要面临三大挑战:
- Inversion 之困:像 Null-text Inversion 等方法虽然忠实,但计算极其繁琐,且容易在重建时丢失细节。
- 语义泄漏 (Semantic Leakage):当改变图中某个物体时,背景或其他无关区域往往会发生改变。
- 缺乏细粒度逻辑:现有模型很难理解“把桌上的红苹果换成青苹果,但保持背景光影不变”这种复杂的组合逻辑。
Methodology:多奖赏 Langevin 动力学
RewardFlow 的核心在于将采样过程改写为一个可微分优化问题。
1. 分层奖赏工具箱 (Hierarchical Reward Toolkit)
作者不只依赖于 CLIP 这种全局语义,而是构建了一个层级体系:
- SP-level Rewards:针对每个“语义原语”(如“红苹果”),使用 SAM2 提取物体掩码,强制梯度只作用于特定区域。
- Differentiable VQA Reward:这是本文的一大亮点。通过 LLM 生成关于编辑目标的问答对(如“人的头上戴了什么?”),并利用视觉语言模型(如 Qwen-VL)的 Logits 计算梯度,为模型提供明确的语义逻辑监督。
2. 提示词感知的自适应策略 (Adaptive Policy)
并不是所有奖赏在所有时刻都同等重要。RewardFlow 的 Policy 会做三件事:
- 提取原语 (SPs):将复杂指令拆解为原子目标。
- 动态权重映射:在采样初期强调全局布局,后期强调局部细节。
- Reward-aware Step Size:如果当前 Reward 较低,则加大探索步长;若已接近目标,则减小步长进行精细微调。
 图 1:RewardFlow 框架概览,展示了从指令拆解到多奖赏引导的闭环流程
3. KL 锚点 (KL Tether)
为了防止过度优化(Reward Hacking)导致图像崩坏,作者引入了 KL 散度项,将每一时刻生成的潜在表示 (Latent) 软性地“拉回”到原始图像的分布附近,确保了身份(Identity)一致性。
实验战绩:全方位的 SOTA
在 PIE-Bench 的对比中,RewardFlow 在使用相同 Flux 后台时,各项指标均显著优于传统的 P2P、FlowEdit 等方法。
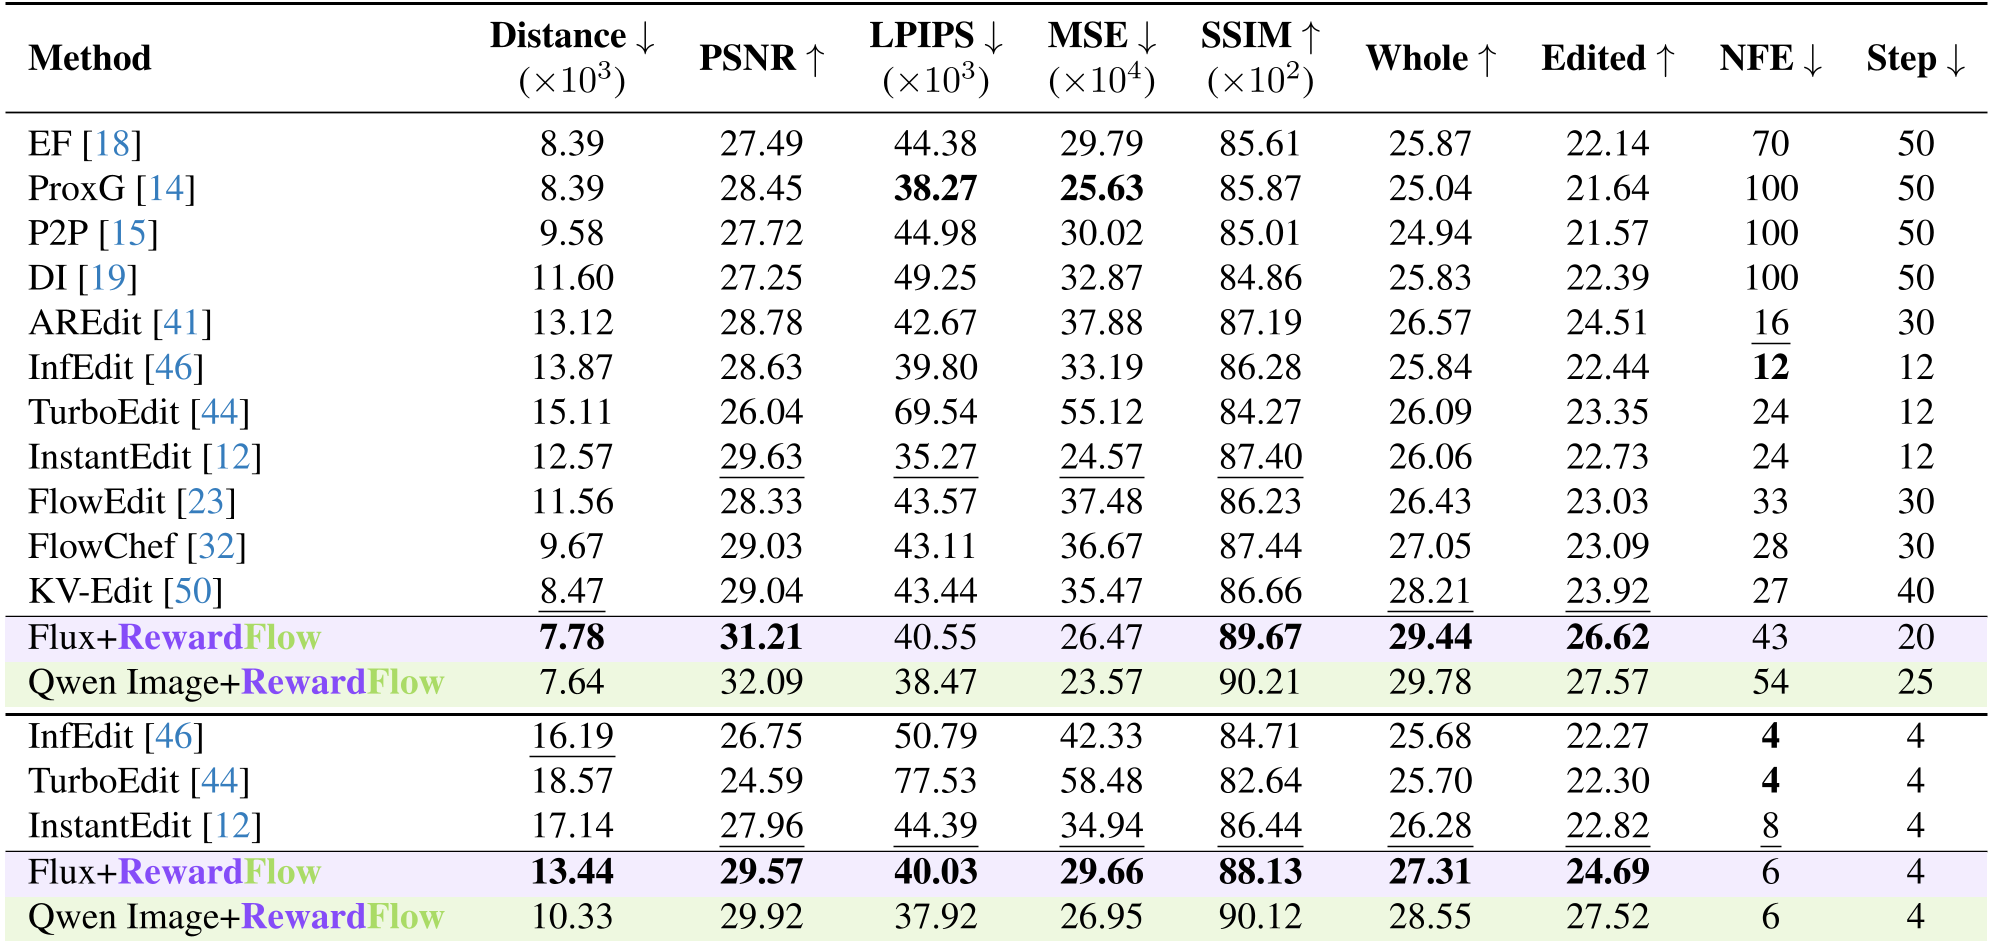 表 1:在 PIE-Bench 上的定量对比,RewardFlow 在 Edited Accuracy 上提升明显
视觉效果分析:正如梯度定位图所示,RewardFlow 能精准地将优化压力集中在目标物体轮廓内,完美解决了背景漂移问题。
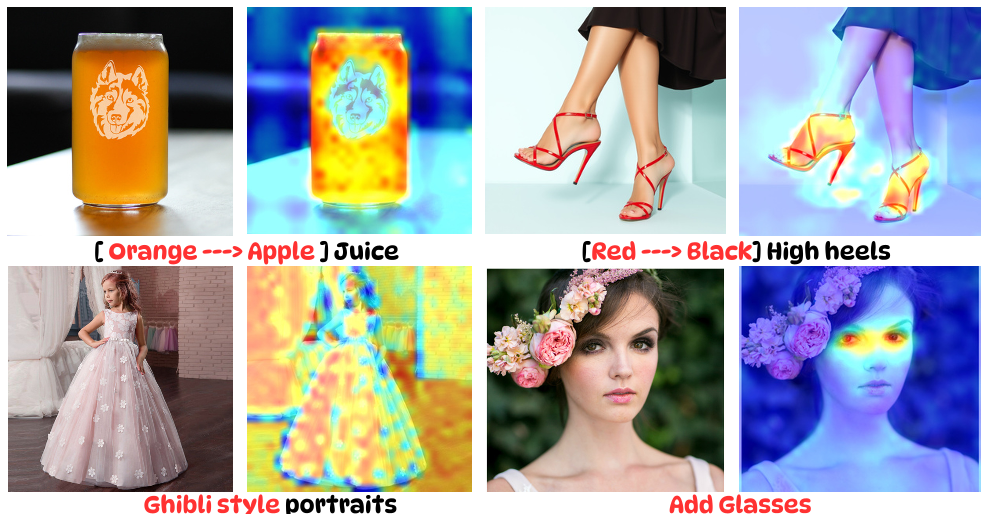 图 2:梯度定位对比,可以看到 RewardFlow 的梯度完美锁定了目标物体(如咖啡杯、胡萝卜)
深度洞察:为什么 VQA 奖赏如此重要?
在消融实验中,加入 VQA Reward 后,PSNR 从 30.12 提升到了 32.09。这说明了大模型自带的“逻辑常识”可以作为一种极强的正则化。当模型知道目标是“开着的箱子”时,VQA 会针对“箱子状态”这一特定维度施加更强的监督,防止模型只产生颜色的改变。
总结与展望
RewardFlow 成功地将 Controllable Generation 转化为一个轨迹优化问题。它证明了我们不需要重新训练庞大的 Foundation Model,通过在推理阶段巧妙地组合现有的视觉工具(SAM2, VLM, HPS),就能打破生成模型的逻辑黑箱。
局限性:尽管其通过步长优化提升了效率,但由于每个 Step 都需要多次 Backprop,其推理延迟仍高于单次 Forward 的精调模型。未来如何将这种 Reward 信号蒸馏回 Base 模型中,将是一个极具前景的方向。