
SASVD:突破暗光与高亮极限,饱和感知引导的盲图像去模糊新范式
Saturation-Aware Space-Variant Blind Image Deblurring
本文提出了一种名为 SASVD 的饱和感知空间变体盲图像去模糊框架。该方法结合光扩散函数 (LSF) 和暗通道先验 (Dark Channel Prior),通过估算饱和区域的真实辐射度来消除过曝光导致的伪影,在处理高动态范围 (HDR) 和低光照场景下的模糊图像方面达到了 SOTA 水平。
TL;DR
在深夜街头或面对强逆光拍摄时,相机往往会产生两种致命伤:运动模糊(由于曝光时间过长)和像素饱和(由于灯光过亮溢出)。本文提出的 SASVD 框架通过精确模拟光线在镜头内的散射路径,首次实现了对饱和区域“丢失辐射度”的高效补偿,彻底解决了传统方法在强光边缘产生的振铃效应,让模糊的夜景重现锐利。
1. 痛点:为什么饱和像素是去模糊的“杀手”?
在标准的计算机视觉模型中,模糊通常被建模为 (模糊图像 = 模糊核 * 清晰图像 + 噪声)。然而,当图像中出现像车灯、路灯这样的饱和像素时,这个线性公式就崩塌了:
- 信息截断:超过 255 的亮度值被强制截断,导致卷积关系的能量不守恒。
- 光散射伪影:镜头内的光线会发生衍射和反射,形成“Blooming”现象,这并非运动产生,却会被误认为是模糊核的一部分。
- 振铃效应:在去卷积算法中,饱和边缘的剧烈跳变会诱发波浪状的伪影,严重污染画面。
2. 核心机制:从物理直觉出发的 LSF 与暗通道
作者认为,要解决饱和问题,必须将底层物理光学纳入考量。
A. 光扩散函数 (LSF) 的预估
相机系统由于镜头设计,点光源会在传感器上产生散射。作者通过实验捕获了 HDR 图像,并拟合了一个径向对称的参数化模型: 这个公式描述了光线是如何从中心亮点向四周“渗漏”的。
B. 寻找“证据”:最小模糊块筛选
图像不同区域的模糊程度不同。算法巧妙地设计了一个工作流(Algorithm 2),通过梯度强度和去卷积方差筛选出那些离饱和区近、但自身模糊度低的“暗像素”块。这些暗像素就像是“光的传感器”,通过观察它们接收到了多少散射光,反向推导出饱和中心真实的、未被截断的亮度值。
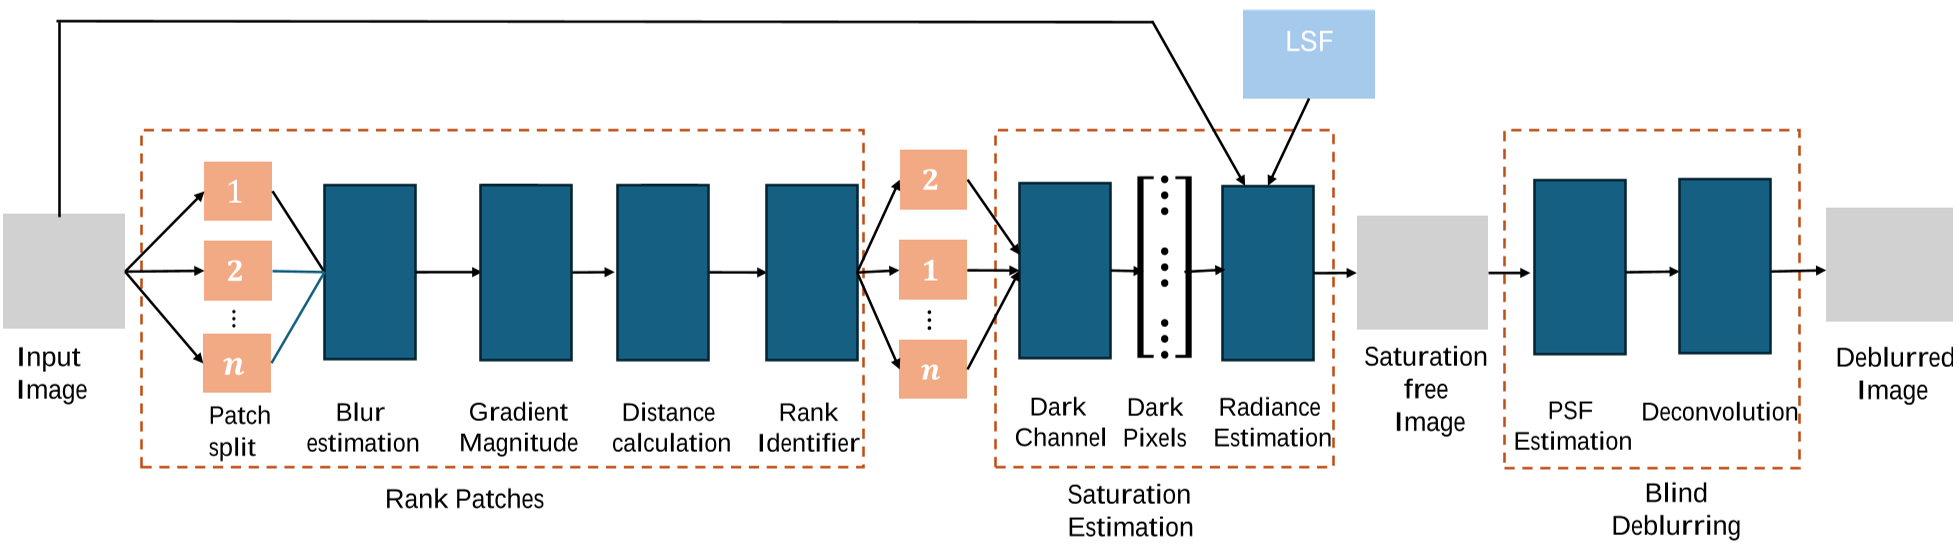 图 1:SASVD 处理框架流程,包含饱和区域估计与后续去模糊阶段
3. 实验战绩:全方位的性能碾压
在与其他 SOTA 方法(包括基于深度学习的 LoFormer 和基础去模糊算法)的对比中,SASVD 表现出了惊异的稳定性。
量化指标
作者提出了一种“SSIM 加权 PSNR”指标,旨在同时衡量信号保真度和人眼结构敏感度。实验表明,即便模糊程度不断增加(从 Im2 到 Im5),SASVD 的 SSIM 始终保持领先,这说明它对图像结构的保护极其出色。
| 方法 | 饱和处理 | PSNR x SSIM (Avg) | 耗时 (720P) |
|---|---|---|---|
| Proposed (SASVD) | 是 | 27.40 | 126s |
| Chen et al. [10] | 是 | 23.08 | 124s |
| Mao et al. [19] | 否 (Deep) | 11.68 | 247s |
定性效果对比
在真实场景(如隧道和夜间公路)中,SASVD 有效消除了灯光周围的模糊重影。
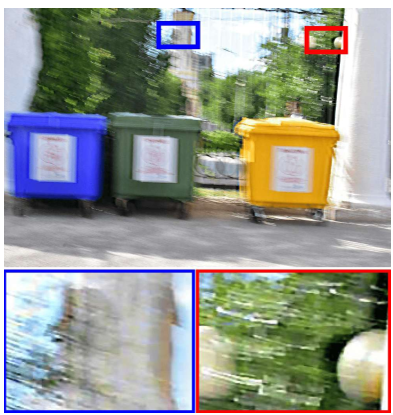 图 2:真实世界数据集上的对比,SASVD(左一、左二)在保持车灯轮廓锐利的同时,没有产生右侧传统方法的严重色散伪影
4. 深度洞察:为何非深度学习框架依然重要?
尽管当前是深度学习的时代,但这篇论文展示了物理模型建模的力量。其核心贡献在于:
- 即插即用:它可以作为一个前置增强模块,后续可以对接任何最先进的深度学习去模糊后端,显著提升它们处理异常曝光的能力。
- 解释性强:通过 LSF 参数而非黑盒网络处理光散射,使得结果更加符合物理常识,不容易产生 AI 生造出来的无关纹理。
5. 局限性与未来
当然,SASVD 并非万能。它依赖于寻找图像中的“暗像素”作为证据。如果一张图像超过 50% 都是极度饱和的白色(如对着太阳直射),那么算法将面临“证据不足”的困境,此时会退化为普通的去模糊方法。作者计划未来引入非对称 LSF 模型,以应对更复杂的广角镜头畸变。
结论:SASVD 成功地在模糊核估计的世界里,为“饱和效应”正了名——它不是必须剔除的噪声,而是可以被物理建模、并辅助复原的宝贵信号。