
[arXiv 2026] SelfEvo:无需标注,通过自蒸馏实现 4D 感知模型的自我进化
Self-Improving 4D Perception via Self-Distillation
本文提出了 SelfEvo,一个针对 4D 感知的自改进(Self-Improvement)框架。该框架利用时空上下文不对称性(Spatiotemporal Context Asymmetry)进行自蒸馏,使预训练的多视图重建模型(如 VGGT, π3)能在无需任何 3D/4D 人工标注的情况下,通过无标签视频持续进化,在动态场景重建中表现优异。
TL;DR
在 4D 感知领域,获取精确的几何标注(Ground-truth)是一项极其昂贵且难以扩展的任务。本文介绍的 SelfEvo 框架打破了这一僵局:它无需任何人工标注,仅通过无标签视频,利用模型自身在“看多”和“看少”时的表现差异(时空上下文不对称性)进行自蒸馏。实验显示,它能将现有 SOTA 模型(如 VGGT)在动态场景下的深度估计精度提升 36.5%,并展现出极强的跨领域泛化能力。
1. 痛点:静态假设的终结与标注荒
传统的多视图重建(MVS)和 Structure-from-Motion (SfM) 方法正逐步被基于 Transformer 的端到端模型(如 DUSt3R, VGGT)取代。然而,这些“几何地基模型”面临两大瓶颈:
- 标注成本:3D 标注已属不易,动态场景的 4D 轨迹标注更是天方夜谭。
- 部署僵化:模型一旦在固定数据集上训练完成,部署到现实世界(In-the-wild)遇到新分布(如游戏场景或机器人视角)时,性能往往会大幅缩水。
作者提出:既然模型在输入更多帧时天然预测更准,那为什么不让“看全貌”的自己去教“看局部”的自己呢?
2. 核心机制:时空上下文不对称性 (Context Asymmetry)
SelfEvo 巧妙地利用了学习型模型的归纳偏置(Inductive Bias)。通过建立一个 Teacher-Student 闭环,实现自驱动的性能迭代。
2.1 架构拆解
- Teacher (教师):接收丰富的时空上下文(例如视频中的 64 帧),产生高质量的几何和相机位姿预测作为“伪目标”。
- Student (学生):仅接收教师输入的一个稀疏子集(例如随机抽取的 2-12 帧)。
- 在线进化:教师不是固定的,而是学生参数的指数移动平均(EMA)。这意味着随着学生变强,教师也会水涨船高,形成向上的螺旋。
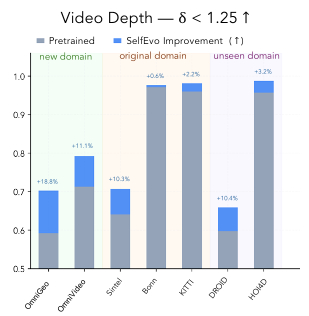 图 1:通过丢帧(Frame Dropping)制造信息差,驱动模型自我纠偏。
3. 为什么能有效?技术细节剖析
作者通过大量的消融实验(Ablation Study)确定了自改进的最优路径:
- 丢帧策略 (Frame Dropping) 胜过 图像增强:相比于改变颜色或裁剪,直接在时间维度上丢帧能制造最有效的“几何约束差”。
- 冻结相机解码器:在自蒸馏过程中,相机估计极易受伪标签噪声影响导致崩溃。作者发现,冻结相机解码器 (Freezing Camera Decoder) 同时更新骨干网络和深度解码器,能获得最佳的稳定性与灵活性平衡。
- 随机采样 vs 启发式采样:出人意料的是,简单的随机选帧比利用 Attention 分数选帧更具鲁棒性。
4. 实验战绩:泛化与留存
SelfEvo 在 OmniWorld-Game(游戏)、BEDLAM2.0(人类活动)及 DROID(机器人操作)等多个迥异的数据集上进行了验证。
核心提升数据:
- 深度估计精度:在 OmniGeo 挑战场景下,Abs Rel 误差显著下降,性能提升。
- 相机估计精度:AUC(15°/30°)相较于原始预训练模型有质的飞跃。
 表 1:SelfEvo 在不同 base model(VGGT, π3)和数据集上的性能跨越。
更令人振奋的是,这种自改进并不会导致“灾难性遗忘”。模型在提升新领域表现的同时,在 Sintel, KITTI 等原始指标上也保持了稳定甚至有所进步,这证明了 SelfEvo 实际上加强了模型的通用几何先验。
5. 局限性与展望
尽管 SelfEvo 表现卓越,但它仍依赖于一个非平凡的初始模型。如果预训练模型的起始预测完全错误,自蒸馏可能会陷入错误放大的恶性循环。此外,在相机完全静止的视频中,丢帧无法制造有效的不对称性。
总结: SelfEvo 标志着 4D 感知正从“监督学习”迈向“自我进化”。这种基于上下文不对称性的自蒸馏范式,不仅为动态场景重建提供了新工具,更对未来能够根据部署环境实时在线学习的 AI 系统提供了极具价值的参考方案。
想要了解更多技术细节,请访问项目主页:self-evo.github.io