
TEMPO:打破自进化瓶颈,实现大推理模型的测试时 Scaling
TEMPO: Scaling Test-time Training for Large Reasoning Models
本文提出了 TEMPO,一种针对大推理模型(LRMs)的可扩展测试时训练(Test-time Training, TTT)框架。该方法通过将 TTT 形式化为期望极大化(EM)算法,在无标注测试集上交替进行策略精炼与验证性奖励校准,显著突破了现有 TTT 方法的性能瓶颈。
TL;DR
长期以来,大推理模型(LRMs)在测试阶段的参数是静态的。虽然 Test-time Training (TTT) 试图通过无监督强化学习让模型“边考边学”,但往往会陷入奖励漂移和多样性崩溃的泥潭。本文提出的 TEMPO 框架,通过 EM 算法的视角重新审视了这一过程,引入了周期性的 Critic 重校准(Critic Recalibration),使得模型能像人类备考一样,在不断刷题(无标注测试集)的同时,通过看参考书(有标注数据集)来校准自己的评价标准。
痛点深挖:为什么“自我奖励”会走向死胡同?
目前的 TTT 方法(如 TTRL, EMPO)核心逻辑是:模型自己做题,然后通过“多数投票”或“预测熵”来判断对错,再以此更新权重。
这种模式存在的本质缺陷在于:由于缺乏外部参照,模型会变得越来越自大。当模型由于初始偏见自信地给出了一个错误答案,并且通过多次采样形成“伪共识”后,它会进一步强化这一错误路径。这导致了两个致命结果:
- 性能平台(Performance Plateau):提升到一定程度后无法再通过增加计算力获得收益。
- 多样性崩溃(Diversity Collapse):模型只会用一种套路解题,失去了探索更优解的能力。
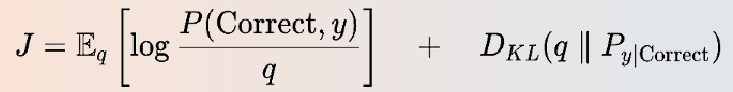 图 1:传统 TTT 方法(灰色)很快陷入平台,而 TEMPO(蓝色)随步数持续攀升。
方法论详解:EM 框架下的交替进化
作者将测试时训练建模为一个隐含变量问题:正确性是测试时不可见的“潜变量”。为了最大化证据下界(ELBO),TEMPO 设计了两个交替进行的阶段:
1. E-Step:Critic 重校准 (Critic Recalibration)
这一步是 TEMPO 的精髓。模型不在测试题上磨蹭,而是回到一小部分有标注的练习题()。利用 ground-truth 标签来更新 Critic 模型 ,使其学会精准预判一个推理轨迹是否通向正确答案。这一步通过最小化均方误差(MSE)来实现: 其中 是真实的对错标签。
2. M-Step:策略精炼 (Policy Refinement)
在拥有了“明白人”Critic 后,模型回到无标注测试题()。Actor 生成推理链,Critic 给出评分,然后通过策略梯度(Policy Gradient)优化 Actor 参数 。因为 Critic 刚刚在练习题上被校准过,它给出的奖励信号是客观的,从而避免了 Actor 的盲目自信。
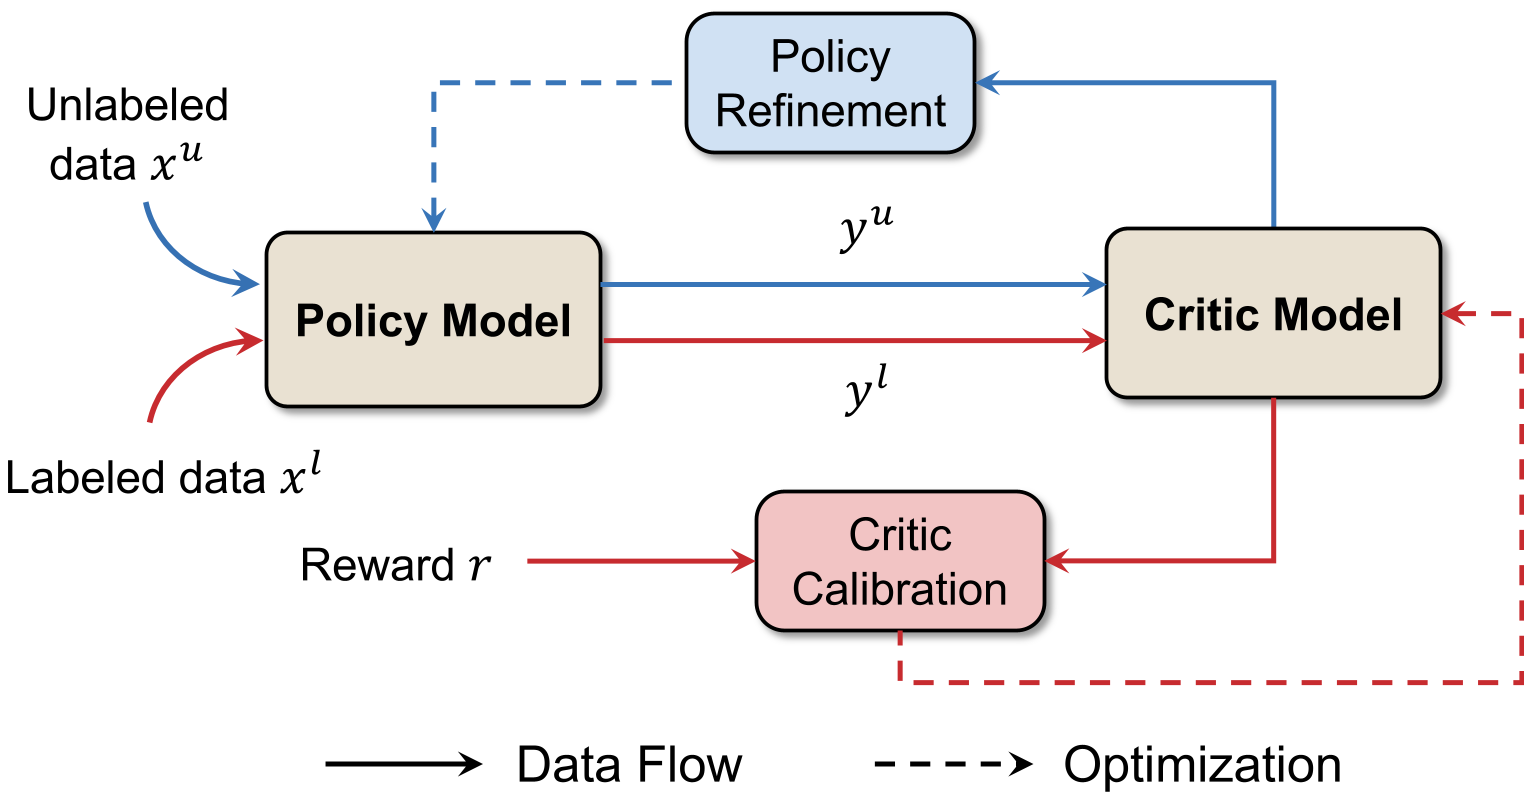 图 2:TEMPO 的交替式演进流程。
实验与结果:全线突破 SOTA
TEMPO 在多个模型架构(Qwen3, OLMO3)和复杂推理任务(AIME, ZebraLogic, GPQA)上进行了验证,结果令人震撼:
- 绝对准确率提升:在极其困难的 AIME 2024 竞赛题中,Qwen3-14B 的 Avg@16 从 42.3% 暴涨至 65.8%。
- 多样性保护:相比于 TTRL 这种会导致 Pass@K 随着训练反而下降的方法,TEMPO 在提高平均分的同时,保留了模型从多种角度解决问题的能力。
- 泛化能力:TEMPO 不仅玩得转数学。在逻辑谜题(ZebraLogic)和 STEM 领域(GPQA-Diamond)同样表现出极强的适应性。
 表 1:TEMPO 在各尺度模型上的性能表现,提升极其显著。
消融实验的关键发现
作者对比了“固定 Critic”和“动态校准 Critic”的曲线。结果显示:如果 Critic 不在训练中动态校准,其性能提升会很快停止。这验证了 E-Step 并非可有可无的插件,而是维持系统持续进化的核心动力。
深度洞察:LRM 的未来是“测试时 scaling”
TEMPO 的成功标志着大推理模型的研究重心正在从单纯的“离线预训练”转向“在线自适应”。它告诉我们:
- 反馈的质量决定了天花板:无监督的 Feedback 本质上是 Low-rank 的。
- 计算量即性能:只要能维持奖励信号的真实性,更多的测试时计算(FLOPs)确实能直接闭环转化为更高的推理能力。
局限性:TEMPO 需要同时维护 Actor 和 Critic,显存开销相对较大,且对高质量的参考标注集存在依赖。未来如何降低这种计算开销,将是其走向实时生产环境的关键。
总结 (Takeaway):TEMPO 通过重塑 TTT 的数学框架,找回了被忽视的 Critic 校准步骤,成功实现了大推理模型在测试时的“大力出奇迹”。