
TSM-Pose:语义 Mamba 与拓扑感知,重塑类别级物体姿态估计的精度天花板
TSM-Pose: Topology-Aware Learning with Semantic Mamba for Category-Level Object Pose Estimation
总结
问题
方法
结果
要点
摘要
本文提出了 TSM-Pose,一种针对类别级物体姿态估计(COPE)的创新框架。该方法通过引入拓扑提取器和基于 Mamba 的全局语义聚合器(MGSA),显著提升了模型在面对同类物体形状剧烈变化及遮挡环境时的泛化能力,在 REAL275 和 HouseCat6D 等主流数据集上刷新了 SOTA 性能。
TL;DR
在机器人抓取和自动驾驶等领域,类别级物体姿态估计 (COPE) 是一项核心挑战。本文提出的 TSM-Pose 框架,通过引入代数拓扑学中的持久同调和高效的 Mamba 序列建模,解决了同类物体形变带来的泛化难题。在不依赖 CAD 模型的前提下,TSM-Pose 在 REAL275 数据集上的核心指标提升了 8.6%,达到了当前最顶尖 (SOTA) 的水平。
痛点深挖:为何长得像却认不准?
现有的 COPE 方法主要面临两个瓶颈:
- 特征的不稳定性:传统的 PointNet++ 等网络提取的是局部几何特征,一旦物体发生形变或被部分遮挡,这些特征就会产生剧烈波动,导致模型难以识别出“这是同一类物体”。
- 语义稀释与长程缺失:为了计算效率,大家通常会把密集的点云压缩成稀疏的关键点。但这个过程会丢失大量的语义上下文,且简单的 Pooling 操作无法理顺关键点之间的复杂的空间位置关系。
核心机制详解:拓扑稳定性与 Mamba 长程建模
1. 拓扑提取器 (Topology Extractor):捕捉“不变形”的灵魂
作者的直觉非常精妙:无论罐子是胖是瘦,其拓扑结构(如孔洞数量、连通性)是相对稳定的。
- 方法:利用 Alpha Complex 构建嵌套的复形序列。
- 特征:计算 (连通分量)和 (环结构)的持久熵(Topological Entropy)和 Betti 曲线。
- 效果:图 1 的 T-SNE 可视化显示,加入拓扑特征后,同类物体的特征分布更加紧凑,异类物体的区分度更高。
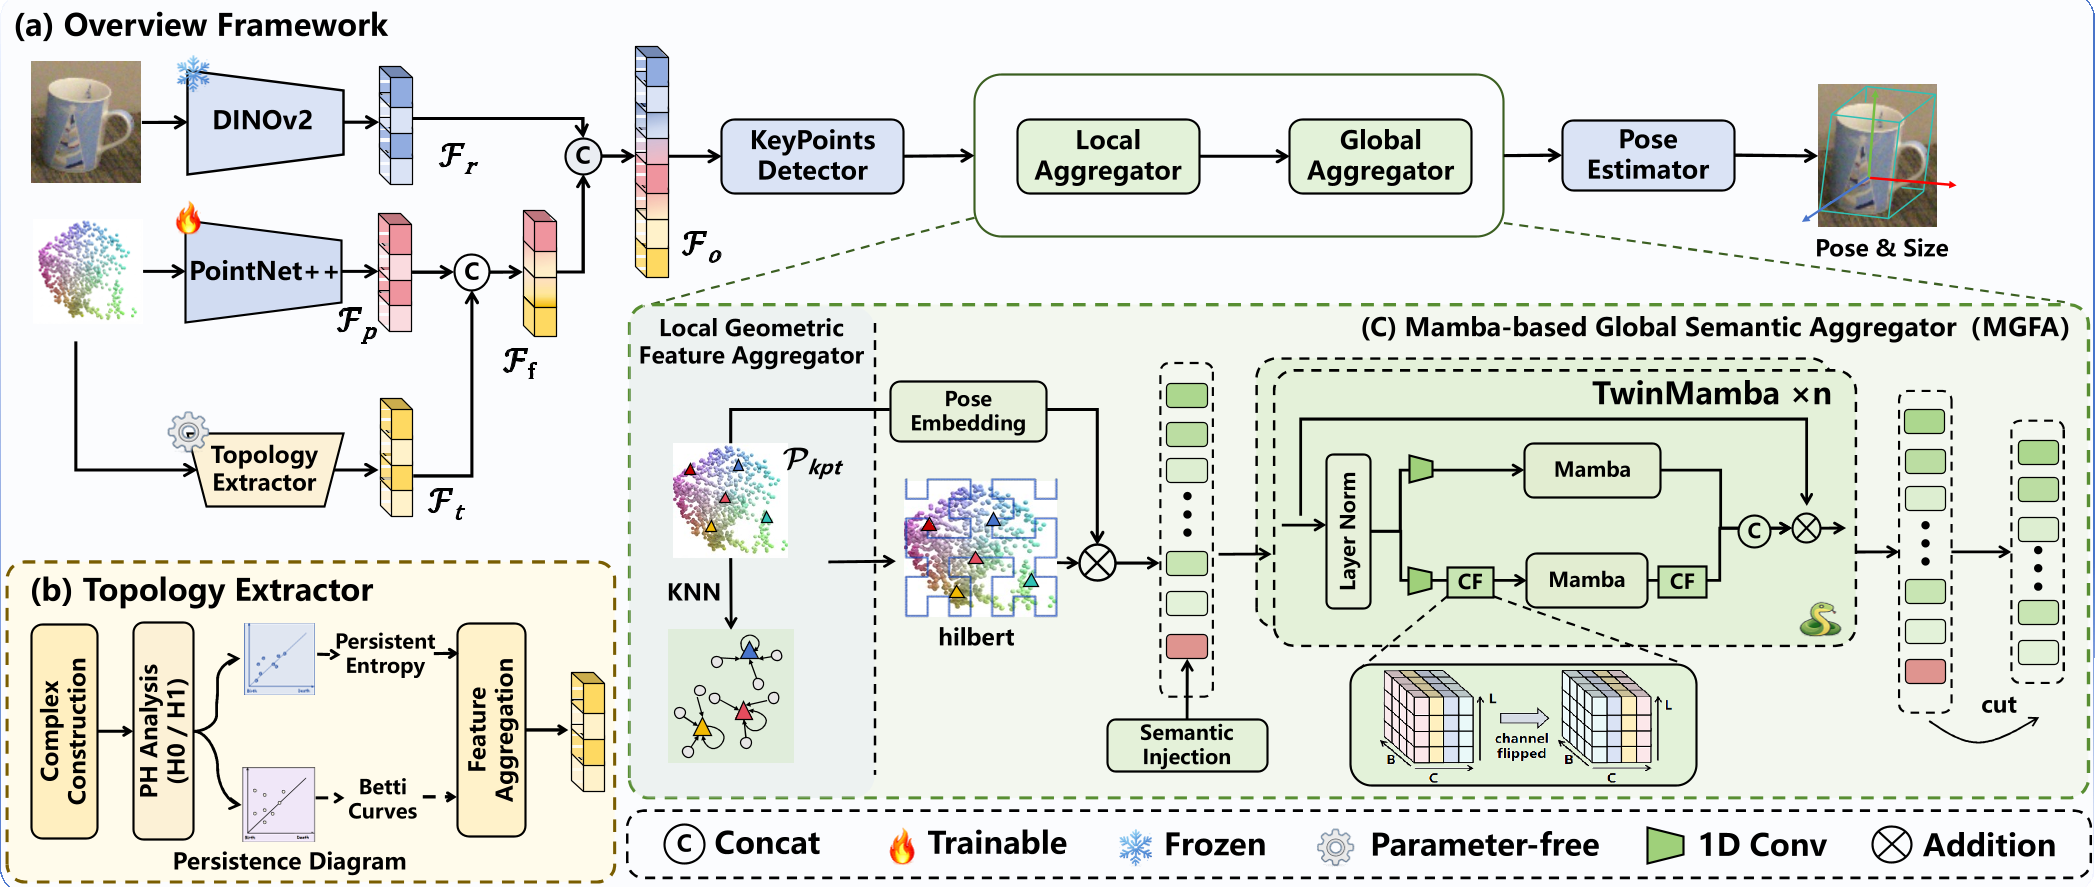 图 2:TSM-Pose 整体框架,包含多模态融合、拓扑提取与 MGSA 模块。
2. MGSA 模块:让 Mamba 注入语义
为了高效处理稀疏关键点序列,TSM-Pose 并没有直接套用 Transformer,而是选择了推理更高效的 Mamba。
- 语义注入 (Semantic Injection):在关键点序列前加入一个 CAT Token(类别编码),让网络在全局推理前先明确“我在看的是相机还是杯子”。
- TwinMamba 结构:为了克服单向序列建模的局限,设计了双路径架构。通过 Channel Flipping (CF) 操作,在不破坏空间排序的前提下,从不同维度建模关键点间的依赖关系。
实验战绩:全线领先
TSM-Pose 在三个衡量 COPE 性能的权威数据集上展现了统治力:
- REAL275 (真实环境):在 最严苛的指标下,精度从 57.0% 暴涨至 62.4%。
- HouseCat6D (重度遮挡):各个指标均稳定领先前人工作(如 CleanPose 和 AG-Pose)。
 表 1:与 SOTA 方法在 REAL275 数据集上的量化对比。
深度洞察
TSM-Pose 的成功证明了**传统数学工具(拓扑学)与现代深度学习架构(Mamba)**结合的巨大潜力。
- 为什么有效? 因为拓扑特征提供了“宏观的结构约束”,补足了深度学习局部感知的短板;而 Mamba 则在计算开销极低的情况下,实现了类似 Transformer 的全局视野。
- 局限性:不得不提的是,拓扑特征提取目前主要依赖 CPU 计算(如原文所述,主频降至 15 FPS),这在对实时性要求极高的场景下仍是短板。
总结
TSM-Pose 为 3D 感知提供了一个极其稳健的新思路——通过“代数拓扑提取结构本质”+“Mamba 处理语义长程”。这不仅是姿态估计任务的突破,也为未来的具身智能(Embodied AI)物体理解提供了坚实的理论与技术支撑。