
[CVPR 2025(?)] U-Cast:打破“复杂性陷阱”,极简 U-Net 也能登顶概率天气预报 SOTA
U-Cast: A Surprisingly Simple and Efficient Frontier Probabilistic AI Weather Forecaster
本文提出了 U-Cast,一种极其高效且简单的概率 AI 天气预报模型。该模型采用标准的 U-Net 架构,通过“确定性预训练 + 概率微调”的两阶段课程学习方案,在 1.5° 分辨率下达到了与 GenCast 等顶尖模型相当的预报精度。
TL;DR
在 AI 天气预报(AIWP)领域,人们普遍认为“性能”必须以“架构复杂性”和“算力堆砌”为代价。然而,U-Cast 的出现给出了强力回击:通过一个标准的 U-Net 骨干网,配合两阶段课程学习和 Muon 优化器,仅需不到 12 个 H200 GPU 日即可完成训练。其预报技能不仅超越了传统的欧洲中期天气预报中心(IFS ENS),更在推理速度上比扩散模型快了一个数量级。
背景定位:逃离“复杂性陷阱”
目前的 SOTA 模型(如 Google 的 GenCast)大多采用复杂的图神经变换器(Graph Transformers)或球面神经算子,并且依赖扩散模型(Diffusion)或大规模集成训练。这导致普通实验室根本无法复现。U-Cast 的核心动机在于:这种复杂性真的是必须的吗?
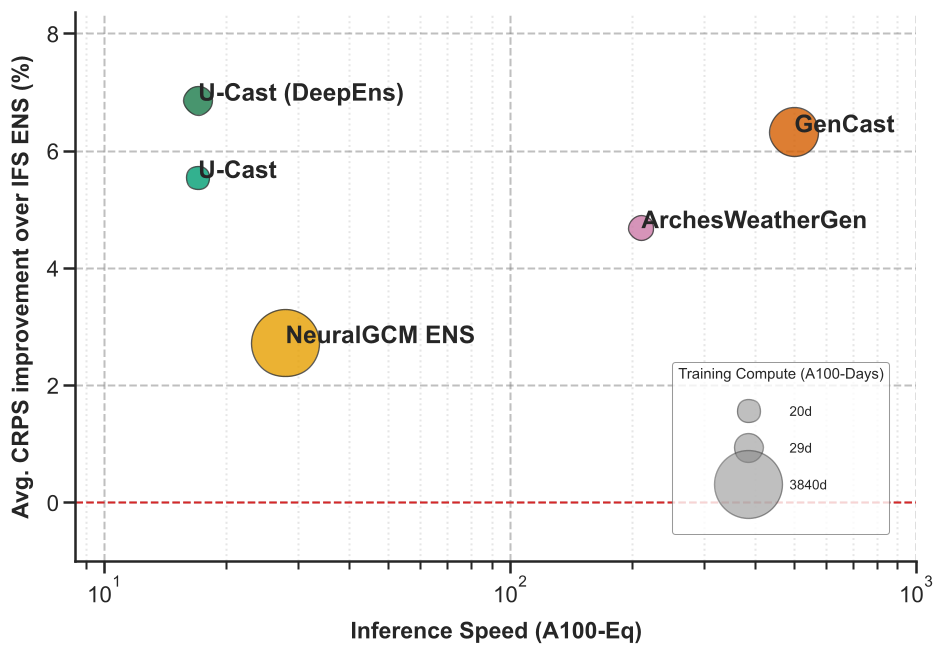 如图 1 所示,U-Cast(左上角)在保持极高预测技巧的同时,显著降低了训练和推理成本,处于帕累托前沿的最优位置。
核心方法:化繁为简的三个支柱
1. 回归 U-Net:卷积的局部归纳偏置
作者并没有使用复杂的图结构,而是采用了用于图像生成的 DhariwalUnet。他们认为大气动力学在短时间内主要是局部的,卷积层非常适合捕获这些物理变换。
- 改进:引入周期性填充(Circular Padding)来处理地球的长经度周期性;使用瓶颈层自注意力处理非局部交互。
- 优势:代码量从图网络的 3000+ 行缩减至 500 行以内。
2. 两阶段课程学习 (Curriculum Learning)
这是 U-Cast 能够节省 10 倍算力的关键(见下图)。
- 第一阶段:确定性预训练。使用 MAE 损失训练 100 个 Epoch,让模型学好物理动力学。因只需单次前向传播,成本极低。
- 第二阶段:概率微调。在预训练基础上,仅用 8 个 Epoch 进行 CRPS 损失微调。
- 直觉:解耦“学习物理规律”和“学习不确定性”。
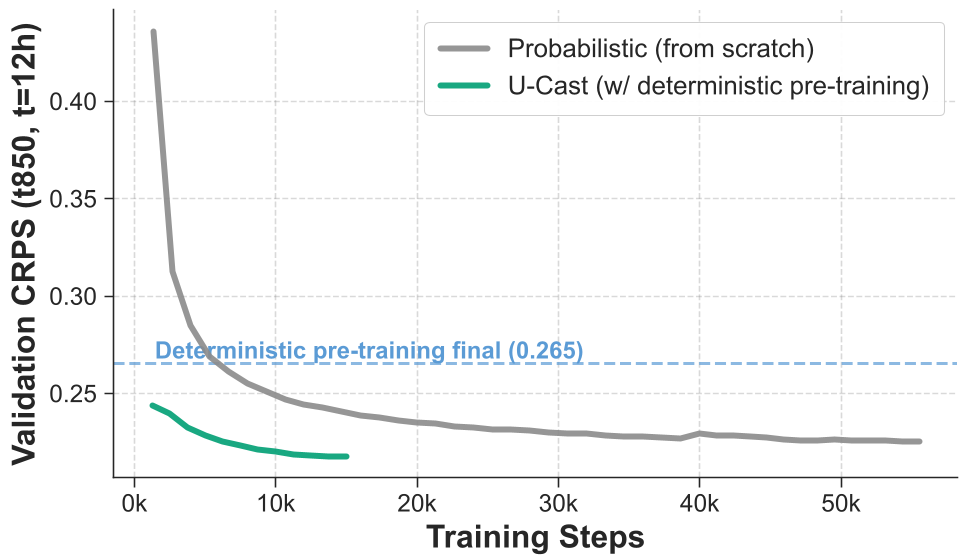 从图 5 可以看出,课程学习(橙色线)比从零开始训练 CRPS(灰色线)收敛速度快 3 倍,且最终效果更优。
3. MC Dropout 替代噪声注入
传统模型喜欢在 LayerNorm 中注入随机噪声,但这增加了参数。U-Cast 直接使用 Monte Carlo Dropout。作者反驳了“Dropout 会导致分布过窄”的传统观点,证明只要配合 CRPS 目标函数,Dropout 同样能产生校准良好的系预报。
实验战绩:极致的性价比
在 WeatherBench 2 的 1.5° 评估中,U-Cast 的表现令人惊艳:
- 胜率:在 92.9% 的变量-时效组合上超过了物理基准 IFS ENS。
- 训练成本:总预算约 8.2-11.8 H200 天,而 FGN 等模型动辄需要 500+ TPU 天。
- 推理速度:单次 60 步预报仅 11 秒(单张 H200),极其适合大规模集成预报或极端事件检测。
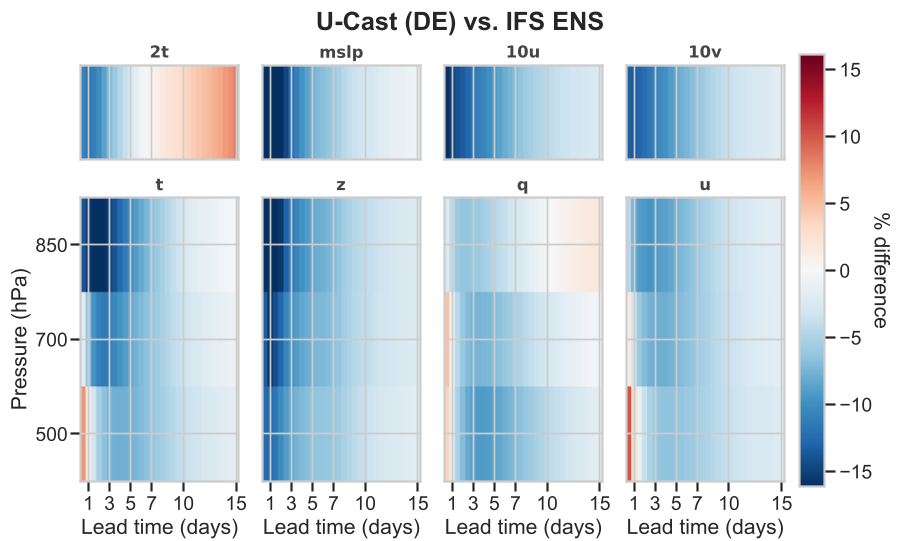 图 2 显示,U-Cast 在绝大多数气象变量(如地质位势、海平面压力)上均显著优于传统的 IFS ENS。
深度洞察
U-Cast 最具启发性的点在于其对 Muon 优化器 的使用。在概率微调阶段,Muon 的动量正交化特性远优于 AdamW,是实现“超短 8 Epoch 微调即收敛”的幕后推手。
尽管如此,U-Cast 并非完美。光谱分析显示它在极地区域存在人工痕迹(Artifacts),这反映了 2D U-Net 处理球面拓扑的局限性。未来结合轻量化球面算子可能是更优的路径。
总结
U-Cast 是一份“降维打击”的实证:它通过极致的工程优化和对训练策略的理解,实现了对高昂架构的“替代”。它不仅是一个技术方案,更是一种民主化 AIWP 研究的精神——让学术实验室也能训练出前沿的天气大模型。