
UniT:构建人类与机器人的通用物理语言,开启类人智能的“跨身体”迁移
UniT: Toward a Unified Physical Language for Human-to-Humanoid Policy Learning and World Modeling
本文提出了 UniT,一种通过视觉锚定(Visual Anchoring)实现的统一潜在动作分词器,旨在解决类人机器人数据稀缺的问题。该方法通过将异构的人类与机器人动作映射到共享的离散潜在空间,实现了 SOTA 级别的跨动作体政策学习和世界模型构建。
TL;DR
在机器人领域,获取高质量的类人机器人(Humanoid)操作数据既昂贵又缓慢,而人类的日常操作视频却在互联网上随处可见。本文提出的 UniT (Unified Latent Action Tokenizer) 就像一个翻译官,它通过**视觉锚定(Visual Anchoring)**技术,将人类的手部动作和机器人的关节指令翻译成了一种通用的“物理语言”。这种统一的表示法让机器人能直接从人类视频中“悟”出物理交互的本质,实现了极高的数据效率和零样本的任务迁移。
背景定位
目前具身智能(Embodied AI)正处于从单任务向大模型演进的十字路口。本文在学术坐标中属于**跨动作体学习(Cross-embodiment Learning)**的前沿工作。它不仅刷新了仿真性能,更重要的是给出了一种处理异构硬件(Heterogeneous Hardware)差异的系统性方案。
痛点深挖:为什么“看视频学动作”这么难?
现有的方法通常面临两个极端:
- Action-Only (纯动作派):只关注关节弧度。这种方法在不同机器人之间无法通用,因为类人机器人的 50 个自由度与人类的骨骼结构根本无法精准匹配。
- Vision-Only (纯视觉派):只从像素推断意图。这容易受到背景、光照等无用干扰项(Confounders)的影响,且丢失了极其关键的精细动作细节(Fine-grained details)。
核心方法:UniT 的“三分支交叉重建”
UniT 的作者提出了一个深刻的洞见:虽然动作的“过程”千差万别,但动作产生的“结果”在视觉上是一致的。
1. 视觉锚定机制
UniT 设计了一个对称的架构。视觉分支就像一个“正向动力学模型”,它要求动作 Token 必须能预测出视觉上的变化(例如物体位移)。反之,动作分支也需要从视觉变化中重构出对应的运动趋势。
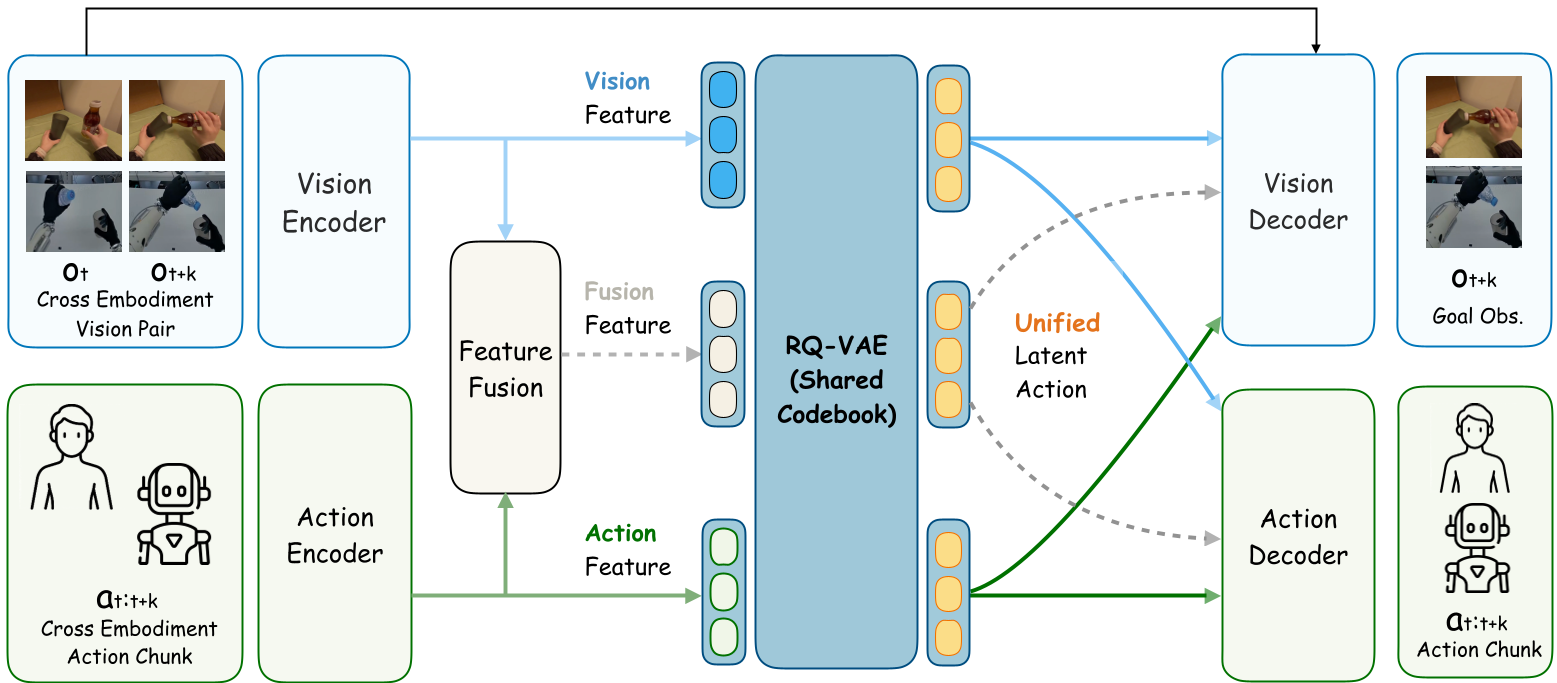 UniT 架构图:通过共享的 RQ-VAE 密码本(Codebook),将视觉、动作、融合特征对齐到统一空间。
2. 共享潜在空间
通过这种交叉重建(Cross-Reconstruction),UniT 强迫来自不同身体(人类 vs. 机器人)的数据在向量空间中“会师”。t-SNE 可视化证明,原本完全隔离的人、机分布,在 UniT 空间中变得高度重叠。
实验战绩:不仅仅是数据的堆砌
文明级的泛化能力
在一项未曾见过的“叠碗”任务中,即使机器人从未接受过相关训练,通过 UniT 吸收的人类操作经验,它展现出了惊人的**零样本迁移(Zero-shot Transfer)**能力。它不仅学会了如何放碗,甚至学会了像人一样通过转动腰部、转动头部来获得更好的视场。
极致的数据效率
当训练数据减少到 10% 时,UniT 支持的 VLA 模型依然保持了极佳的鲁棒性,性能甚至逼近了全量数据训练的传统基线。
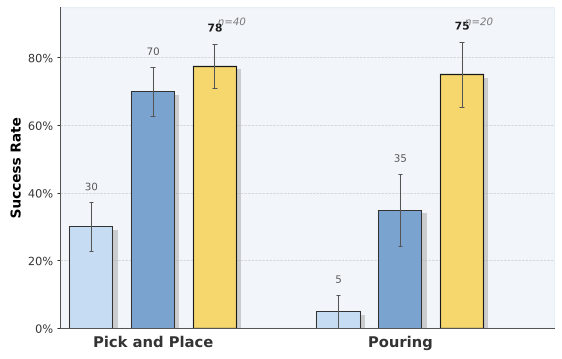 在真实世界的“抓取与倾倒”任务中,UniT 模型展现出了远超 Baseline 的成功率。
深度洞察:迈向通用类人能力的必经之路
UniT 的成功验证了一个关键趋势:表征学习(Representation Learning)必须走在政策学习(Policy Learning)之前。
通过将动作抽象为“物理意图”,我们不再需要为每一种新型号的机器人重新收集数千小时的昂贵数据。未来的机器人可能就像现在的 LLM 一样,先通过观看全人类的操作视频进行“预训练”,然后只需要极少量的机器人真机数据进行“微调”,即可掌握万事万物。
局限性与未来
尽管 UniT 表现卓越,但在极其精细的任务(如穿针引线)中,这种离散化的 Token 可能仍会损失一定的精度。此外,如何从完全无标注的互联网视频(非第一视角)中提取这种物理语言,是下一个极具诱惑力的挑战。
总结: UniT 证明了,当机器人学会了“用人类的方式理解物理结果”时,通向通用物理 AI 的障碍便少了一大块。