
CROSSMATH:揭开 VLM 的伪推理面纱,深挖視覺与文本间的巨大鸿沟
Do Vision-Language Models Truly Perform Vision Reasoning? A Rigorous Study of the Modality Gap
本文提出了 CROSSMATH,一个用于评估多模态大模型(VLM)视觉推理能力的严谨基准测试。该基准通过构建文本、图像及混合三种模态下的等价数学填字游戏,揭示了当前顶级模型(如 Qwen3.5-Plus)在视觉推理上的巨大瓶颈。
TL;DR
视觉语言模型(VLM)真的在进行“视觉推理”吗?还是只是在利用强大的文本骨干网络进行“偷看”?由南洋理工大学与阿里巴巴团队联合发布的论文通过 CROSSMATH 基准测试给出了令人深思的答案:即便在信息严格等价的情况下,VLM 处理图像逻辑的能力仍远逊于处理纯文本,且图像输入的加入有时甚至会干扰推理。作者提出的基于强化学习的后训练方法,为缩小这一“模态鸿沟”指明了方向。
背景定位:是真知灼见,还是文本偏见?
随着 Llama-3, Qwen2.5 以及 DeepSeek 等大模型的崛起,VLM 在图像描述和简单问答上已接近人类水平。然而,学术界一直存在一个核心质疑:VLM 的逻辑能力究竟是扎根于视觉输入,还是仅仅是将图像“翻译”成文本后,利用预训练阶段习得的语言先验进行猜测?
以往的基准测试(如 MMMU)由于任务中图像和文本高度耦合,很难单独剥离出不同模态的贡献。本文的贡献在于:通过一套自动化的 2D 数学谜题生成系统,确保了图像版和文本版(Markdown Table)包含的信息完全一致,从而实现对模型视觉推理能力的“真空”测试。
痛点深挖:消失的视觉逻辑
作者通过实验发现了一个令人惊讶的现象:“视觉干扰效应”。
- 性能暴跌:当模型只给图像时,表现极差。
- 负面共享:在“图像+文本”的多模态输入下,性能往往比纯文本输入时还要低。
- 认知瓶颈:随着推理步数(Hops)增加,视觉模式下的正确率呈指数级下降,而文本模式则表现出更强的韧性。
这表明,现代 VLM 的视觉模块(Vision Encoder)与语言解码器(Text Decoder)之间并未真正实现逻辑协同。视觉信号在解码器眼里更像是一种“干扰噪声”而非“逻辑养料”。
核心机制:CROSSMATH 如何重塑视觉推理
为了衡量并解决这一问题,作者不仅提出了基准,还提出了一套结构化的后训练(Post-training)方案。
1. 结构化思维链(Structured CoT)
由于小参数模型在处理视觉逻辑时容易陷入死循环,作者先通过 Qwen3-VL-Max 生成高质量的结构化推理轨迹,对模型进行 SFT(监督微调),使其学会如何从视觉网格中按顺序提取算式。
2. 强化学习与可验证奖励(GRPO/RLVR)
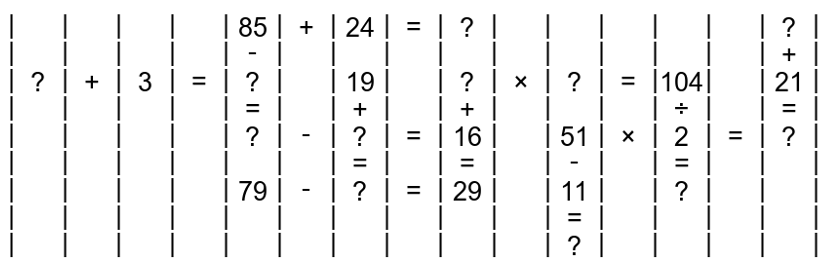 图 1:CROSSMATH 任务示例。模型需在 2D 空间内识别相交的等式并逐一求解。
作者采用了 DeepSeek 提出的 GRPO(Group Relative Policy Optimization) 框架。不同于传统的规则奖励,作者引入了位置权重奖励策略:
- 对需要更多推理步(Hop)才能解出的格子给予更高的权重。
- 这种机制迫使模型在 RL 阶段不仅仅关注简单的 OCR 识别,更要关注逻辑的级联效应。
实验战绩:后训练带来的质变
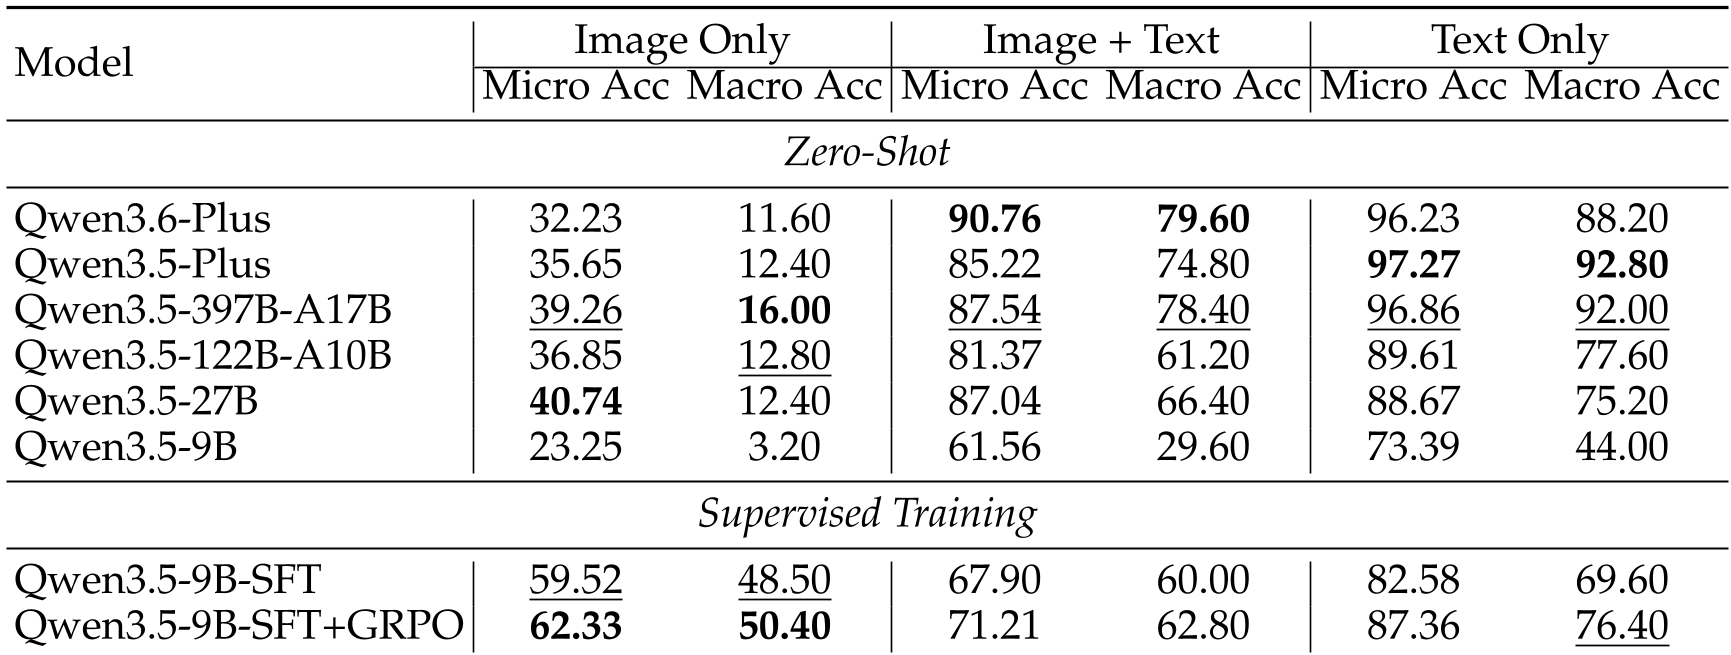 表 1:对比零样本与后训练后的模型表现。
- 性能飞跃:经过 SFT 和 GRPO 的优化,Qwen3.5-9B 在图像模式下的全题正确率(Macro Acc)从 3.20% 飙升至 50.40%。
- 跨领域泛化:虽然训练集全是 CROSSMATH 二维数学题,但该模型在 MathVerse(通用数学)和 MMMU 上也展现了正向收益(分别提升 +2.46% 和 +1.39%)。
- 鲁棒性验证:即使去除网格边框、改变背景颜色或字体,经过训练后的模型依然保持稳定,证明其习得了抽象的逻辑规则,而非简单的视觉模板匹配。
专家视角:深度洞察
- 感知不是罪魁祸首:实验证明模型即便能精准 OCR 出所有数字,依然解不出题。这说明 VLM 的真正短板在于空间拓扑与逻辑操作之间的映射。
- 模型规模的失效:在没有针对性后训练的前提下,单纯增加参数量(如从 9B 到 397B)并不能显著提升 Vision-only 模式的表现。这预示着,“大力出奇迹”在原生视觉推理上可能存在收益边际递减。
- 未来的路:真正的原生多模态模型不应仅仅是“视觉特征投射到文本空间”,而应在特征层就具备处理物理约束和空间逻辑的能力。
总结
CROSSMATH 为我们提供了一个冷峻的现实:目前的 VLM 仍是“文本巨人,视觉矮子”。通过显式的逻辑链训练和强化学习,我们能够部分修复这种不平衡,但要实现真正的视觉逻辑常识,仍需在模型架构层面进行深层变革。