
WebCompass:Web 编程智能体的全生命周期评测新范式
WebCompass: Towards Multimodal Web Coding Evaluation for Code Language Models
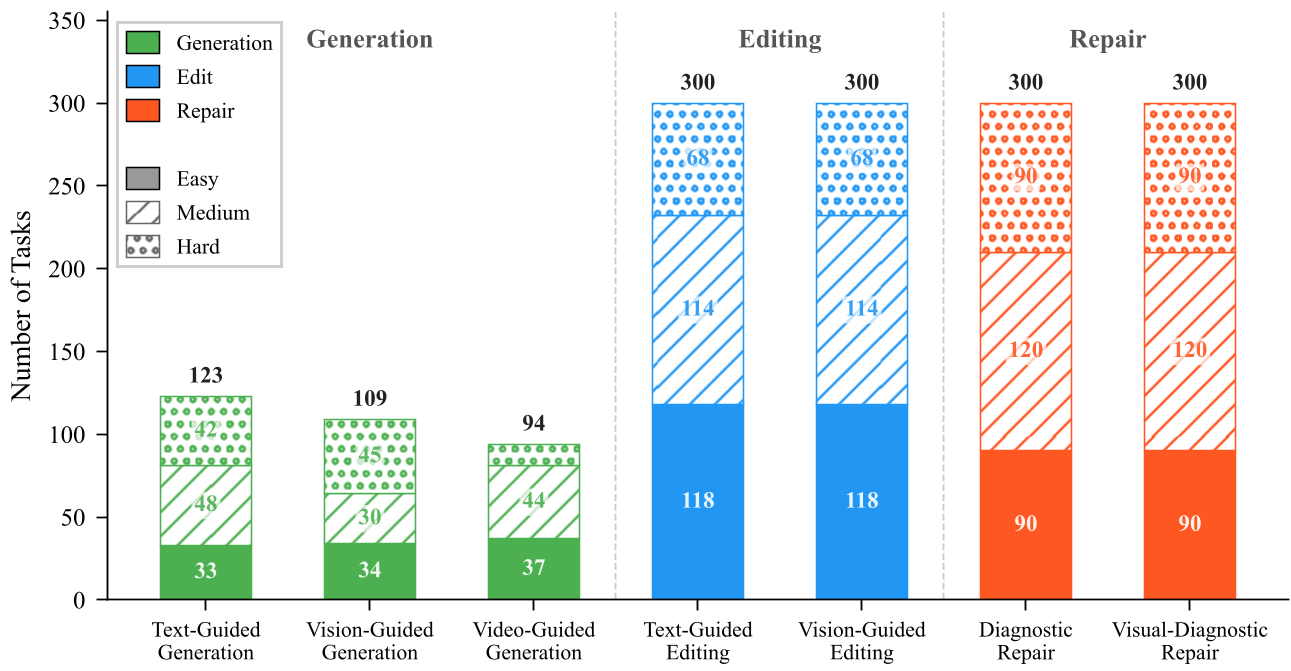
WebCompass 是一个针对多模态 Web 编程能力的综合性评测基准,涵盖了生成(Generation)、编辑(Editing)和修复(Repair)三大核心任务。该工作通过引入 Agent-as-a-Judge 协议,利用自主代理在真实浏览器中执行和测试代码,实现了在文本、图像、视频三种模态下的端到端 Web 工程能力评估,并在多个 SOTA 模型上展现了显著的性能梯度。
TL;DR
WebCompass 是第一个将 生成 (Generation)、编辑 (Editing) 和 修复 (Repair) 统一在 文本/图像/视频 三模态下的 Web 编程基准。它摒弃了传统的静态指标,引入了基于 Agent-as-a-Judge 的动态浏览器交互评测,深刻揭示了当前 LLM 在前端交互逻辑与视觉忠实度上的真实差距。
1. 痛点:为什么传统的 Code Benchmarks 测不准 Web 开发?
在传统的代码评测中,我们习惯于 Pass@k 或单元测试通过率。但 Web 开发是一个“视觉先行”且“过度依赖交互”的领域。一个前端任务的成功不仅在于逻辑正确,更在于:
- Visual Fidelity:生成的 UI 是否符合视觉预期?
- Interaction Quality:按钮点击后的状态流转是否符合直觉?
- Context Awareness:在现有大型代码库中进行 Patch 修复时,是否破坏了原有的样式或逻辑?
现有基准往往只关注静态快照或文本描述,忽略了 Web 开发是一个“生成-编辑-修复”的迭代循环。
2. Methodology:Agent-as-a-Judge 的物理直觉
WebCompass 最具创新的设计在于其评估协议。作者认为,评估一个网站的好坏,最好的方式是**“像测试员一样去用它”**。
2.1 任务分治
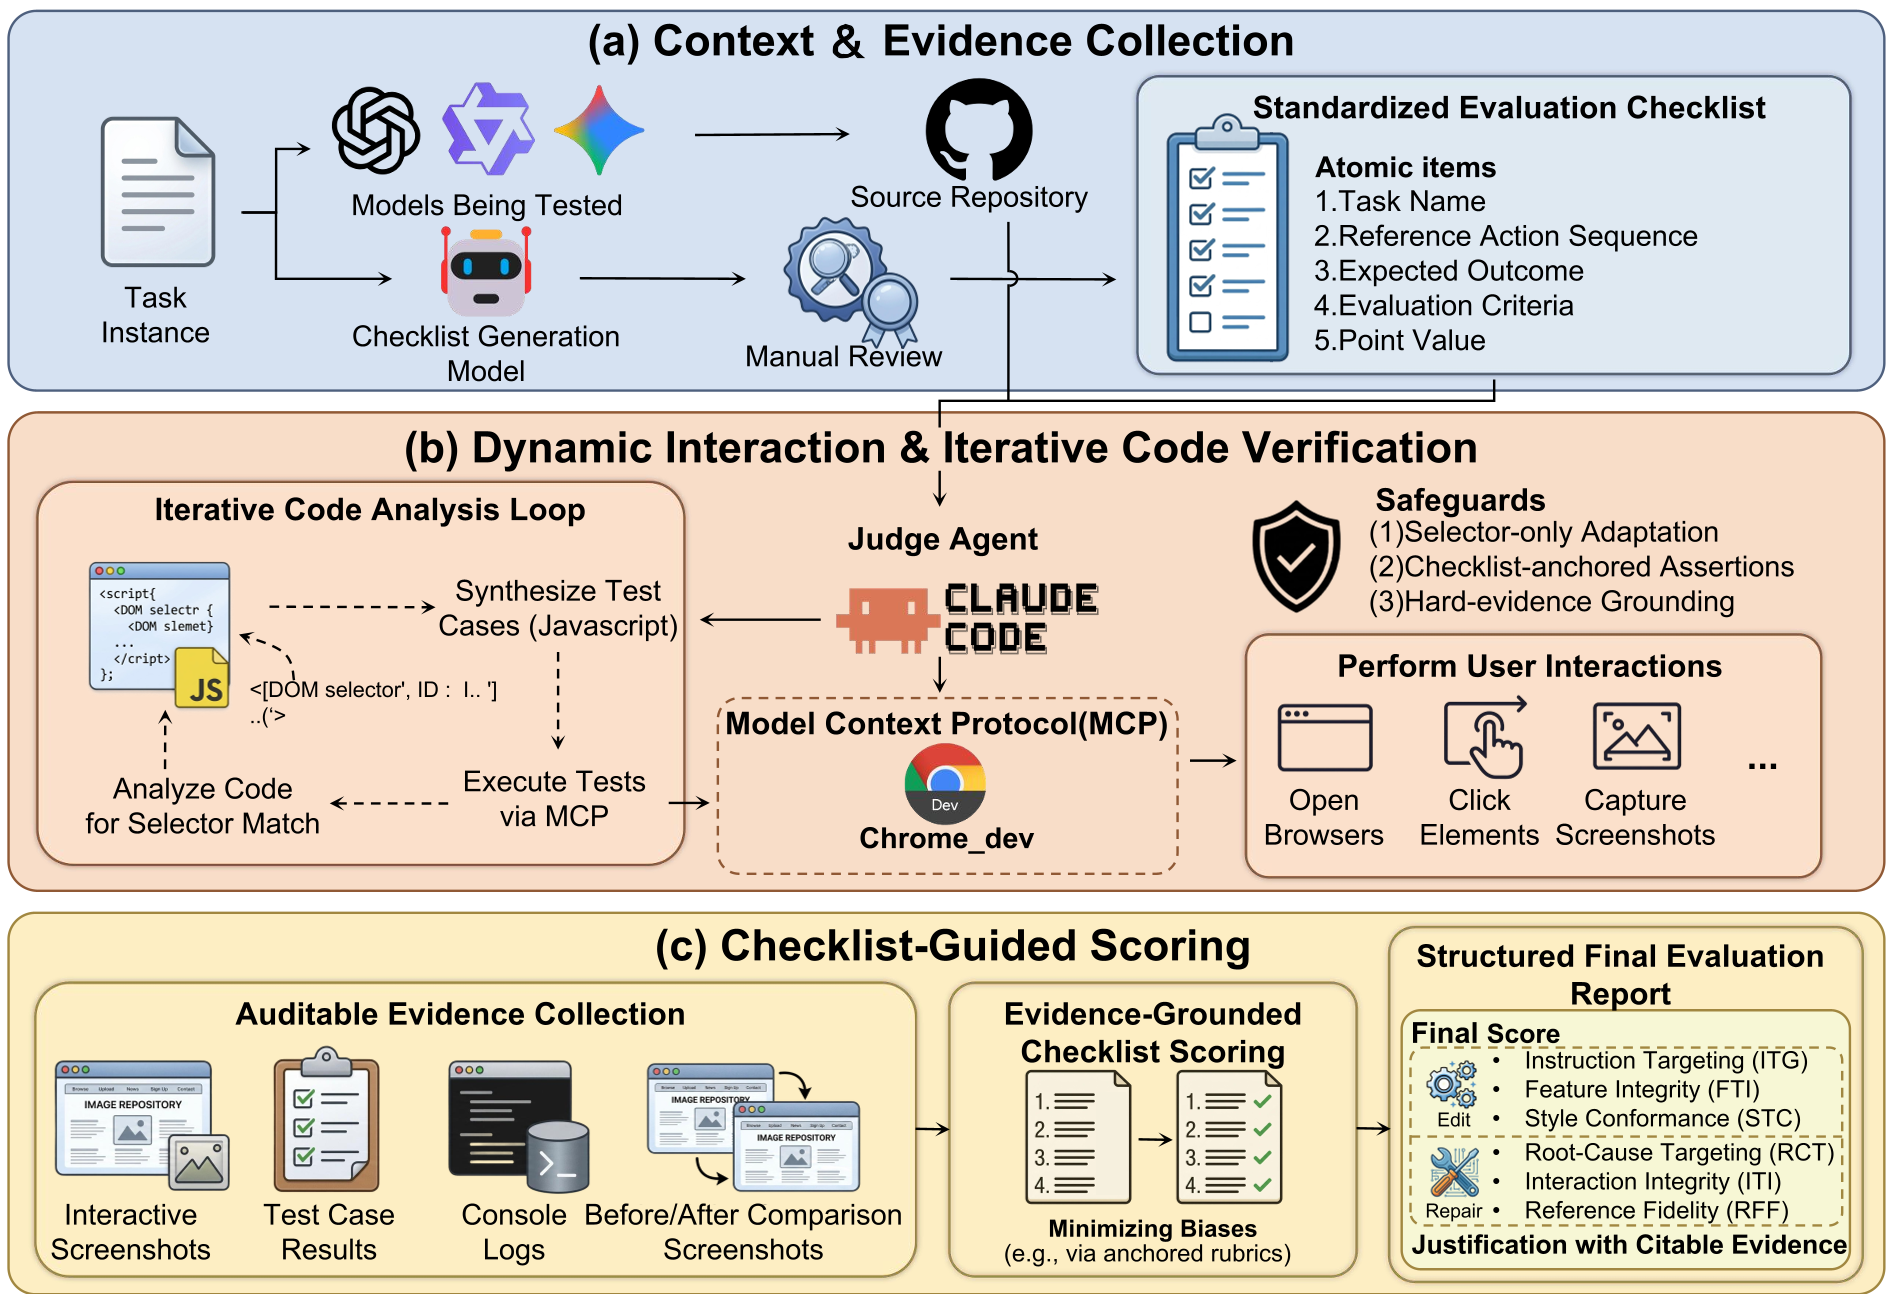
- 对于编辑与修复 (Editing & Repair):因为解空间相对受限(Patch-based),采用 LLM-as-a-Judge。通过对比修复前后的截图、构建日志和代码 Diff 进行评分。
- 对于生成 (Generation):由于是开放式任务,引入 Agent-as-a-Judge。
2.2 核心闭环:MCP 协议与自主探索
评测代理(如 Claude Code)通过 Model Context Protocol (MCP) 与真实浏览器(Chromium)连接:
- 指令解析:根据设计文档自动生成测试 Checklist。
- 模拟交互:在浏览器中执行点击、滚动、输入。
- 动态验证:实时捕获 DOM 快照、控制台报错和视觉截图,作为评分的“硬证据”。
这种方式消除了“幻觉评分”,因为分数必须绑定在可审计的交互记录上。
3. 实验发现:谁才是前端之王?
3.1 闭源与开源的巨大鸿沟
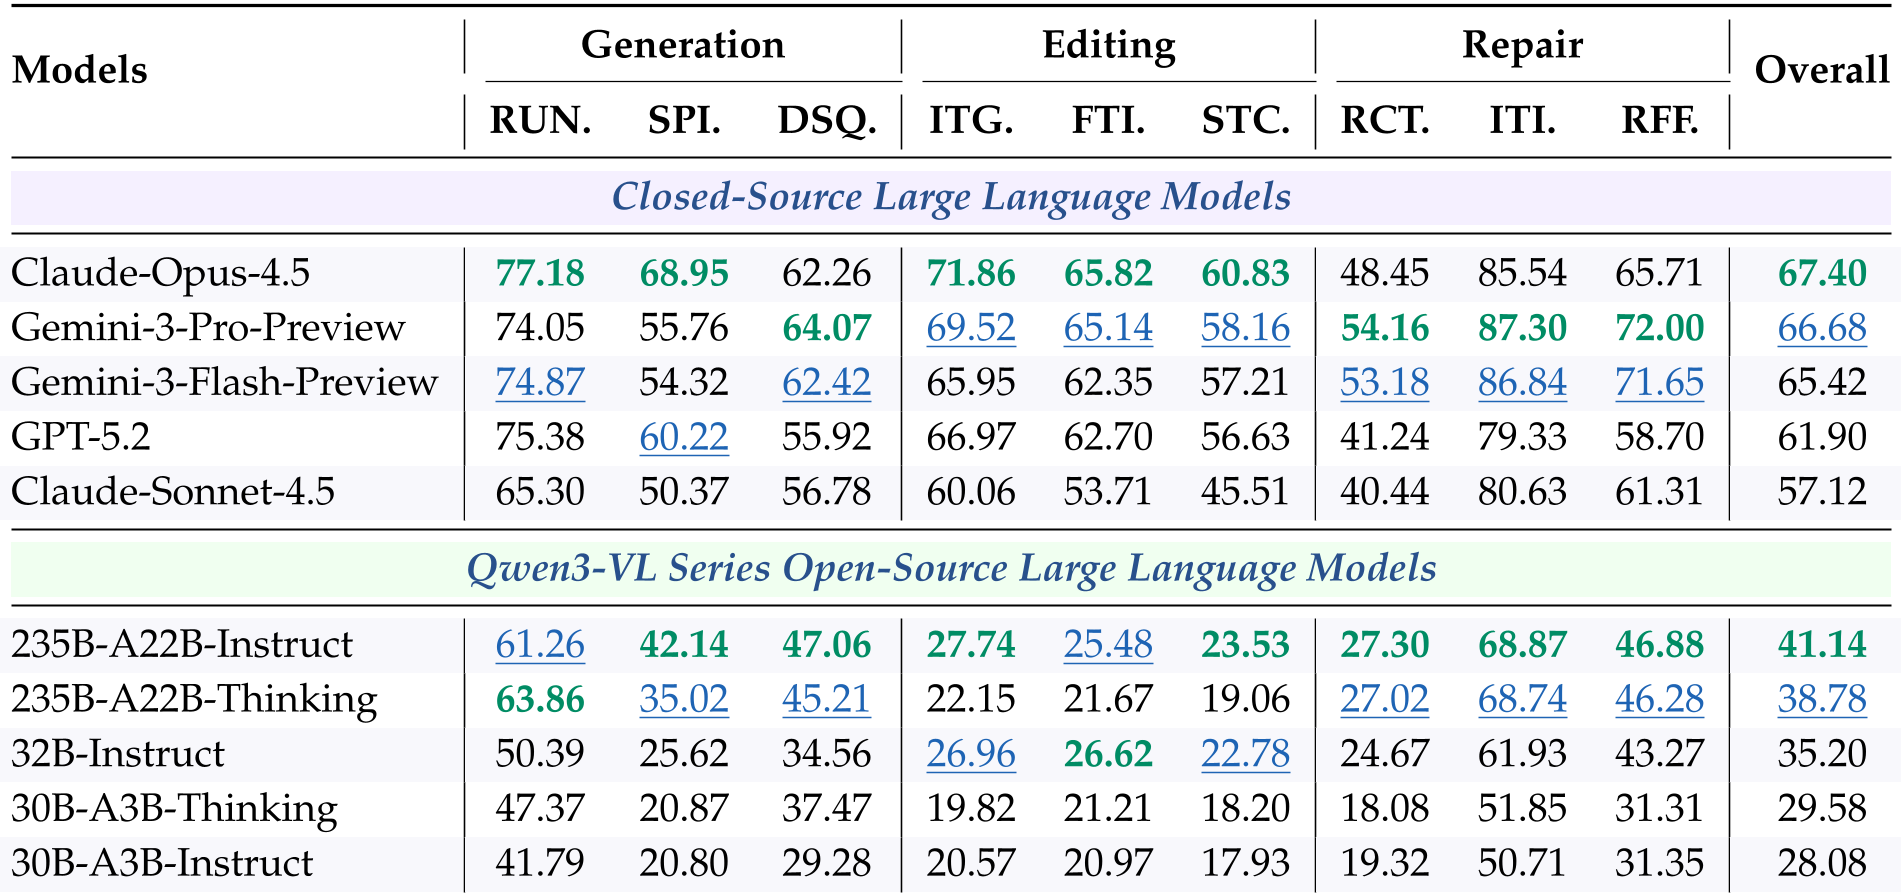
实验对比了包括 GPT-5.2、Claude-Opus-4.5 和 Qwen3-VL 在内的 10 个模型。结果显示,闭源模型(尤其是 Claude 系列)在 Runnability (可执行性) 和 Instruction Targeting (指令对齐) 上展现出绝对统治力,高出开源模型 25 分以上。
3.2 框架的“诅咒”:为什么 Vue 这么难?
一个有趣的发现是,模型在处理 Vanilla JS / HTML 时表现最好,而在 Vue 上表现最差。作者分析指出,Vue 的 Single File Components (SFC) 格式要求模型在同一个文件内同时协调 HTML 模版、JS 逻辑和 Scoped CSS,这种高度耦合的语法结构增加了模型产生跨块不一致性的概率。
3.3 视觉美学:持久的瓶颈
即便在功能性得分较高的模型中,Design Quality (设计质量) 依然是得分最低的维度。这说明目前的模型虽然能写出“能跑”的代码,但在处理间距、颜色和谐度及响应式布局等感官体验上,仍缺乏深刻的审美先验。
4. 深度洞察:复杂性带来的“注意力衰减”
通过对 Qwen3-VL-Thinking 模型的分析,作者发现增加“思考步长”(Chain-of-Thought)在 Web 任务中并不总是有效。长链推理可能导致模型忽略 Prompt 中众多的界面细节要求(Feature Missing),这暗示了在长上下文 Web 开发中,如何在高自由度的推理与严格的指令遵循之间平衡仍是一个未决难题。
5. 总结与启示
WebCompass 的出现标志着代码评测从“片段匹配”向“工程验证”的转型。它告诉我们:
- 交互胜过静态:只有在真实渲染环境中交互,才能发现逻辑死循环。
- 多模态是刚需:视频模态捕获的动态状态切换是 text-only 模型永远的短板。
- 鲁棒性评估:Worst-of-N 的稳定性评估显示,顶级模型在最坏情况下的性能跌落依然严重,LLM 编程的不可预测性仍是规模化落地的核心阻碍。
WebCompass 不仅仅是一个数据集,它为未来构建能够自愈、自测的端到端 Web 编程代理指明了方向。