
XEmbodied:赋予 MLLM 几何灵魂,打造自动驾驶云端标注“超级引擎”
XEmbodied: A Foundation Model with Enhanced Geometric and Physical Cues for Large-Scale Embodied Environments
本文提出了 XEmbodied,一个专为自动驾驶和机器人领域设计的云端具身智能基座模型。该模型通过 3D Adapter (3DA) 和高效具身适配器 (EIEA) 融合了 3D 几何感知与多模态物理线索,在 18 项公开基准测试中达到了 SOTA 性能。
TL;DR
在自动驾驶 3.0 时代,云端数据闭环是规模化智能的核心。然而,由于缺乏 3D 几何直觉和物理场景语义,主流的视觉语言模型(VLMs)常在复杂场景中“翻车”。清华大学与小米机器人团队联合推出的 XEmbodied,通过引入 3D Adapter 和物理信号蒸馏技术,成功让模型具备了内生的空间感。它不仅能看懂交通规则,还能精准感知物体的 3D 坐标与空间占据。
背景定位:为何 2D 的 MLLM 无法胜任具身任务?
现有的 MLLM(如 LLaVA, Qwen-VL)主要在扁平的 2D 互联网图像上训练。你可以问它“图中有什么”,但如果你问“左前方的白车离我还有几米”,它往往会产生幻觉。
这种局限性源于两个断层:
- 维度断层:2D 预训练缺乏对度量距离和 3D 环境拓扑的建模能力。
- 模态断层:点云(Point Clouds)、占用网格(Occupancy Grids)等具身原生信号无法直接塞进文本上下文。
核心方法:构建“内生几何”与“外生物理”的双回路
XEmbodied 的设计灵感来源于人类的空间认知:我们处理语义信息(“那是辆车”)和几何信息(“它离我 5 米远”)是分流且并行的。
1. 3D Adapter (3DA):注入几何基因
不同于简单地堆叠深度图。作者使用了一个预训练的 3D 几何编码器(VGGT)来捕捉空间结构,通过 Cross-Attention 机制,将 3D Token 动态地注入到 2D 语义 Token 流中。这使得模型在处理图像时,每一颗 Token 都带有 3D 空间位置的“注解”。
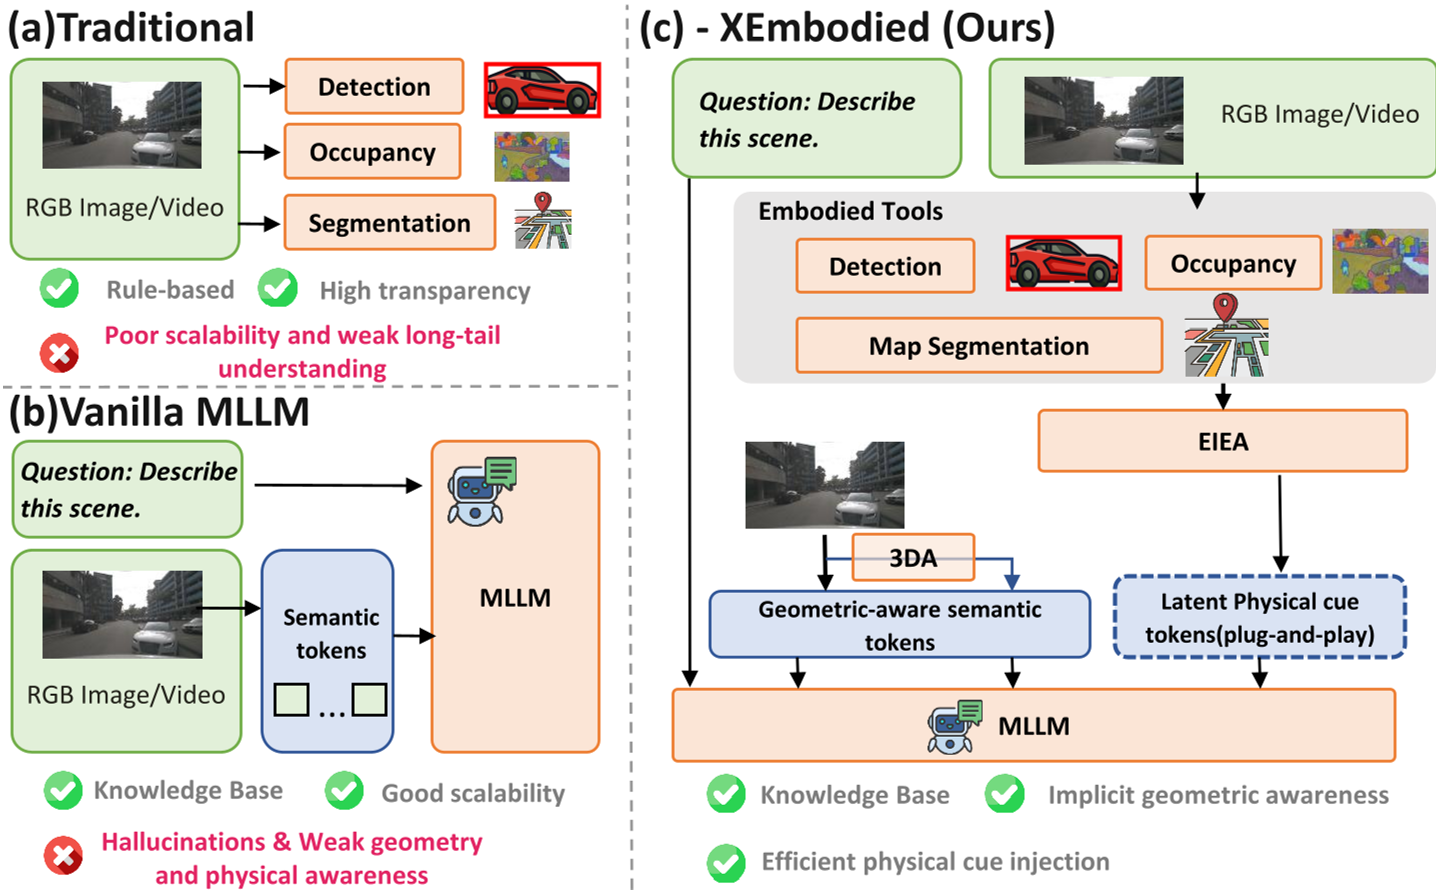 (上图展示了 XEmbodied 如何在具身理解的三大维度上全面超越 GPT-4o 等基座模型)
2. EIEA:物理信号的“压缩机”
为了让 LLM 读懂多模态信号(如地图、运动流),作者引入了 Efficient Image-Embodied Adapter (EIEA)。它的巧妙之处在于:不直接给 LLM 看冗长的传感器数据,而是先用一个轻量级的 Mamba 解释器进行特征提取,再将其蒸馏成紧凑的 Physical Cue Tokens。这种做法在保持信息密度的同时,将推理延迟降低了近 7 倍。
渐进式课程学习:不仅要学得好,还要防遗忘
为了让模型稳健对齐,作者提出了四阶段训练方案:
- S1 领域对齐:先学会交通规则和驾驶术语。
- S2 几何对齐:激活 3DA,建立坐标与语义的联系。
- S3 端到端认知:开始处理多视图和时空推理。
- S4 物理增强:通过强化学习(GRPO)优化,确保模型输出与物理事实高度一致。
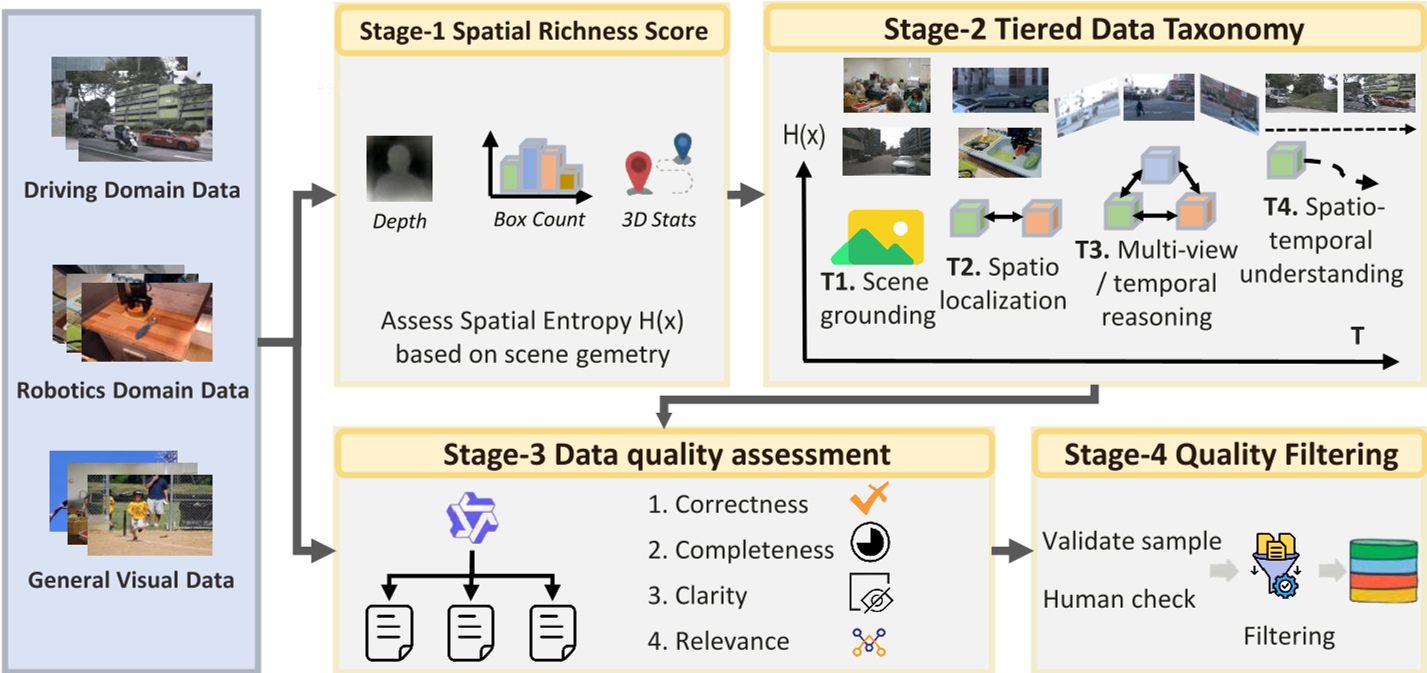 (作者利用空间熵对数据进行分级,确保模型从简单到复杂逐步建立空间感)
实验战绩:全场 Benchmarks 霸榜
XEmbodied 在 18 个具身理解基准上进行了测试,不仅在自动驾驶领域(如 DriveBench)大幅领先,甚至在机器人操纵任务(如 RoboAfford)中也夺得第一。
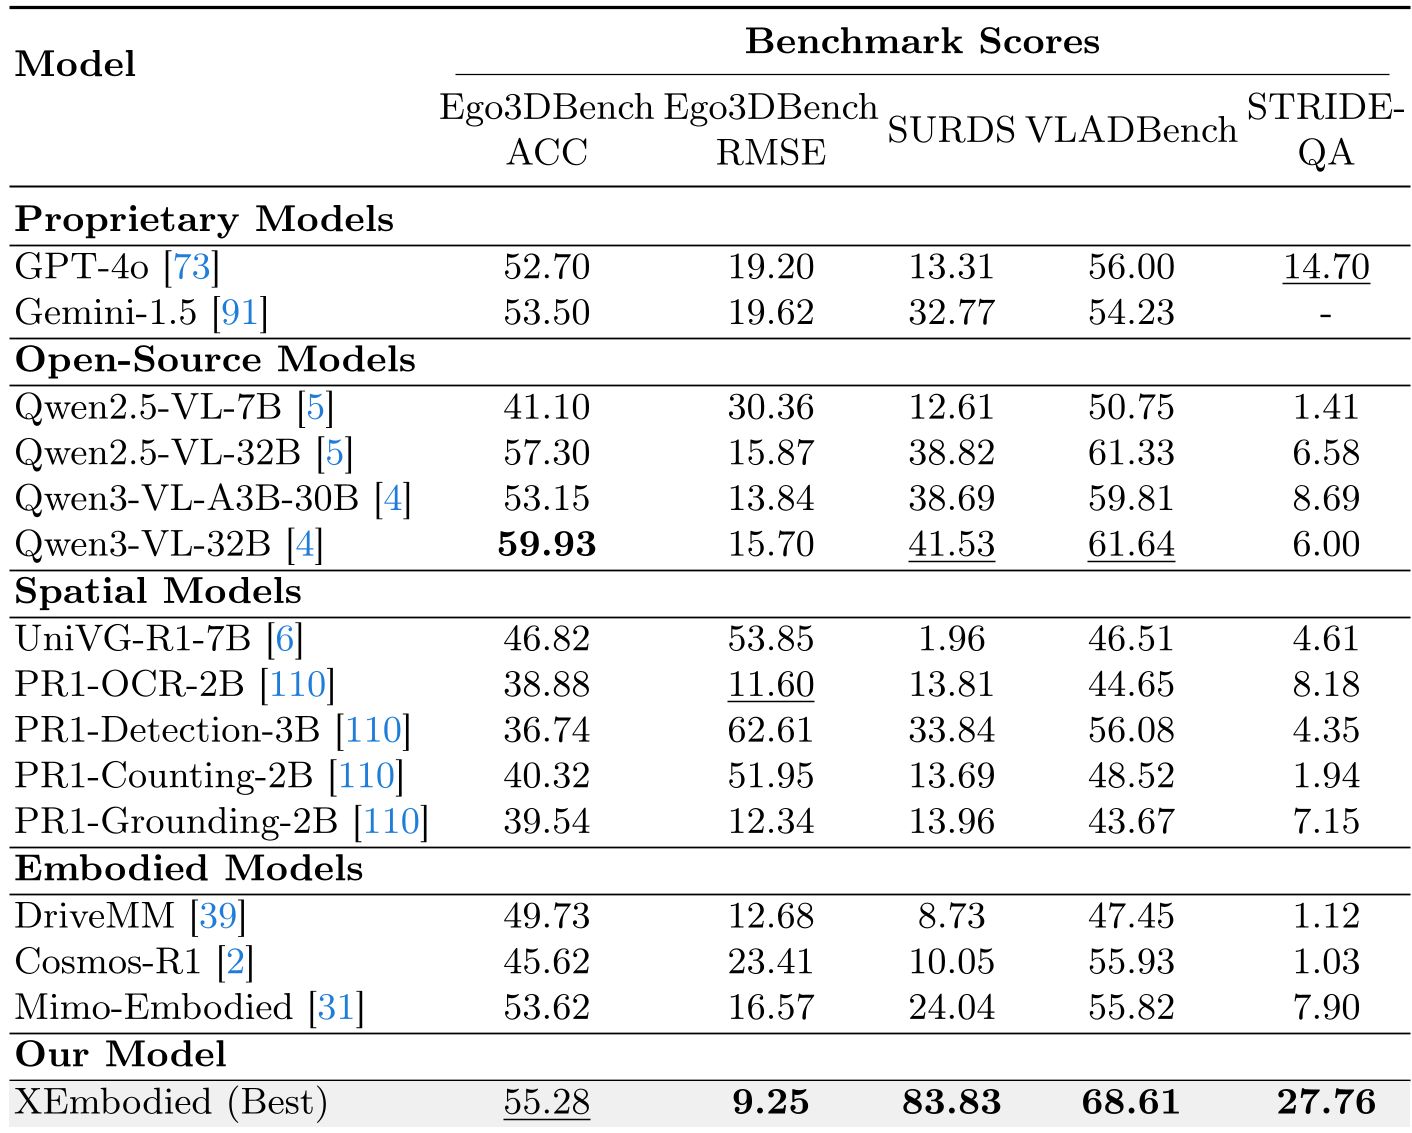 (在 Ego3DBench 上的表现证明,XEmbodied 的深度估计误差 RMSE 远低于其他主流模型)
深度洞察:具身智能的未来在“闭环”
XEmbodied 的真正价值在于它是一个可扩展的标注引擎。在自动驾驶的云端闭环中,它能自动筛选高价值场景(如 Y 型交汇口、学校区域),并生成带有物理约束的精确标注。这直接解决了长尾场景(OOD)难以数据化的问题。
局限性:尽管空间感极强,但模型在超长时序的推理(如预测几十秒后的交通演变)上仍有提升空间。未来的方向将是引入更大规模的强化学习(类似 R1 策略)来提升逻辑链路的深度。
总结
XEmbodied 为多模态模型注入了宝贵的“空间常识”,通过 3DA 和 EIEA 的软硬协同,成功打破了 2D 图像与 3D 具身世界之间的隔阂,为下一代自动驾驶和人形机器人标注系统奠定了坚实的基础。