
苦涩的教训:在大规模计算面前,最好的数据过滤就是“不过滤”
A Bitter Lesson for Data Filtering
本文通过大规模 Scaling Studies 挑战了预训练数据过滤的必要性,提出了 "The Bitter Lesson for Data Filtering"。研究表明,在极高计算量下,直接在原始 Common Crawl (CC) 上训练的模型性能优于任何过滤后的子集。
TL;DR
在 AI 领域,Rich Sutton 的 "The Bitter Lesson" 曾预言:依靠计算的通用方法最终会击败依赖人类知识的特化方法。斯坦福大学的最新研究将这一教训带到了数据领域。实验证明,随着模型参数和训练步数的增加,原始的、充满噪声的 Common Crawl 数据最终会全面超越精心过滤的高质量子集(如 RefinedWeb 或 DCLM)。
背景定位:这是一篇极具颠覆性的论文,它挑战了当前大模型社区“数据质量高于一切”的教条,预示着数据清洗可能正走向与特徵工程相同的终局:被原始算力与数据规模取代。
1. 痛点深挖:过滤真的万能吗?
目前 LLM 的标准流程是:从海量数据中“去粗取精”。例如,DCLM-Baseline 为了保证质量,过滤掉了 99% 的原始数据。这导致了两个核心矛盾:
- 数据饥渴:Chinchilla 最优定律要求数据随参数同步增长,过度过滤可能导致数据量不足以支撑更大规模模型的充分训练。
- 过滤器的局限:目前的过滤器大多基于启发式规则或小型分类器,它们在小规模实验中表现良好,但在超大规模计算下,这些“人类认为的好数据”是否限制了模型的上限?
2. 核心实验:当 CC Pool 遇上 Scaling
作者将原始 CC (Pool) 与五种主流过滤器(RefinedWeb, DCLM 等)在不同算力水平下进行了 PK。
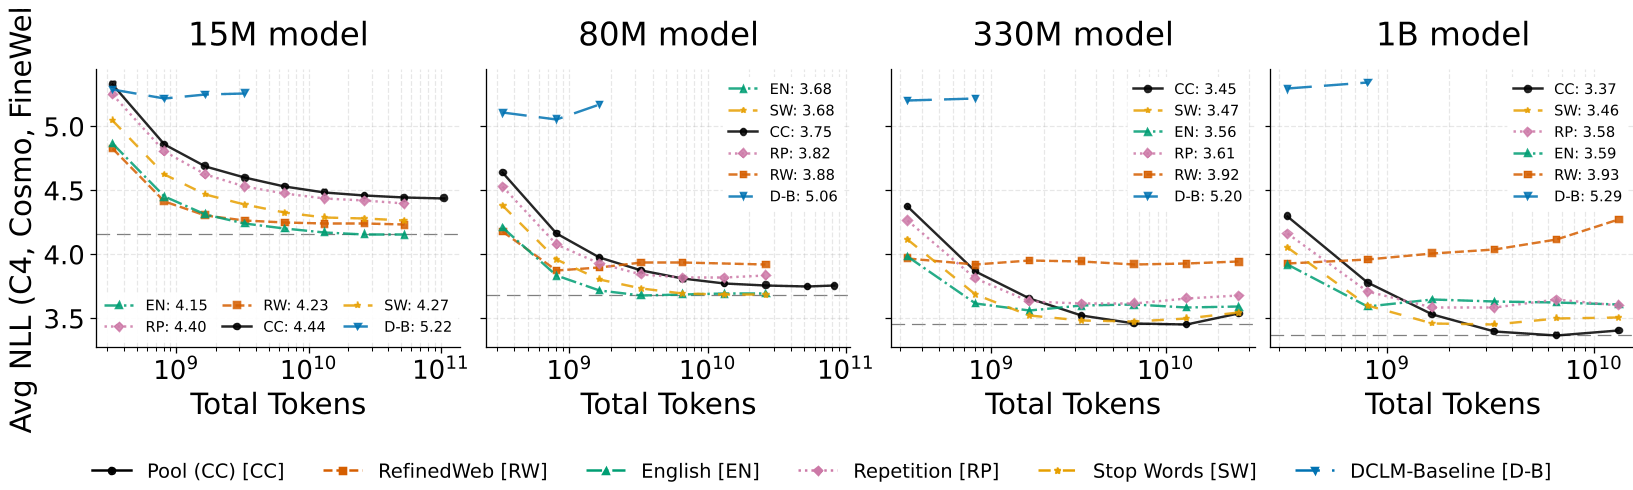 图 1:在足量计算(x 轴:训练步数)下,黑色的 Unfiltered Pool 最终反超了所有带颜色的过滤策略。
关键洞察:
- 门槛效应:对于 15M 的小模型,过滤确实有效;但对于 330M 及以上的模型,只要训练时间够长,不过滤的效果更好。
- 算力填平噪声:大模型展现出了惊人的“抗噪性”,它们能从人类眼中的“垃圾”中提取出统计意义上的有用信号。
3. 疯狂的鲁棒性:注入 800% 的垃圾数据
为了探究模型到底多能“吃脏话”,作者尝试注入了:
- 随机字符串(完全无意义)。
- 打乱语序的文档(仅保留了字频分布)。
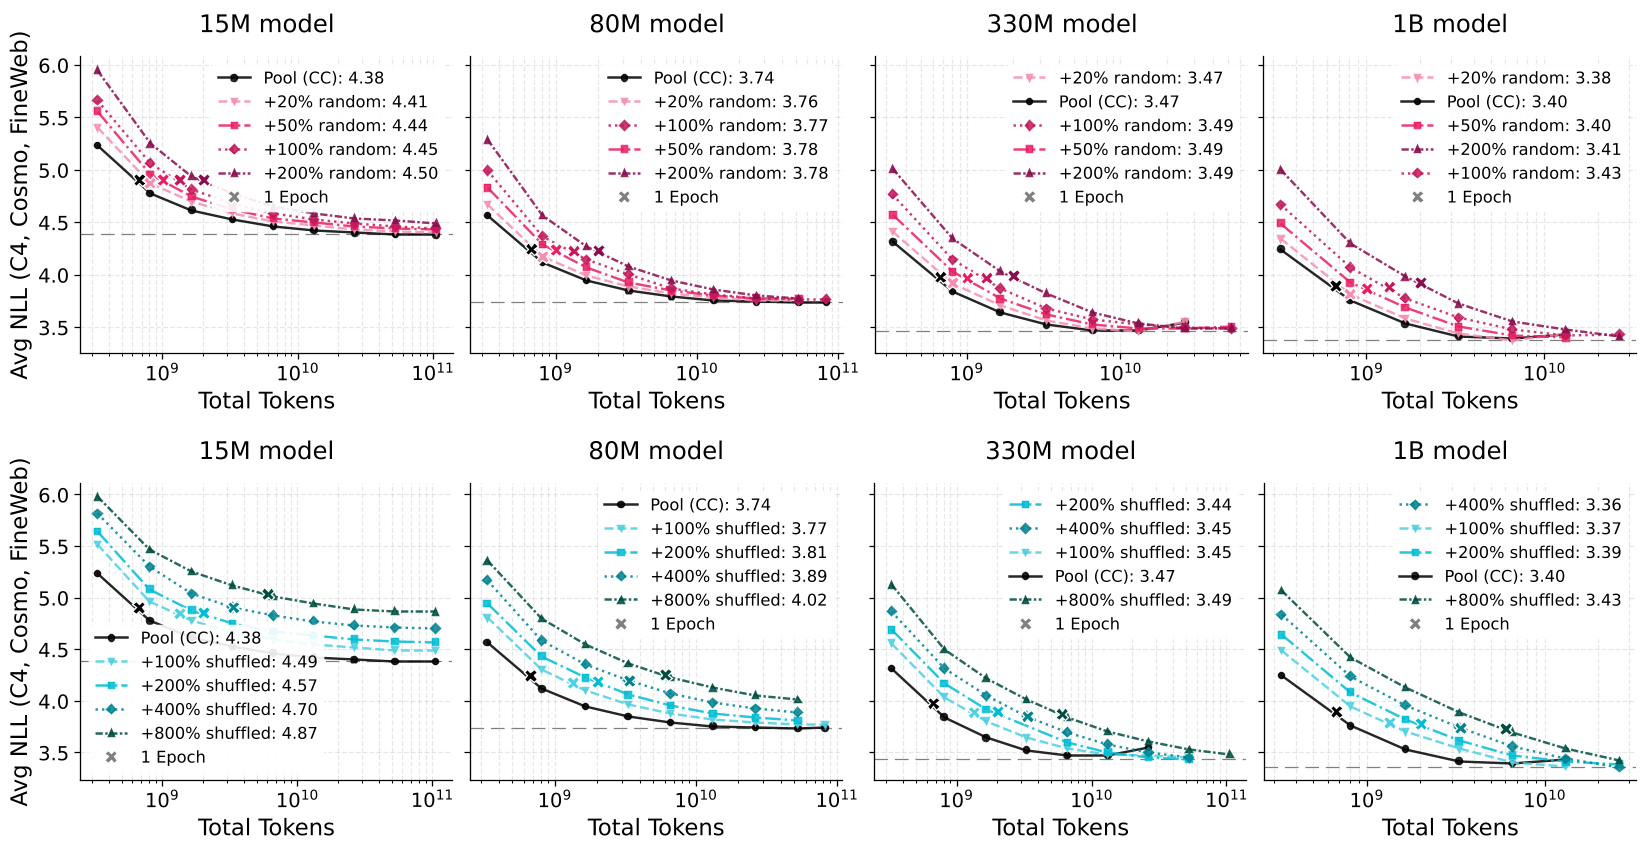 图 2:令人惊讶的是,即使是打乱语序的数据(+800% Shuffled),只要模型足够大且训练足够久,依然能带来性能提升。这说明大模型甚至能从单纯的 Unigram 统计中获益。
4. 理论直觉:为什么不过滤会赢?
作者在论文中提出了一个基于低秩矩阵分解的物理直觉:
- 当模型容量(秩 )足够大时,它可以将“坏数据”分配到不干扰“好数据”的正交分量空间中。
- 而小模型因为容量有限,坏数据会造成严重的干扰(Interference)。
- 结论:参数规模本身就是最好的“动态过滤器”。
5. 预测未来:1e+30 FLOPs 的终局
通过对实验数据的拟合,作者给出了一个计算 Scaling Law:
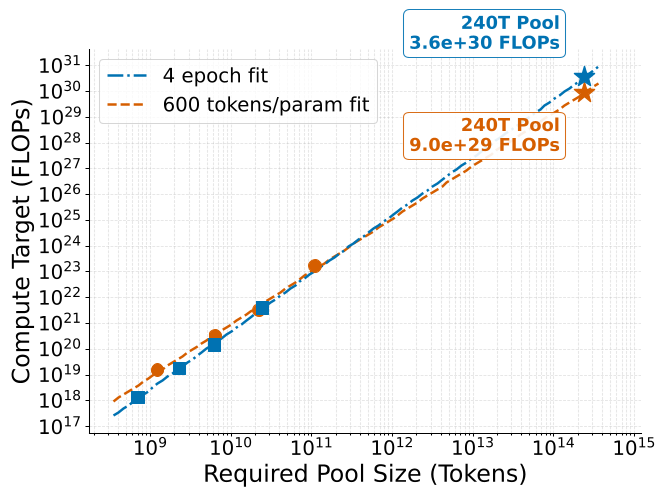 图 3:随着计算量达到 1e30 FLOPs,使用全量 240T token 的 Common Crawl 将成为最优解。
这个算力水平虽然远高于目前的 frontier 模型(如 GPT-4 约在 1e25-26),但按照目前算力增长趋势,2030 年之前我们就能迎来数据过滤“消亡”的时刻。
6. 总结与启示
- Takeaway:数据过滤并非长久之计,在大规模计算时代,我们应该更多地思考如何让模型在“脏数据”中学习,而非耗费巨资构建不完美的过滤器。
- 局限性:虽然在 Perplexity(困惑度)上全量数据占优,但在事实性(Factuality)方面可能存在隐患。如果你训练的是一个需要精确回答事实的 LLM,低频率的错误信息仍是潜在的威胁。
- 未来展望:也许未来的数据工程将从“挑选数据”转变为“设计学习算法”,让模型具备更强的自动抗噪能力。
资深主编点评:本研究最深刻的意义在于,它揭示了数据质量是一个相对概念——它不仅取决于数据本身,更取决于你投入了多少算力去消化它。