
EURUS:重塑开源模型推理能力的“偏好树”对齐技术
Advancing LLM Reasoning Generalists with Preference Trees
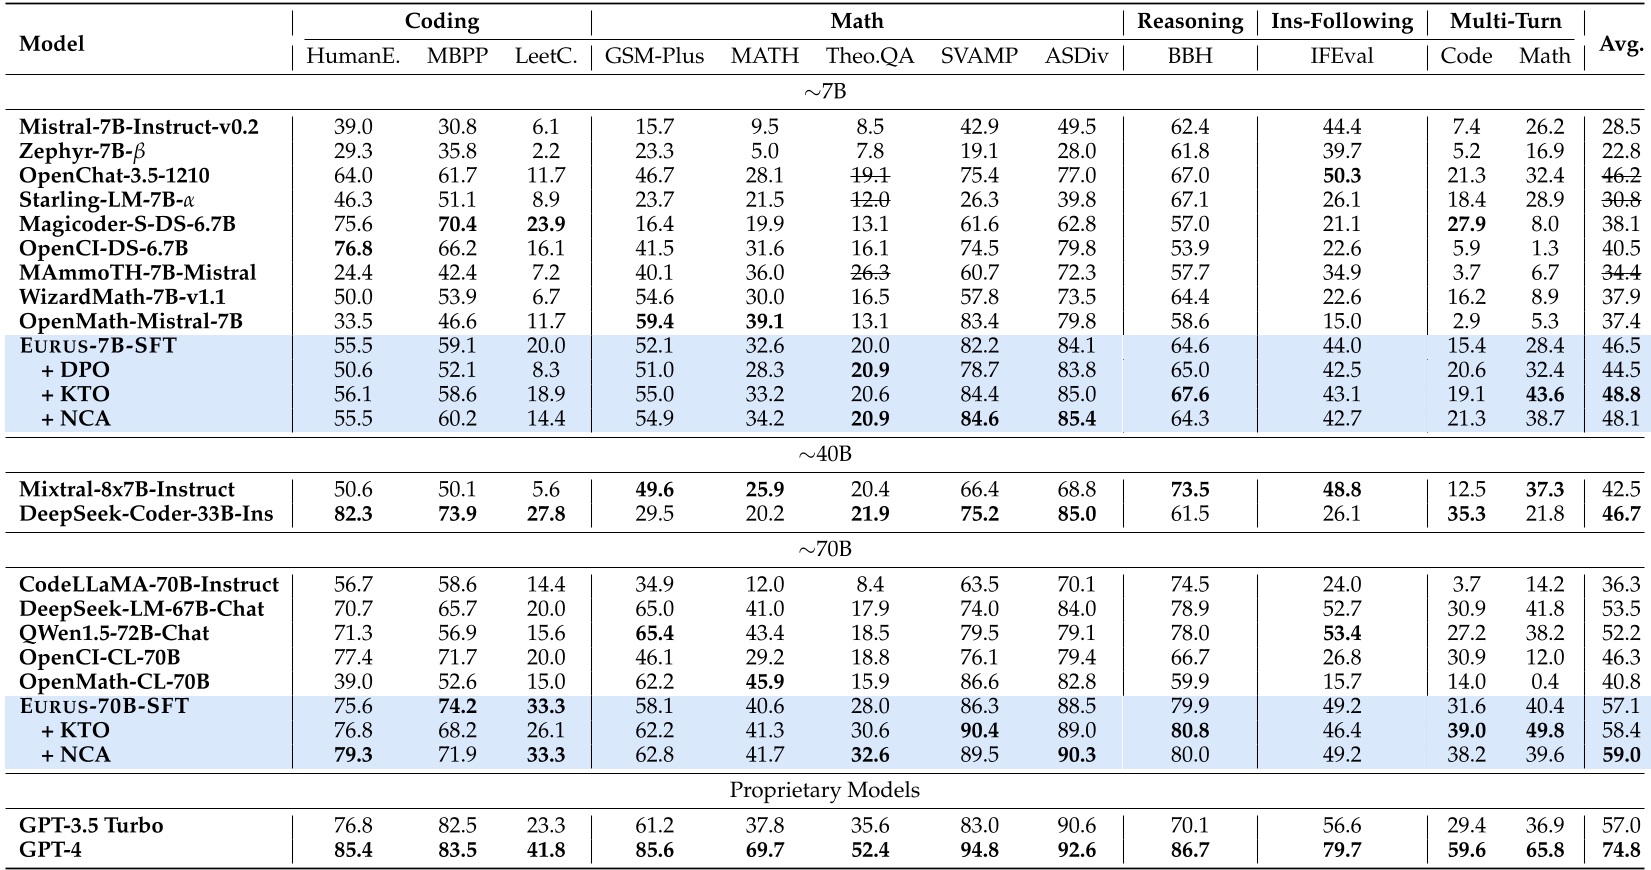
本文推出了 EURUS 系列模型(基于 Mistral-7B 和 CodeLlama-70B 优化),这是一组专注于复杂推理任务的长文本语言模型。EURUS-70B 在涵盖数学、编程和逻辑推理的 12 项基准测试中超越了 GPT-3.5 Turbo,并在 LeetCode (33.3% pass@1) 和 TheoremQA (32.6%) 等极具挑战性的任务上刷新了开源模型的 SOTA 纪录。
TL;DR
在大型语言模型 (LLM) 的竞技场中,复杂推理(Reasoning)一直是区分“业余玩家”与“顶尖选手”的分水岭。清华大学等团队近日发布的 EURUS 系列模型,通过一种全新的数据集结构 ULTRAINTERACT 和偏好学习策略,成功在推理能力上让开源模型与 GPT-3.5 Turbo 掰起了手腕。EURUS-70B 在 LeetCode 等竞赛级编程测试中,比之前的 SOTA 开源模型提升了惊人的 13.3%。
背景定位
目前大多数开源模型的对齐(Alignment)主要集中在对话的流畅度和价值观的匹配上,而在需要缜密规划、工具调用和自我纠错的推理任务(数学、代码、逻辑)中,开源阵营一直缺乏一个系统性的对齐范式。EURUS 的出现,不仅提供了模型,更关键的是贡献了一套处理推理任务的“数据哲学”——偏好树 (Preference Trees)。
痛点深挖:为何 DPO 在推理面前失效了?
在通用的偏好对齐(如 Chat)中,人们习惯使用 DPO(直接偏好优化)。但在 EURUS 的研究中,作者发现 DPO 在推理任务上竟然出现了性能负增长。
- 原因分析:DPO 仅优化选中的答案(Chosen)和排斥的答案(Rejected)之间的相对差值。
- 推理的特殊性:推理任务拥有客观的正确答案。在训练过程中,如果正确解的绝对奖励值(Absolute Reward)不断下降(即便相对差值在扩大),模型仍然无法学到稳健的推理逻辑。这种“奖励漂移”现象在推理任务中是致命的。
核心武器:ULTRAINTERACT 与偏好树
为了解决数据质量和交互缺失的问题,作者构建了 ULTRAINTERACT 数据集。它不再是简单的“指令-回复”对,而是一棵繁茂的树:
- 多样化规划:它不仅包含思维链 (CoT),还包含模块化编程等多种解决问题的策略。
- 环境交互:模型产生的代码会进入 Python 解释器执行,拿回真实的运行结果(Observation)。
- 批判与纠正:引入 GPT-4 作为“批判者”,对错误的中间步骤给出具体反馈,引导模型在树的分支上进行修正。
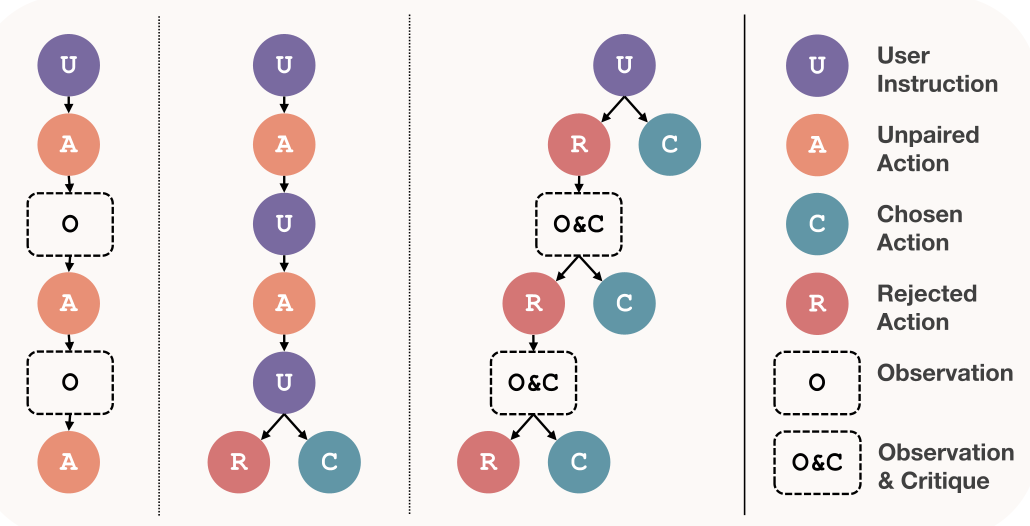 上图展示了 ULTRAINTERACT 与传统对话数据的区别:它不仅有对错之分,更有从错到对的演化路径。
实验战绩:开源推理的新高度
EURUS 展示了极强的跨领域泛化能力(OOD)。
- 顶峰对决:在 LeetCode Contest 和 TheoremQA 上,EURUS-70B 是唯一一个能与 GPT-3.5 Turbo 站在同一梯队的开源选手。
- 小模型奇迹:EURUS-7B 的推理表现甚至可以横扫比它大 5 倍以上的非推理优化模型。
深度洞察:奖励建模的新公式
为了修正 DPO 的缺陷,作者在奖励模型(RM)的训练中引入了额外的损失项 。这个公式不再仅仅关注“赢过对手”,而是强迫模型给正确路径打高分,给错误路径打低分。通过这种方式,EURUS-RM-7B 在 RewardBench 的推理子项上甚至击败了 GPT-4。
总结与展望
EURUS 的成功告诉我们:推理能力的对齐,本质上是让模型学会在失败中寻找逻辑。 通过 ULTRAINTERACT 记录下的那些“错误-反馈-修正”的路径,比单纯灌输正确答案要有价值得多。
局限性: 虽然 EURUS 在推理上表现卓越,但由于其基座模型 CodeLlama 在知识通用性上的限制,其在百科知识类任务(如 MMLU 部分分项)中仍有提升空间。
未来的研究方向或许在于,如何将这种高度结构化的偏好树对齐技术,无损地迁移到更全能的多模态基座模型中。