
ChatRetriever:适配大模型实现鲁棒的对话密集检索
Chatretriever: Adapting large language models for generalized and robust conversational dense retrieval
本文提出了 ChatRetriever,一种将大语言模型(LLM)适配为通用且鲁棒的多轮对话密集检索器的方法。通过结合对比学习与会话掩码指令微调(CSIT),ChatRetriever 在多个基准测试中达到了 SOTA 性能,甚至媲美基于重写的复杂检索方案。
TL;DR
对话式搜索的核心挑战在于理解多轮交互中模糊、省略且复杂的意图。来自中国人民大学等机构的研究者提出了 ChatRetriever,这是一种通过 Contrastive Session-Masked Instruction Tuning (CSIT) 将 LLM(如 Qwen-7B)转化为对话检索器的新架构。它不仅在五个基准测试中打破了性能天花板,还展现出极强的抗干扰鲁棒性。
1. 痛点:为什么对话检索这么难?
传统的 ad-hoc 搜索(如 Google 搜索)通常只需处理单条 query。但在对话场景下,用户的意图往往隐藏在多轮对话的上下文(Context)中。
目前主流的解决策略是 “查询重写” (Query Rewriting):先用模型将会话转化为一个独立完整的查询词,再进行搜索。这种方法效果虽好,但面临两大死穴:
- 高延迟:多了一步生成过程。
- 非端到端:重写模型的目标是“语义通顺”,而不是“利于检索”,导致步调不一致。
而现有的密集检索 (CDR) 模型(如基于 BERT 的模型)在处理长文本和复杂意图时表现羸弱。那么,能否直接让 LLM 学习如何将会话“编码”成向量?
2. 核心机制:CSIT 与会话掩码
为了让 LLM 从“生成者”成功转型为“表征者”,作者提出了 CSIT 方法,包含两个核心逻辑:
架构解析
作者在会话(Session)和回复(Response)末尾都加入了 个特殊的特殊 token(名为 [EMB])。模型最终提取最后一个 [EMB] 的向量作为整个会话的密集表示。
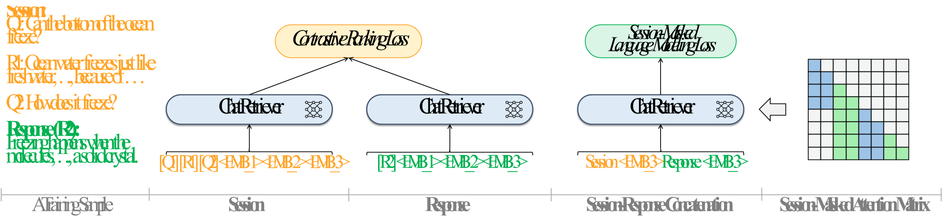
会话掩码指令微调 (SIT)
这是本文的上帝视角。通常的指令微调是根据 Prompt 生成 Response。作者在这里玩了一个“魔术”:在计算生成 Response 的损失时,通过自定义的 Attention Mask,把输入中的原始会话文本全遮掉,只让模型看那几个 [EMB] 向量。
物理直觉: 既然模型只能看着 [EMB] 来还原 Response,那么它必须被迫把会话的所有核心语义全部压缩进这几个向量中。这极大地强化了向量的表征密度。
3. 实验结果:绝对实力的碾压
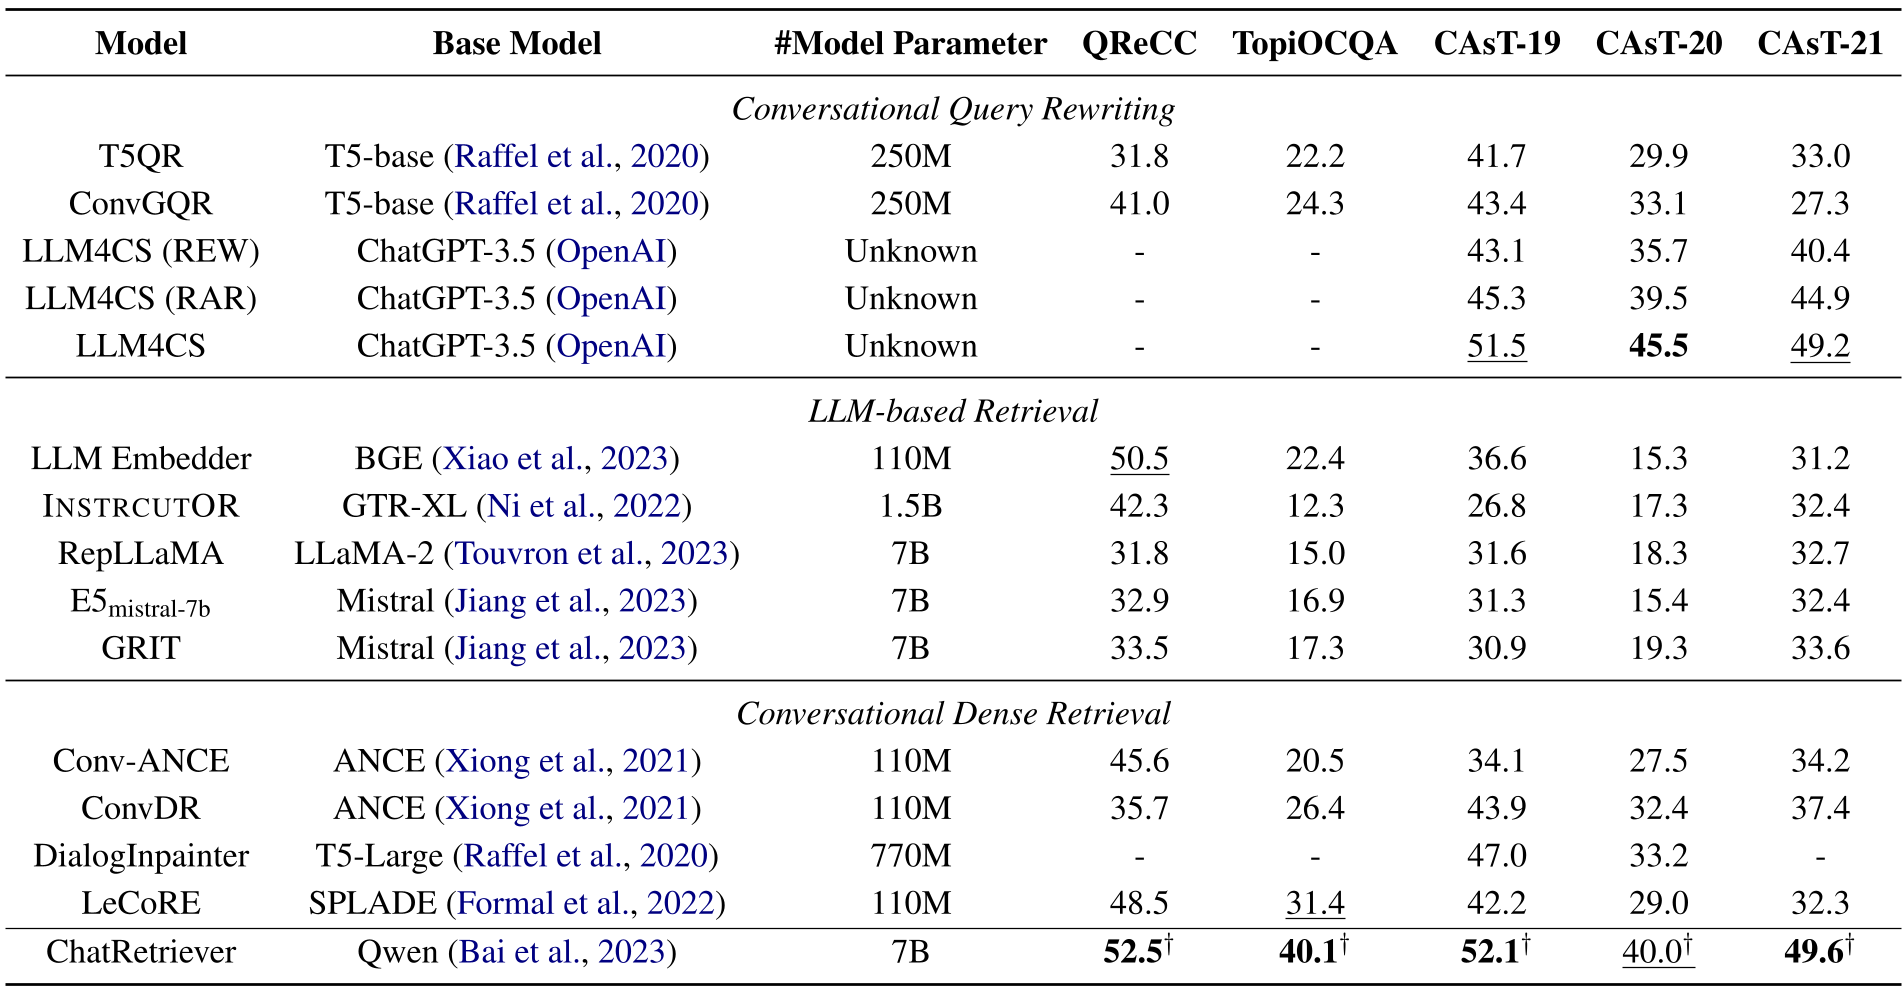
ChatRetriever 在 QReCC, TopiOCQA 以及 TREC CAsT 全系列数据集上进行了验证。
SOTA 对比
如下表所示,ChatRetriever 在大部分数据集上显著优于此前的 CDR 基线(如 ConvDR、LeCoRE)。最令人震惊的是,它在 CAsT-21 上达到了 49.6 的 NDCG@3,不仅远超 110M 参数的小模型,甚至击败了基于 GPT-3.5 的复杂重写框架。
强悍的鲁棒性
为了验证模型是否真的理解了意图,而不仅仅是记住了固定套路,作者设计了“干扰测试”(修改背景上下文)。结果显示,ChatRetriever 的性能波动(标准差 SD)极小,远比之前的 CDR 方法稳定。
4. 深度洞察:为什么有效?
- 表征思维链 (R-CoT):作者发现增加特殊 [EMB] token 的数量(在达到 3 个前)能显著提升效果。这就像是给向量表征提供了一个缓冲区,让模型有更多“空间”去折叠复杂的上下文。
- 数据混合的力量:实验发现,单纯用对话数据训练是不够的。将通用的 UltraChat(对话数据)与 MSMARCO(强搜索相关数据)结合,才能激发驱动 LLM 成为“通用检索器”的潜能。
5. 局限性与未来
尽管 ChatRetriever 表现极其强悍,但作为 7B 模型,其检索时的响应速度和索引占用的存储空间(维度通常为 4096)远高于传统小模型。
总结 (Takeaway):ChatRetriever 的出现标志着端到端对话检索进入了 LLM 时代。它证明了:不需要繁琐的重写步骤,只要微调得当,LLM 本身就是最优秀的对话特征提取器。
未来的研究方向将聚焦于通过知识蒸馏(Distillation)将 ChatRetriever 的能力下放到更轻量级的模型中。