
随机森林+多组学:攻克子痫前期早期预测的“黑盒”
Early prediction of preeclampsia from clinical, multi-omics and laboratory data using random forest model
本文开发了基于随机森林(Random Forest)的子痫前期(Preeclampsia, PE)早期预测模型。通过整合临床数据、血质谱多组学(蛋白质组与代谢组)以及实验室常规指标,实现了在妊娠 16 周前对早发型(EPE)和晚发型(LPE)子痫前期的精准区分,其中 EPE 预测敏感性达 87.5%,特异性达 94.1%。
TL;DR
子痫前期(Preeclampsia, PE)是孕产妇死亡的主要原因之一。本研究通过对 198 名受试者的血浆进行蛋白质组学和代谢组学深度扫描,利用**随机森林(Random Forest)**算法构建了集成预测模型。结果显示,通过整合临床风险因子与分子标志物,我们能在妊娠 16 周前以极高的特异性预测子痫前期的发生,尤其是针对危害更大的早发型子痫前期(EPE)。
背景定位:为何早期预测如此困难?
子痫前期并非单一疾病,而是一种异质性极强的多系统综合征。传统临床筛查依赖于母亲病史、平均动脉压(MAP)以及阿司匹林预防指征。然而,现有模型在亚洲人群中的表现往往不尽如人意(检出率通常仅为 50%-70%)。
作者认为,现有的缺陷在于:
- 维度缺失:忽视了反映肝肾早期损伤的常规实验室指标。
- 机制差异:早发型(EPE)多与胎盘植入异常有关,而晚发型(LPE)则更偏向母体代谢综合征。
核心方法论:多维数据融合
研究团队通过多中心采样,构建了一个包含蛋白质、代谢物、临床变量和实验室参数的高维数据集。
1. 特征筛选的利器:Boruta 算法
为了从数百个组学特征中提取真正具有生物学意义的指标,研究采用了 Boruta 算法。这是一种基于随机森林的特征选择方法,通过创建对照“影子特征”来剔除随机噪声,确保入选的指标(如 TNC, VASN, SOD3 等)具有显著的预测贡献。
2. 模型架构
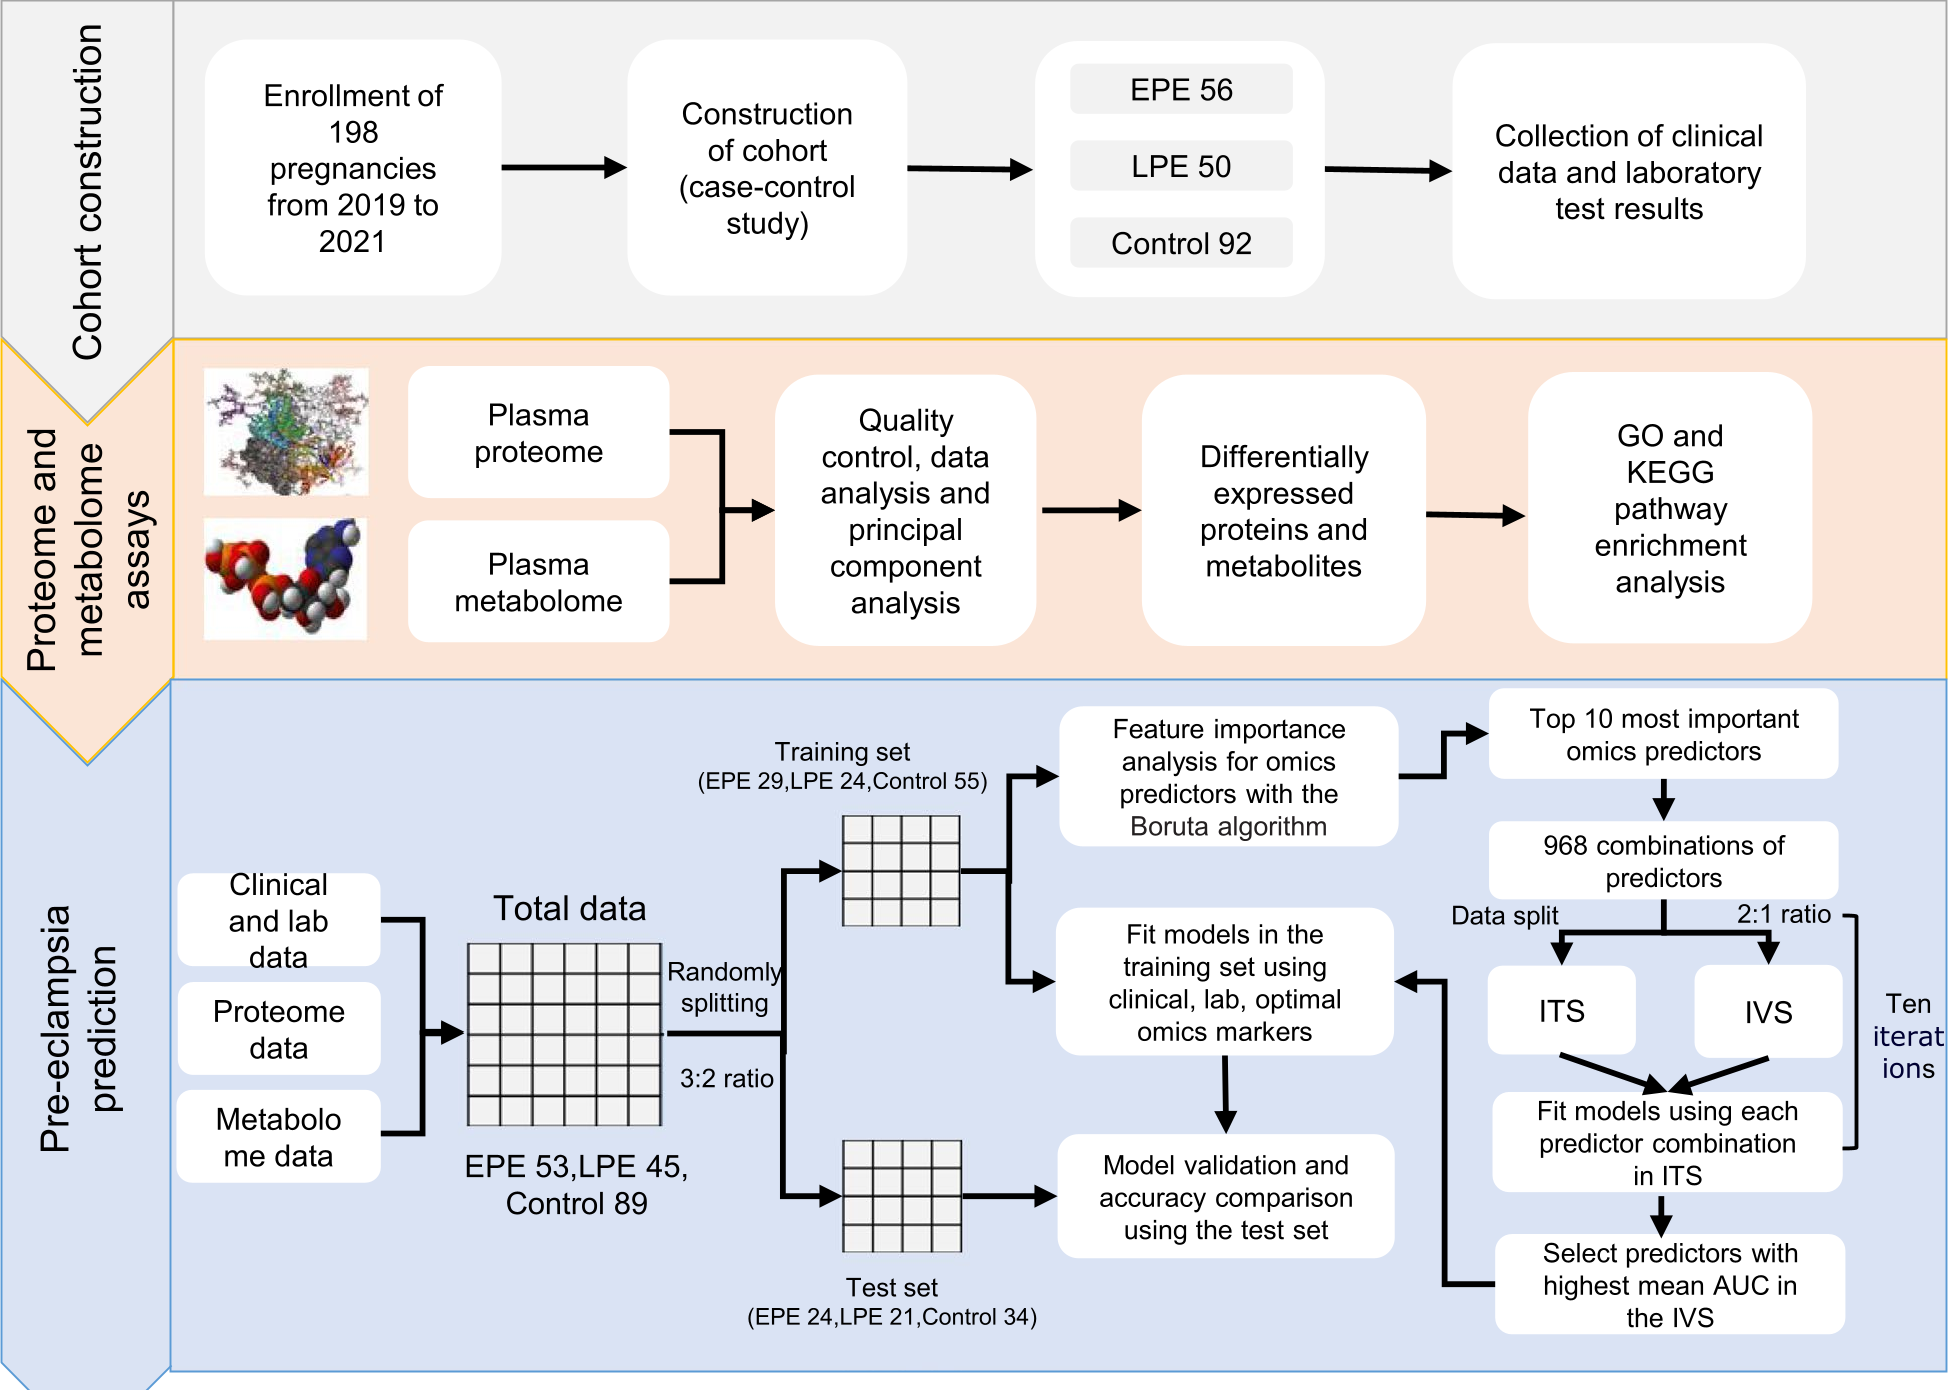 图 1:从样本收集、多组学检测到随机森林模型构建的完整工作流。
实验战绩:多维胜过单一
实验的核心发现在于:协同效应。 单独使用临床因子预测 EPE 时效果平平,但当加入 2-Hydroxy-3-methylbutyric acid(代谢物)和肌酐(实验室指标)等特征后,模型性能大幅提升。
- EPE 预测性能:敏感性 87.5%,特异性 94.1%。
- LPE 预测性能:敏感性 66.67%,特异性 94.12%。
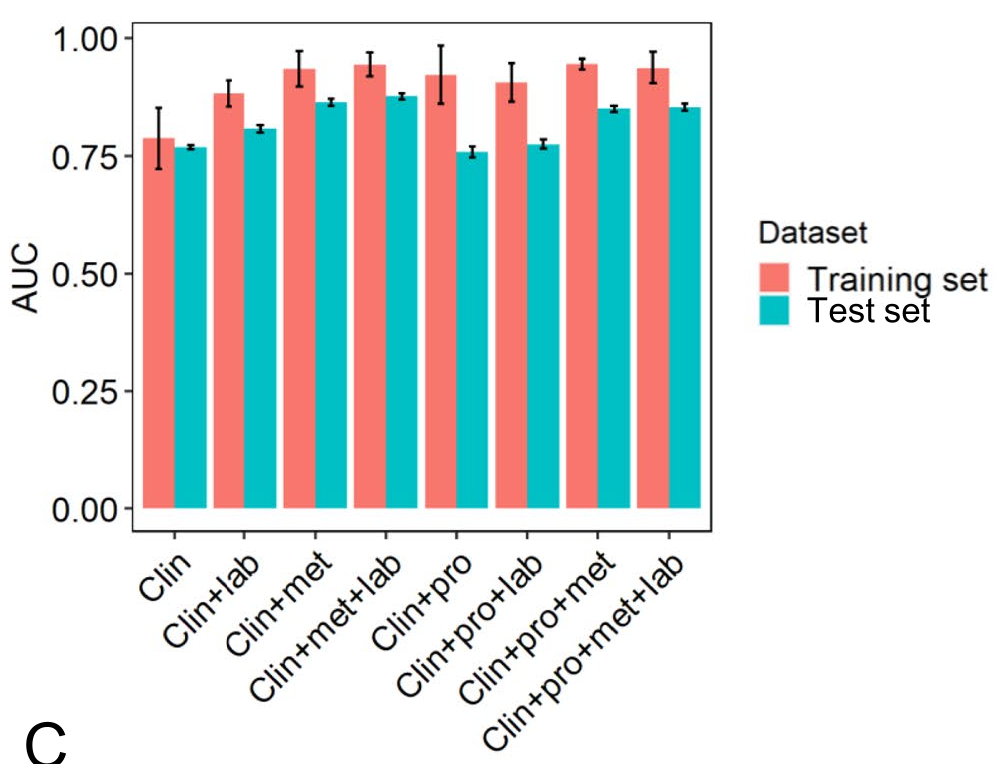 图 2:不同特征组合(组学、临床、实验指标三者结合)在测试集上的 ROC 曲线表现。
深度洞察:背后的物理直觉
通过相关性分析,研究揭示了不同表型的生物学根源:
- EPE 的驱动者:预测分值与硬脂酰肉碱(C18)及2-羟基-3-甲基丁酸呈现高度相关。这暗示了早发型患者在早期就存在严重的脂肪酸代谢紊乱,且可能伴随胎盘缺氧导致的氧化应激。
- LPE 的驱动者:载脂蛋白 E (APOE) 是关键预测指标,这验证了 LPE 更多地由母体心血管和脂质代谢压力驱动,与动脉粥样硬化的病理过程具有相似性。
总结与展望
本研究证明了集成学习在解析复杂妇产科疾病中的潜力。尽管 LC-MS/MS 目前成本较高,但在临床高危人群的精细化预测上具有不可替代的价值。未来的研究方向将集中在:
- 验证通用性:在更大规模及不同种族背景的队列中进行前瞻性验证。
- 临床落地:开发针对特定 20-30 个标志物的快速检测板卡,降低技术准入门槛。
子痫前期的预测正从“黑盒摸索”迈向“基于数据的精准预测”新时代。