
2026 见分晓:如何精准预测 AI 智能体的前沿进化
Forecasting frontier language model agent capabilities
本文提出了一套针对前沿语言模型智能体(LM Agents)能力的预测框架,重点评估了六种基于计算量(FLOPs)、发布日期、Chatbot Arena Elo 评分及 PC-1 综合指标的预测方法。研究预测,到 2026 年初,前沿智能体在 SWE-Bench Verified 软件工程基准测试中的成功率有望提升至 87%。
TL;DR
通过分析 38 个顶级大模型的演进路径,Apollo Research 的研究团队发现:我们只需通过发布日期和 Chatbot Arena Elo 这两个公开维度,就能惊人准确地预测未来智能体在软件工程(SWE-Bench)和网络安全(Cybench)中的表现。分析指出,到 2026 年初,顶尖 AI 智能体在复杂软件修复任务上的成功率将从目前的 30% 左右飙升至 80% 以上。
预测的挑战:为什么传统的 Scaling Laws 不够用?
传统的“缩放法则”通常建立在计算量(FLOPs)的基础上。然而,对于现在的闭源前沿模型(如 GPT-4, Claude 3.5),其具体的参数量和训练算力已成为商业机密。此外,传统的基准测试(如 MMLU)主要考察静态知识,而在现实世界中,模型更倾向于以**智能体(Agent)**的形式存在,涉及多步推理、工具调用和环境交互。
作者的核心 Insight 在于:与其死磕算力数据,不如寻找能力的“中间替代物”。他们发现人类的偏好(Elo 评分)和基准测试的第一个主成分(PC-1)正是这种完美的中介。
核心方法:两步预测法(Two-step Approach)
作者对比了直接预测和分步预测的六种路径。最终胜出的是一种优雅的“两步走”模型:
- 从时间跨越到能力:利用线性回归模型,将**发布日期(Release Date)**作为输入,预测模型的 Elo 分数或 PC-1 评分。
- 从能力跨越到基准:利用 Sigmoid 函数(S 曲线),将预测出的能力指标映射到具体的智能体基准得分(如 SWE-Bench)。
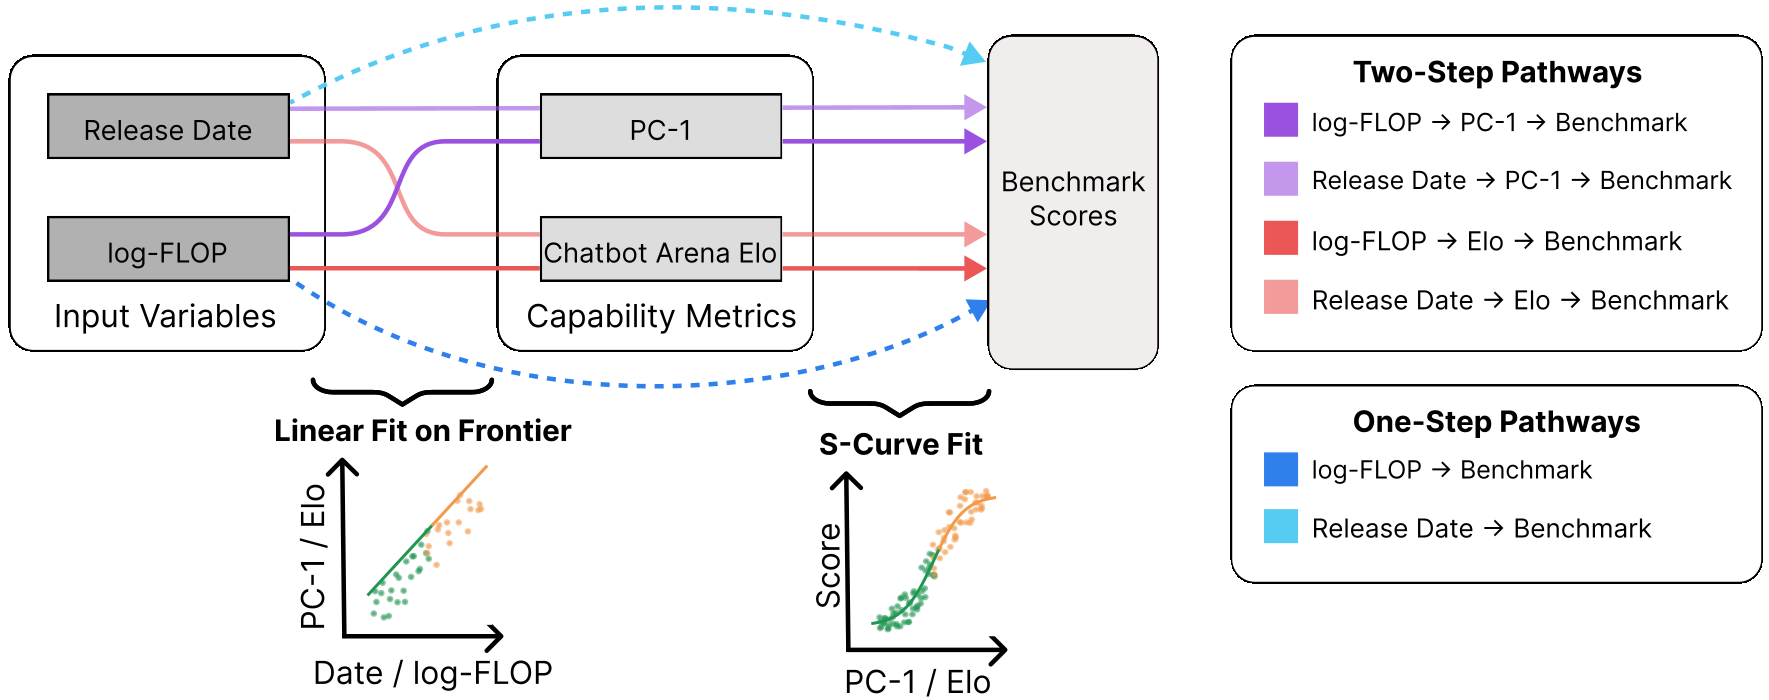
这种设计的巧妙之处在于:它承认了当模型能力达到一定水平后,在特定任务上的表现会进入快速增长期,随后随着任务接近满分而趋于饱和(即 S 曲线)。
“能力激发(Elicitation)”:智能体的隐形杠杆
该研究最重要的发现之一是:同一模型在不同“激发水平”下表现天差地别。
- 低激发(Low-Elicitation):简单的提示词和基本的 Bash/Python 工具。
- 高激发(High-Elicitation):复杂的 Scaffold 架构(如多轮重试、错误反馈、专家级 Prompt 设计)。
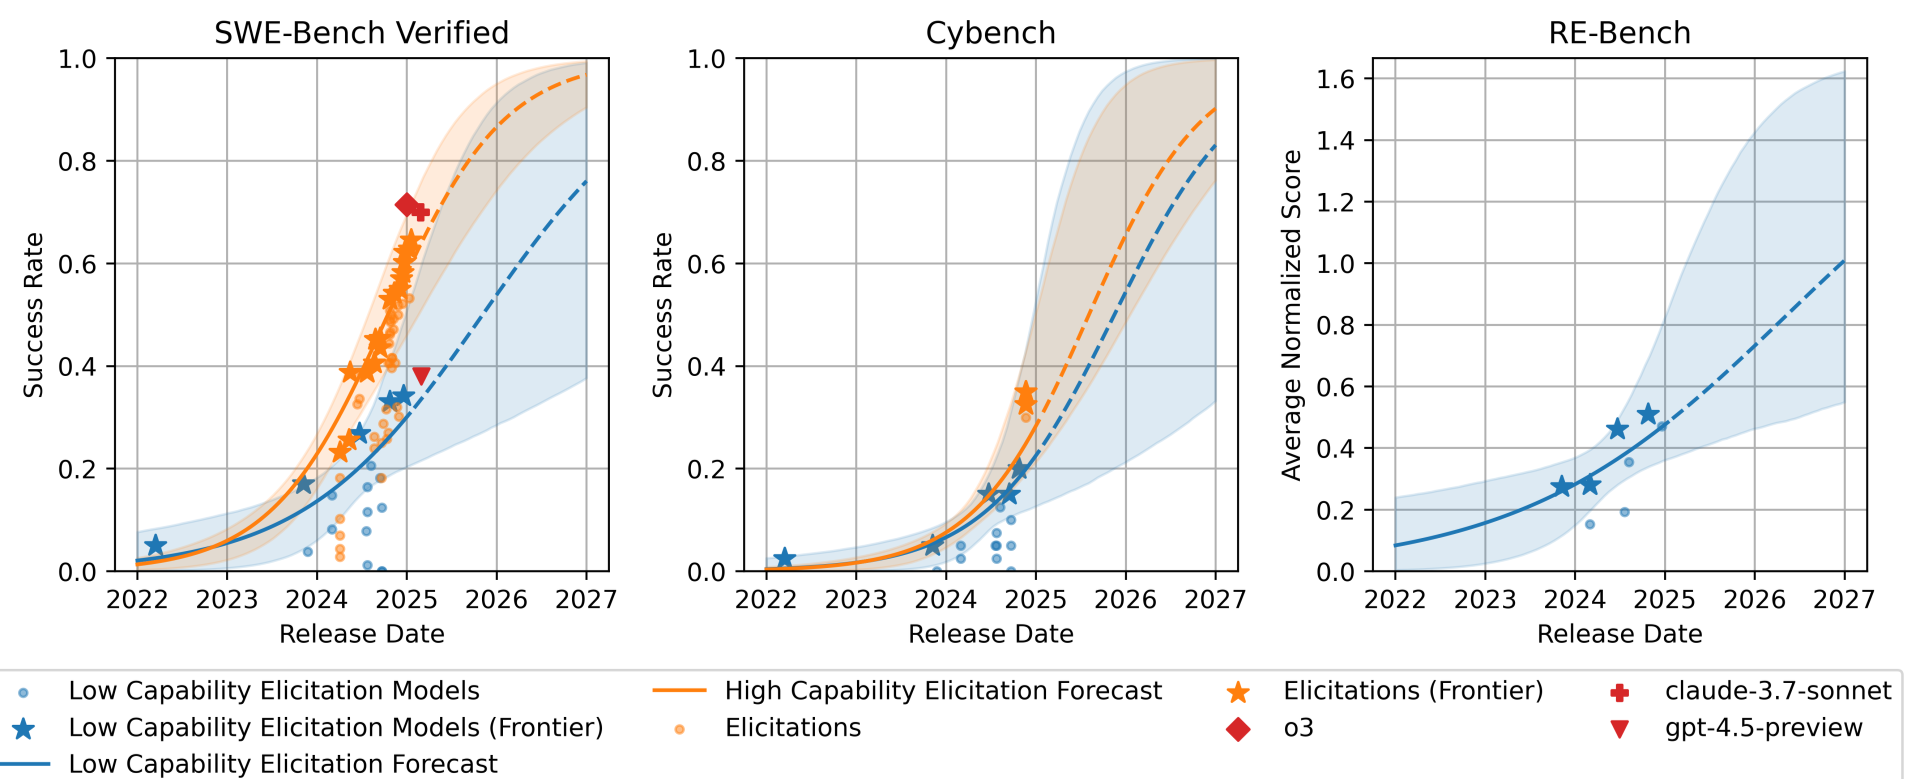
如上图所示,橙色线(高激发)与蓝色线(低激发)之间存在巨大的位移。这意味着,仅仅预测出模型底座的进步是不够的,智能体工程(Agent Engineering)的进步会将自动化进程提前数年。
实验结果与回测:数据的力量
作者在 OpenLLM Leaderboard v2 上对 38 个模型进行了回测(Backtesting)。结果证明,“发布日期 → PC-1 → 基准” 路径的预测误差(RMSE: 0.082)显著低于直接预测。
| 中间指标 | 预测精度 (RMSE) |
|---|---|
| PC-1 | 0.082 |
| Elo | 0.095 |
| 直接预测 (Date) | 0.125 |
这种线性关系的鲁棒性(R² ≥ 0.91)出乎意料,暗示了 AI 领域算法进步与算力增长的叠加效应在时间轴上表现得极其稳定。
深度洞察:我们是否低估了未来?
文章最后提出了一个警示性的观点:目前的预测可能过于保守。 原因在于,该模型主要基于“预训练缩放(Pre-training Scaling)”范式。而随着 OpenAI o1 等模型的出现,**“推理侧缩放(Inference Scaling)”**范式开启了新篇章。如果模型在运行推理时能通过更多的思考时间来换取能力,那么 2026 年的表现可能会远超 S 曲线的预测值。
总结
对于开发者和决策者来说,这篇研究提供了一个清晰的坐标系:
- 自动化临界点:2026 年初,AI 可能在软件修复领域达到 87% 的成功率。
- 不仅是模型:智能体架构(Scaffolding)的优化与模型底座的升级同等重要。
- 公开数据的价值:即便没有训练细节,通过 Chatbot Arena 的群体智慧,我们依然能洞察 AI 的进化罗盘。
未来两年的竞争,不仅是算力的竞赛,更是如何最大化“ elicited ”模型潜力的竞赛。